redis哈希槽和一致的哈希
电脑杂谈 发布时间:2020-06-19 14:09:29 来源:网络整理
随着系统流量的增加,出现了应用程序集群. 为了确保Redis在Redis中的高可用性,Redis还构建了一个集群来将数据存储在插槽中. 当要存储在Mysql中的数量达到很高的水平时,我们将对执行和表操作. 好的,在这里假设我们不知道什么是集群,什么是和表. 让我们看一个级细分的演变示例:
假设我们的系统中有一张会员表 customer_info, 我们的系统刚开始无人问津,我们在一个单个的中放这张表,所有的会员记录都插入到这个的这张表中,这没什么问题,是一个很正常且合理的操作。某段时间,我们的系统突然火爆了起来,注册会员激增,达到了千万级别并且还在快速增长,这时候所有的用户请求数据都会请求这张表,毫无疑问的压力很大,于是可能会经常发生宕机事件,给系统造成了很大影响。为了解决这件事情,我们将单张表的数据切分到多个服务器上去,每个服务器具有相应的库与表,只是表中数据不同。 这样做能够有效的缓解单机的压力和系统的性能瓶颈。
阅读此示例后,我们对水平拆分有了一个总体印象. 实际上,我们根据某些规则将大量数据存储在不同的服务器上,然后在存储时可以根据规则进行搜索. 查找之前存储的数据. 因此,我们正在讨论的一致性哈希算法实际上解决了其中的访问规则问题. 使用这种一致的哈希算法,我们可以准确地知道我们要获取的数据属于哪台机器和哪个. 内.
简单哈希是在上面水平分割的示例. 假设我们不知道将一致性哈希和聚类划分为多个时隙,那么让我们自己考虑一下. 我们可以非常容器化地想到Java中HashMap的原理. 它计算键的哈希值,然后使用此哈希值对底层数组进行模运算以获得哈希桶. 如果数据存在,则该数据必须位于哈希存储桶中,否则不存在. 同样可以想象,假设我们的customer_info可以根据用户ID分为库和表,并假设此时有三个水平库表,如下所示,我们将它们称为节点D1,节点D2,节点D0
机器 ip	      	           数据表
127.0.0.1	customer	customer_info
127.0.0.2	customer	customer_info
127.0.0.3	customer	customer_info
当有子库和子表时,用户A的记录落在D1机器上,用户B的记录落在D2机器上,用户C的机器落在D0机器上,用户A需要在哪个上存在计算过程是: 用户A的成员ID的哈希值是模3,因为只有3台机器,伪代码: A_id.hash()%/ 3,用户B和用户C等等. 如下图所示

这似乎是访问规则问题的便捷解决方案. 让我们分析一下浪潮: 假设系统中的用户数量再次激增,我们需要添加更多计算机. 此时,当我们计算哈希值时,在A_id.hash()%/ 3 = 1之前,Modulo不再是模3,而是模4,而现在是A_id.hash()%/ 4 =?该值很可能不会为1,因此会出现以下情况: 用户清楚地拥有记录但找不到该记录,这是一个大问题. 如果要解决此问题,则只能在计算机节点数更改时重新哈希数据. 价格有点高. 因此,我们需要找到一种防止这种情况发生的方法. 这种情况是由哈希算法本身的特征引起的,如果直接使用模数,这是不可避免的. 所以有一个一致的哈希值
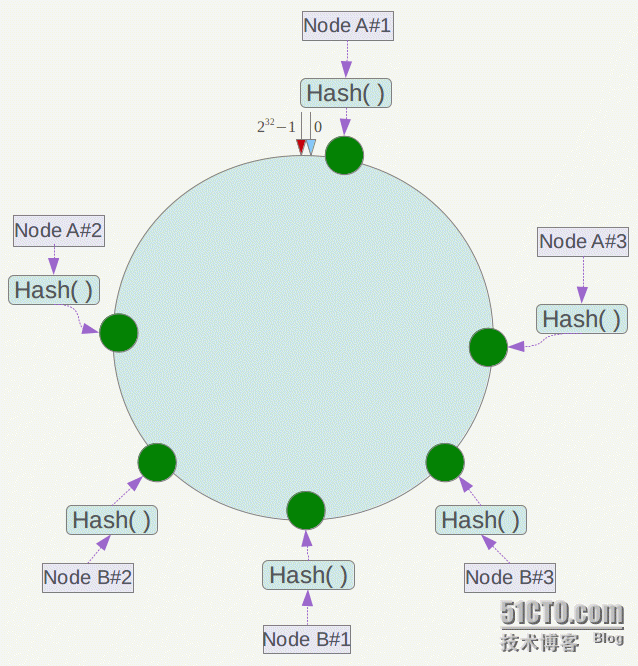
一致性哈希通过上面的示例介绍了哈希算法,并分析了其缺点. 当机器数量发生变化时,几乎所有数据都会移动(运气不好不要移动)模数前后的值相同),这非常昂贵. 此时,问题已经从如何拆分级别改变了. 添加或删除节点时,对于大多数记录,请确保仍应将最初分配的某个节点分配给该节点,以最大程度地减少数据迁移量. 这就是一致性哈希的作用. 在这里,我们不指定它是还是分布式存储节点. 2.1一致性哈希一致性哈希算法也使用模的思想,但是刚才描述的模方法是对节点数进行模,而一致性哈希算法是对2 ^ 32进行模,这是什么意思?简单来说,一致性哈希算法将整个哈希值空间组织成一个虚拟环. 例如,假设哈希函数H的值空间为0-2 ^ 32-1(即哈希值是32位的符号整形),则整个哈希环如下,从0〜2 ^ 32-1代表一个节点,该环也称为哈希环


然后,根据某些规则(例如ip地址的哈希值)对节点进行一次哈希处理,以使该节点落在哈希环上. 例如,这时我们可能会得到如下所示的铃声:

然后,您需要通过数据键找到相应的服务器并将其存储. 我们同意数据密钥的哈希值落在哈希环上的节点上. 如果它碰到了机器节点,则它落在这台机器上,否则落下. 顺时针旋转,直到碰到第一台机器. 如下图所示: A的哈希值落在D2节点的前面,向下并落在D2机器上,D的哈希值在D1节点的前面,找到D1机器,B的哈希值恰好落在D1节点,依次~~~

2.2一致哈希的分析一致哈希主要是为了解决在减少或增加机器时(主要是从以下两个方向,当节点关闭时)重新哈希大数据区域的问题: 数据记录将位于在下一个节点上. 添加新节点时,需要重新整理相关间隔中的数据记录. 2.2.1节点已关闭. 假设上图中的节点D2由于某种原因而关闭. 可以看出,仅数据A的记录需要重定位并存储在节点D1上,因为D1是D2的下一个节点. 没有其他数据受到影响. 此时,仅影响图中间隔D0-D2中的记录,也就是说,先前落在D2上的数据现在将落在D1上. 如下图所示
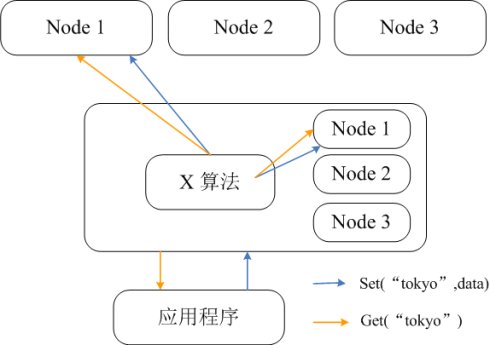

2.2.2添加节点我们假设我们需要添加一台机器redis一致性哈希算法,即添加一个节点D4,如下图所示redis一致性哈希算法,根据上面的哈希表,该节点位于D2-D1之间如果该值落在该节点的规则之内,则先前位于D2和D4之间的数据需要重新定位到新节点,并且其他位置的数据也不需要更改.

2.3一致哈希的数据偏斜问题当服务节点的数量太少时,由于节点划分不均,一致哈希算法可能会导致数据偏斜(大多数缓存对象缓存在特定服务器上). 例如,只有两台机器,而这两台机器非常接近. 然后顺时针旋转,第一个机器节点上将有大量数据,而第二个机器节点上将有少量数据. 如下图所示,D0机器携带了大部分数据


2.4虚拟节点解决数据偏斜问题为了避免数据偏斜问题,一致的Hash算法引入了虚拟节点机制,即每个机器节点将散列多次,最后每个机器节点都在散列环中它上面将有多个虚拟节点,使用此方法可以大大削弱甚至避免数据倾斜问题. 同时,数据定位算法保持不变,但是仅存在一个从虚拟节点到实际节点的映射的步骤. 例如,三个虚拟节点“ D1#1”,“ D1#2”和“ D1#3”的数据都位于D1上. . 解决了服务节点少时数据偏斜的问题. 在实际应用中,虚拟节点的数量通常设置为32个或更多,因此即使是少量的服务节点也可以实现相对统一的数据分配. 这也是Dubbo负载均衡中一致性哈希负载均衡的实现思路.

2.5一致性哈希的应用案例一致性哈希在很多地方都被使用,尤其是在中间件中. 例如,Dubbo的负载平衡还具有一致性哈希策略的策略,该策略由虚拟节点实现. . Redis集群中也使用了相关的想法,但是没有使用过,但是根据实际情况进行了改进. 当存储数据的节点被水平分割时,它甚至是不可替代的. 等等···
Redis群集不直接使用一致性哈希,而是使用哈希槽的概念. Redis不直接使用哈希算法hash(),而是使用crc16验证算法. 插槽实际上是空间单位. 实际上,哈希槽的本质与一致性哈希算法非常相似,不同之处在于哈希空间的定义. 一致性哈希的空间是一个环,节点分布基于环. 它不能很好地控制数据分发,并可能导致数据偏斜. Redis插槽空间是自定义分配的,类似于Windows磁盘分区的概念. 此分区可以自定义大小和位置. Redis集群包含16384个哈希槽,计算后每个密钥将落入特定的槽中,并且该特定的槽是用户根据自己的计算机在哪台计算机上配置的. 机器硬盘可以较小,可以分配较少的插槽,而较大的可以分配更多的插槽. 如果节点硬盘驱动器几乎相同,则它们可以均匀分布. 因此,哈希槽的概念很好地解决了一致性哈希的缺点. 此外,就容错性和可伸缩性而言,它与一致性哈希相同,后者可在不影响其他数据的情况下传输受影响的数据. 哈希槽本质上是槽的转移,负责故障节点的槽被转移到其他普通节点. 对于扩展节点也是如此,将其他节点上的插槽转移到新节点上.
需要注意的是,对于槽位的转移和分派,Redis集群是不会自动进行的,而是需要人工配置的。所以Redis集群的高可用是依赖于节点的主从复制与主从间的自动故障转移。
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-250997-1.html
-

-
周子博
默默祝福你
 分布式文件传输有什么差异?深度剖析Gartner关键素养报告
 最新版:Edge浏览器win7版本v85.0.564.51正式版
 JSP框架和JSP开发工具的优缺点比较
 updateprogress_updatepanel_net updatepanel
我想知道咱们南海造岛停止了么