分布式系统的原理和结构
电脑杂谈 发布时间:2020-06-17 23:24:51 来源:网络整理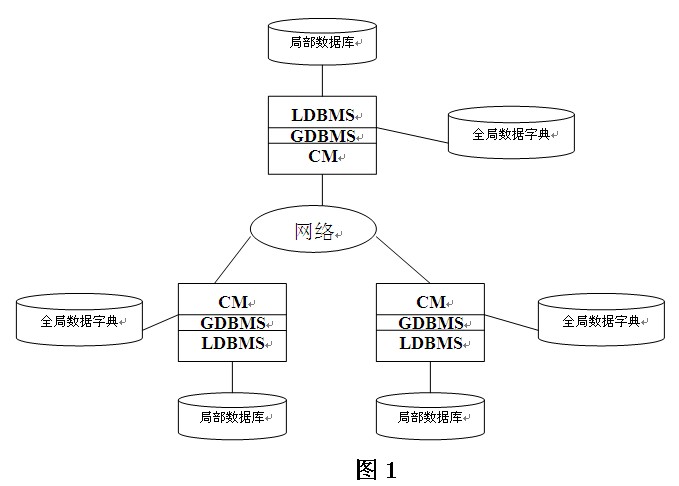
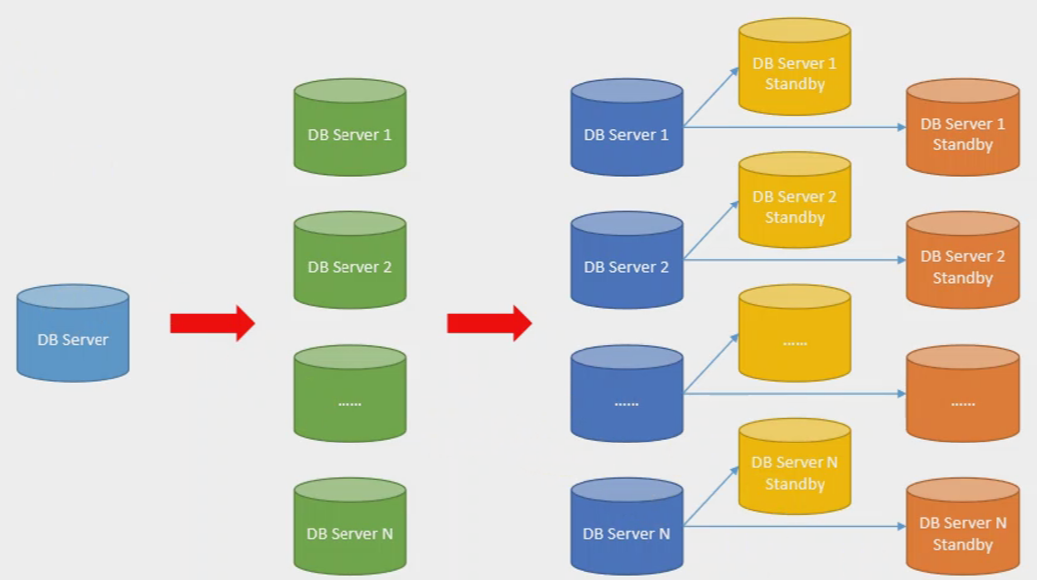
分布式系统有两种主要的方法来解决独立的低扩展能力: 数据碎片和读写分离. 数据分片(Sharding)的原理是类似于散列分区的原理,将数据水平拆分,并通过应用程序体系结构解决访问路由和数据合并的问题. Sharding体系结构的优点是群集的可伸缩性非常强,可以实现几乎线性的扩展,并且整个群集的可用性也很高,某些节点发生故障,不会影响其他节点提供服务. 分片原理简单,易于实现,是可伸缩性的很好解决方案. 但是,分片对相应的场景有很高的要求,因为一旦使用了数据分片架构,如果您需要在不同节点之间加入或执行统计类型的操作,它将变得非常困难,应尽可能避免. 因此,分片架构将失去关系的某些特性,例如联接,从而将退化为键值存储类型的存储. 因此,并非所有应用程序都适合分片. 这可能导致应用程序体系结构复杂或限制系统功能. 这也是它的缺点.
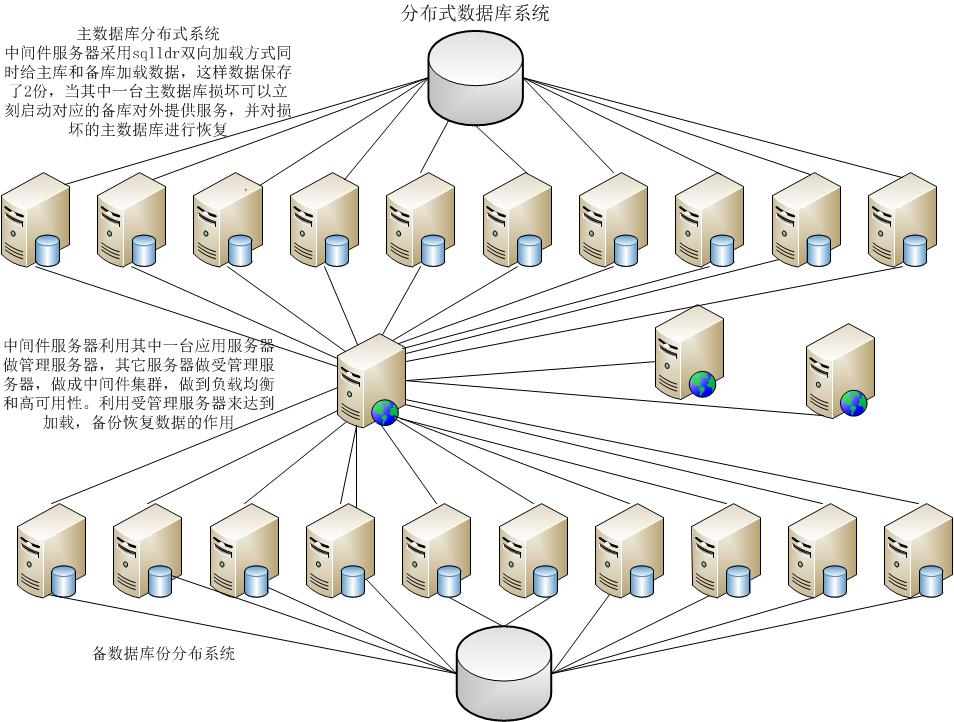
读写分离体系结构利用的复制技术在不同处理节点上分布读写,从而达到提高可用性和可伸缩性的目的. 最常见的方法是使用复制技术,主执行写操作,将数据更改复制到多个从分布式系统原理与应用 pdf,并执行读操作. 此体系结构适用于读取密集型应用程序. 通过增加从的数量,读取性能可以线性提高. 为了避免Master DB的单点故障,群集通常使用两个Master DB作为双机热备份,因此整个群集的读写可用性非常高. 读写分离体系结构的缺点是,无论是主机还是从机,每个节点都必须保存完整的数据. 如果数据量很大,则群集的可伸缩性仍然受到单个节点的存储容量的限制. 对于写密集型应用程序,读写分离架构不适合.
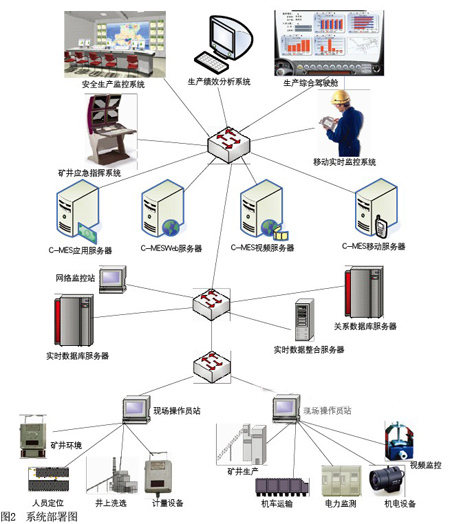

读写分离体系结构被广泛使用. 许多网站使用cache + DB读写分离架构,该架构通过缓存层进行大量读取访问. Memcached是一种广泛使用的Key-Value缓存,它不具有持久性存储的功能,因此通常与形成单独的读写架构,并且具有数据持久性存储的功能,而Memcached用于进行大量并发访问. 通常的方法是: 应用程序的读取请求将首先访问Memcached,如果命中,它将返回,如果未命中,它将进入进行读取,并将数据加载到Memcached中. 对于添加,修改和删除操作,通常采用延迟加载策略,即仅在添加时写入,并且不会立即更新Memcached,而是在再次读取,修改和删除时将其加载到Memcached中. 操作还用于更新,然后将Memcached中的数据标记为无效,并在加载之前等待下一次读取. Memcached支持数据分区,并使用哈希算法将数据分发到不同的服务器,以形成分布式缓存集群.

当前大多数分布式产品都用于DSS类型的应用程序,因为与OLTP应用程序相比,DSS应用程序更易于实现分布式扩展,例如PetaBase,它是解决可用性和可伸缩性问题的一个很好的解决方案,并提供非常强大的并行计算功能. 从技术信息的角度来看分布式系统原理与应用 pdf,它具有几个特点:
1. 物理服务器采用无共享架构,将虚拟服务器划分为以CPU核心为单元的虚拟节点,采用分片技术自动将数据分发到不同的虚拟节点,以最大程度地利用机器计算资源.
2. 使用内存中数据访问技术,类似于内存中(In-memory database),不同于传统(基于磁盘的),消除了传统内存管理的开销,并且响应速度非常快; <
3. 每个虚拟节点上的操作都是自主的,使用队列技术将并发访问转换为串行访问,从而消除了传统串行控制(如Latch和Lock)的开销;
4. 同步写入数据的多个副本,没有单点故障,并且消除了需要记录重做日志的传统的开销.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-249067-1.html
-

-
孙红雷
我记得那时俺年轻
-
-
贾怀明
-
秦小迪
您好
-
 中国高性能计算机TOP100排名呈锕獾诎舜味峁?太平言网
 document.write( ); 四川乐山女交警谭霞10年坚守春节一线保路畅(图)
 在Ubuntu下设置您自己的“超级计算机集群”
 OGNL表达式的基本语法和用法
当然如果你还给孩子还房贷什么的就没办法了