使用C语言的通用函数调用
电脑杂谈 发布时间:2020-06-15 09:03:05 来源:网络整理
memset: 功能是将给定值填充到内存块中. 这是清除大型结构或阵列的最快方法
char * fgets(char * buf,int bufsize,FILE * stream);
* buf: 字符指针,指向用于存储结果数据的地址.
bufsize: 整数数据,指示存储数据的大小.
* stream: 文件结构指针,要读取的文件流.
成功,返回第一个参数buf;当读取字符时遇到文件结尾时,将设置eof指示器. 如果在读取任何字符之前遇到这种情况,则buf保留原始内容,返回NULL;否则返回NULL. 如果发生读取错误,则设置错误指示符,并返回NULL,则buf的值可能会更改.
chdir是C语言的系统调用函数(与cd相同),用于更改当前工作目录,其参数是Path目标目录,可以是绝对目录或相对目录.
exec函数
2012年4月10日09:39:27
阅读次数: 19800
exec将执行程序的映像完全替换为调用程序的映像. Fork创建一个新的过程,并生成一个新的PID. Exec启动一个新程序来替换原始过程. 因此,exec所执行的新进程的PID不会改变,就像调用exec函数的进程一样.
让我们看一下exec函数家族:
#include
int execl(const char * path,const char * arg,...);
int execlp(const char * file,const char * arg,...);
int execle(const char * path,const char * arg,...,char * const envp []);
int execv(const char * path,char * const argv []);
int execvp(const char * file,char * const argv []);
int execve(const char * path,char * const argv [],char * const envp []);
exec函数系列加载并运行程序路径名,并将参数arg0(arg1,arg2,argv [],envp [])传递给子例程,并在出错时返回-1. 在exec函数系列中,将后缀l,v,p和e添加到exec后,指定的函数将具有一定的操作能力,并带有后缀:
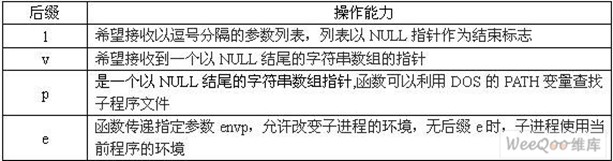
execl(“ / bin / ls”,“ ls”,“-a”,NULL)
execv(“ / bin / ls”,arg)
execlp(“ ls”c语言函数,“ ls”,“-a”,NULL)
execvp(“ ls”,arg)
execle(“ / bin / ls”,“ ls”,“-a”,NULL,envp)
execve(“ / bin / ls”,arg,envp)
assert()使用
assert()是调试程序时经常使用的宏. 程序运行时,将使用括号对表达式进行求值. 如果表达式为FALSE(0),则程序将报告错误并终止执行. 如果表达式不为0,则继续执行以下语句,其作用是终止程序,以免造成严重的后果,而且还易于发现错误.
在Linux下,使用open打开文件后,将返回文件描述符. 文件描述符将指向文件表,文件表中的节点指针将指向节点表. 看下面的图片:
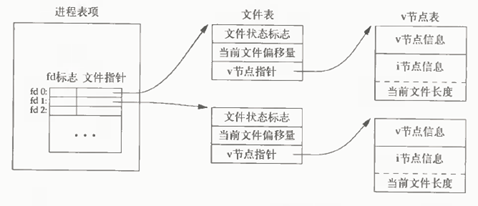
打开文件的内核数据结构
dup和dup2函数均可用于复制打开的文件描述符. 成功复制后,它们与复制源共享同一文件表. 参见下表
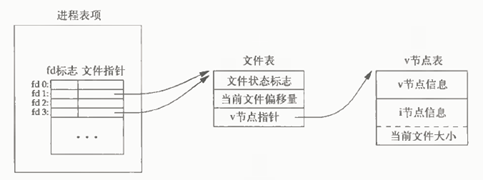
执行dup之后的内核数据结构
重复功能
fd1 = dup(fd)
fd1和fd共享一个文件表(对df执行的操作,fd1也将具有相应的操作,fd和fd1同步)
具体说明:
#inclue
#include
#include
#include
#include
int main()
{
char buf [6] = {0};
char buf1 [6] = {0};
int fd = open(“ file”,O_RDWR | O_CREAT,0644);
if(fd <0)
printf(“打开错误”);
printf(“ fd: %d \ n”,fd);
//输出fd = 3;
write(fd,“ hello,world”,12);
lseek(fd,0,SEEK_SET); //将文件偏移量设置为0,即从第一个字符(从h开始)开始读取
read(fd,buf,5);
printf(“ fd: %s”,buf); //输出问候
intfd1 = dup(fd);
read(fd1,buf1,5); //先前的操作是读取和写入fd,而对fd1则不做任何操作. 但是,如果输出了数据,则在这里读取fd1. 说明fd和fd1是同步的(fd所做的等同于fd1所做的事情)

printf(“ fd1: %s \ n”,buf1); //输出,麻烦
//因为输出是fd的内容,所以它表明fd和fd1共享一个文件表,并且读取的结果是worl而不是hello(我们将从上面的第一个字符开始的偏移量开始,然后输出hello之后也就是说,fd的偏移量从头开始有5个字符. 当我们再次读取fd时,它从第6个字符开始. 显然,第6个字符是逗号. 然后读取5,即worl),表明偏移量是一致的. (实际上,无需编写偏移量,因为共享文件表意味着文件偏移量也被共享)
printf(“ fd1: %d \ n”,fd1); //输出fd1 = 4
// fd = 3不等于fd1表示未共享同一文件描述符. 这也是dup和dup2之间的区别.
close(fd);
close(fd1);
返回0;
}
(2)dup2函数
fd2 = dup2(fd,fd1);
fd2的fd1(第二个参数)描述符,fd(第一个参数)文件(与fd共享文件表,当然也共享文件偏移量)
强调了前几个参数,因为如果您编写fd2 = dup2(fd1,fd);然后fd2 = fd和fd1共享相同的文件表.
#inclue
#include
#include
#include
#include
int main()
{
int fd = open(“ file”,O_RDWR | O_CREAT,0644);
if(fd <0)
printf(“打开错误”);
printf(“ fd: %d \ n”,fd);
//输出fd = 3;
int fd1 = open(“ text” ,, O_RDWR | O_CREAT,0644);
if(fd1 <0)
printf(“打开错误”);
printf(“ fd1: %d \ n”,fd1);
//输出fd1 = 4;
int fd2 = dup2(fd,fd1);
printf(“ fd2: %d \ n”,fd2);
//输出fd2 = 4;
// fd1 = fd2 = 4;这意味着fd2使用fd1的文件描述符.
char buf [12] =“ hello,world”;
write(fd,buf,12); //我们写了fd,但没有写fd2
read(fd2,buf,12); //但是,当我们读取fd2时,如果未写入,该如何读出
printf(“ fd2: %s \ n”,buf); //事实被读出
///输出fd2: 您好,世界//描述fd和fd2共享一个文件表.
lseek(fd,5,SEEK_SET); //该距离开始偏移5位,表示下一个读数是从6开始. 请注意,我们要偏移fd,而不是fd2.
read(fd2,buf,5); //但是如果读取fd2的结果从第6个字符开始
buf [5] = 0; //如果您不写这句话,则会根据12个字符输出输出buf. 因为在定义buf时,可以在数组中放置12个字符.
printf(“ fd2: %s \ n”,buf); //输出fd2: ,worl //描述fd2和fd之间共享文件的偏移量.
close(fd);
close(fd2);
返回0;
}
dup和dup2之间的区别
dup: fd1 = dup(fd);目标描述符使用fd的文件表
dup2: fd2 = dup2(fd1,fd)目标描述符使用fd1描述符,并使用fd文件表
管道是一种在两个进程之间连接标准输入和标准输出的机制,从而提供了一种在多个进程之间进行通信的方法. 当进程创建管道时,需要提供两个File描述符来操作管道. 其中一个写入管道,另一个读取管道. 管道的读取和写入与常规IO系统功能一致. 使用write()函数写入数据,并使用read()读取数据.
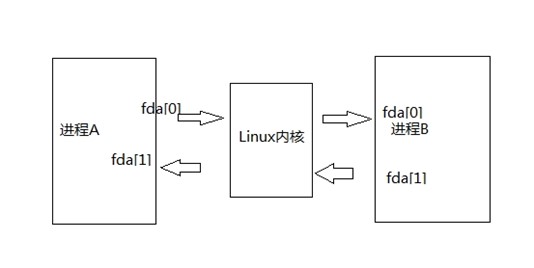
#include
int管道(int filedes [2])
返回值: 成功,返回0,否则返回-1. 参数数组包含管道使用的两个文件的描述符. fd [0]: 读取管道,fd [1]写入管道.
必须在fork()中调用pipe(),否则子进程将不会继承文件描述符. 如果两个进程不共享祖先进程,则不能使用管道. 但是可以使用命名管道.
1 #include
2 #include
3 #include
4 #include

5 #include
6个int main(void){
7个int结果= -1;
8 int fd [2],nbytes;
9 pid_t pid;
10个字符字符串[] =“地狱,我的烟斗!”;
11个字符的readbuffer [100];
12 int * write_fd =&fd [1];
13 int * read_fd =&fd [0];
14 result = pipe(fd);;
15 if(-1 == result){
16 printf(“创建管道失败\ n”);
17 return -1;
18}
19 pid = fork();
20 if(-1 == pid){
21 printf(“派生失败\ n”);
22 return -1;
23}
24 if(0 == pid){
25 close(* read_fd);
26 result = write(* write_fd,string,strlen(string));
27返回0;
28}其他{
29 close(* write_fd);
30 nbytes = read(* read_fd,readbuffer,sizeof(readbuffer));
31 printf(“父级接收%d字节数据: %s \ n”,nbytes,readbuffer);
32}
33返回0;
34}
父级收到20个字节的数据: 地狱世界,我的管道!
#include
#include
#include
#define COUNT(10)
int main(int argc,char * argv [])
{
int pipefd [2];
int read_count = 0;
char buf [COUNT] = {'0','1','2','3','4','5','6','7','8','9'} ;;
if(pipe(pipefd)== -1){
perror(“呼叫管道失败\ n”);
退出(EXIT_FAILURE);
}
printf(“将%d个字符写入pipe1 \ n”,计数);
write(pipefd [1],buf,COUNT);
while(read(pipefd [0],&buf,1)> 0)
{
printf(“从pipe0 \ n中读取%c”,buf [0]);
read_count ++;
如果(read_count == COUNT)
{
printf(“总读取%d个字符\ n”,read_count);
休息;
}
}
close(pipefd [0]);
close(pipefd [1]);
}

编译和执行结果:
[root @ alexs-centos core_dump]#gcc pipe.c
[root @ alexs-centos core_dump]#./a.out
将10个字符写入pipe1
从pipe0读取0
从pipe0读取1
从pipe0读取2
从pipe0读取3
从pipe0读取4
从pipe0读取5
从pipe0读取6
从pipe0读取7
从pipe0读取8
从pipe0读取9
总共读取10个字符
从外壳运行一个进程,默认情况下将有3个文件描述符(0、1、2),0与该进程的标准输入相关联,1与该进程的标准输出相关联,2与该进程的标准输出相关联标准错误输出相关. 可以通过/ proc / process ID / fd目录查看进程当前具有的打开文件描述符
C语言提供了几种标准的库函数,可以将任何类型的数字(整数,长整数,浮点数等)转换为字符串.
1.int/浮动到字符串/数组:
C语言提供了几种标准库函数,这些函数可以将任何类型(整数,长整数,浮点数等)的数字转换为字符串. 下面列出了每个功能的方法和说明.
●itoa(): 将整数值转换为字符串.
●ltoa(): 将长整数值转换为字符串.
●ultoa(): 将无符号的长整数值转换为字符串.
●gcvt(): 将浮点数转换为字符串,四舍五入.
●ecvt(): 将双精度浮点值转换为字符串. 小数点不包含在转换结果中.
●fcvt(): 指定的位数是转换精度,其余与ecvt()相同.
此外,您还可以使用sprintf系列函数将数字转换为字符串,这比itoa()系列函数要慢
2. 字符串/数组到int / float
C / C ++语言提供了几种标准库函数,可以将字符串转换为任何类型(整数,长整数,浮点数等).
●atof(): 将字符串转换为双精度浮点值.
●atoi(): 将字符串转换为整数值.
●atol(): 将字符串转换为长整数值.
●strtod(): 将字符串转换为双精度浮点值,并报告所有无法转换的剩余数字.
●strtol(): 将字符串转换为长整数值,并报告所有无法转换的剩余数字.
●strtoul(): 将字符串转换为无符号的长整数值,并报告所有无法转换的剩余数字.
以下是使用itoa()函数将整数转换为字符串的示例:
#include
#include
void main(void)
{
int num = 100;
char str [25];
itoa(num,str,10);
printf(“数字'num'为%d,字符串'str'为%s. \ n”,
num,str);
}
The
itoa()函数具有三个参数: 第一个参数是要转换的数字,第二个参数是要写入转换结果的目标字符串,第三个参数是用于传输数字的基数. 在上面的示例中,转换基数为10. 10: 十进制; 2: 二进制...
C语言pthread_create具有多个参数和pthread_join的传递函数
pthread_create是用于在类似Unix的操作系统(Unix,Linux,Mac OS X等)中创建线程的功能. 头文件在pthread.h中. 函数声明如下:
int pthread_create(pthread_t * tidp,const pthread_attr_t * attr,
(void *)(* start_rtn)(void *),void * arg);
//返回值: 成功则返回0,否则返回错误号
参数
第一个参数是指向线程标识符的指针.
第二个参数用于设置线程属性.
第三个参数是线程运行函数的起始地址.
最后一个参数是运行函数的参数.
从第三个函数可以看到,传入函数的参数必须为void *类型. 但是,在许多情况下,需要线程处理的函数是多参数的. 通过将参数封装到结构中,可以传递具有多个参数的函数.
struct fun_para

{
var para1; //参数1
var para2; //参数2
.......
}
将此结构指针作为void *形式参数的实际参数传递
struct fun_para para;
pthread_create(&ntid,NULL,thr_fn,&para);
然后可以通过以下方式程的调用函数thr_fn中使用通过para传递的参数.
无效* thr_fn(无效* arg)
{
fun_para * para;
para =(fun_para *)arg;
para-> para1; //参数1
para-> para2; //参数2
......
// pthread_exit(0);
返回((void *)0);
}

附加标记: 如果代码中没有pthread_join,则主线程将快速结束,并且整个过程将结束,因此创建的线程将结束而没有机会开始执行. 加入pthread_join后,主线程将一直等待,直到等待线程完成,以便创建的线程有机会执行.
函数定义:
int pthread_join(pthread_t thread,void ** retval);
描述: pthread_join()函数以阻塞方式等待线程指定的线程结束. 函数返回时,将回收等待线程的资源. 如果线程已结束,该函数将立即返回. 并且线程指定的线程必须是可连接的.
参数: thread: 线程标识符,即线程ID,用于标识唯一线程. retval: 用户定义的指针,用于存储等待线程的返回值.
返回值: 0表示成功. 如果失败,则返回错误号.
tmp1 = pthread_join(tid,&retval);
如果(tmp1!= 0)
{
printf(“无法与线程1 \ n”连接);
}
多线程可变原子操作__sync_fetch_and_add等.
我们当然知道count ++不是原子的. 自我添加操作实质上分为三个步骤:
1从缓存中获取寄存器
2将1加到寄存器
3存储在缓存中.
由于时序因素,多个线程对同一个全局变量进行操作,这可能会导致问题. 这也是并发编程的困难. 在当前的多核条件下,这种困境将变得越来越明显.
处理此问题的最简单方法是锁定保护,这也是我最初的解决方案. 看下面的代码:
pthread_mutex_t count_lock = PTHREAD_MUTEX_INITIALIZER;
pthread_mutex_lock(&count_lock);
global_int ++;
pthread_mutex_unlock(&count_lock);
后来在Internet上,我找到了__sync_fetch_and_add系列命令,并找到了该系列命令中的最佳文章. 英语水平好的学生可以直接进入原文. 多线程简单数据类型访问和原子变量
__ sync_fetch_and_add系列共有十二个功能,包括原子运算功能,用于诸如加/减/和/或/异或等值的功能. 以count = 4为例,调用__sync_fetch_and_add(&count,1),此后,返回值为4,然后计数变为5.
有__sync_fetch_and_add,自然也有__sync_add_and_fetch. 哈哈的意思很清楚. 首先添加并返回. 它们的关系与i ++和++ i相同. 谭浩强很清楚,他的老人已经收到了保护费.
有了此婴儿功能,我们有了新的解决方案. 对于全局变量的多线程自添加,我们不再需要担心线程锁定. 以下代码行与上面受pthread_mutex保护的代码行具有相同的效果,并且也是线程安全的.
__ sync_fetch_and_add(&global_int,1);
以下是这些功能的全貌. 每个人都可以通过查看其功能来了解这些功能.
使用gcc进行编译时,添加选项-march = i686
类型__sync_fetch_and_add(类型* ptr,类型值);
类型__sync_fetch_and_sub(类型* ptr,类型值);
类型__sync_fetch_and_or(类型* ptr,类型值);
类型__sync_fetch_and_and(类型* ptr,类型值);
类型__sync_fetch_and_xor(类型* ptr,类型值);
类型__sync_fetch_and_nand(类型* ptr,类型值);
类型__sync_add_and_fetch(类型* ptr,类型值);
类型__sync_sub_and_fetch(类型* ptr,类型值);
类型__sync_or_and_fetch(类型* ptr,类型值);
类型__sync_and_and_fetch(类型* ptr,类型值);
类型__sync_xor_and_fetch(类型* ptr,类型值);
类型__sync_nand_and_fetch(类型* ptrc语言函数,类型值);
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-246008-1.html
-

-
卫悼公
写几亿个字儿也是毫无价值的
 360浏览器批量下载并保存图片
 网络嗅探器(视频侦探)正式版
 W764位旗舰版和纯版本系统下载
 图书销售系统参考
呵呵美国是不是每个洲一艘