了解数据清理的步骤和方法
电脑杂谈 发布时间:2020-06-13 23:10:09 来源:网络整理
数据清理是整个数据分析过程中必不可少的环节. 结果的质量与模型效果和最终结论直接相关. 在实际操作中,数据清理通常占分析过程的50%-80%. 一些国外学术机构将研究如何进行数据清理,并且有很多相关书籍.
(Meiya搜索数据清除的结果,您可以看到这本书非常昂贵)
在本文中,我将尝试在很浅的层次上整理数据清理过程,以供您参考.
与往常一样,第一张照片:

预处理阶段主要做两件事:
一种是将数据导入处理工具. 一般来说,建议使用并通过运行一台计算机来构建MySQL环境. 如果数据量很大(超过1000万个级别),则可以使用文本文件存储+ Python操作.

第二个是查看数据. 这里有两个部分: 一个是查看元数据,包括字段解释,数据源,代码表等,所有这些都描述了数据;其次是提取部分数据,使用手动查看方法,并对数据本身有直观的了解,我最初发现了一些问题并为后续处理做准备.
缺少值是最常见的数据问题. 有许多方法可以处理缺失的值. 我建议按照以下四个步骤操作:
1. 确定缺失值的范围: 计算每个字段的缺失值的比例,然后根据缺失值的比例和字段的重要性制定策略,可以用下图表示:
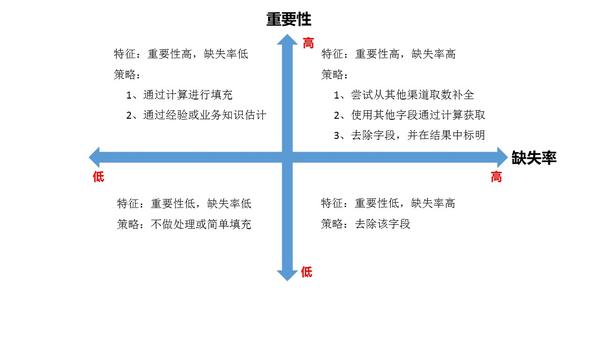
2. 删除不必要的字段: 此步骤非常简单,只需直接将其删除...但是强烈建议备份每个清洗步骤,或在小规模数据上成功测试全部数据量,否则删除错误I稍后会后悔的(更多的单词,编写SQL时,删除必须与位置匹配!).
3. 填写缺少的内容: 可以填写一些缺少的值,有三种方法:
前两种方法更容易理解. 关于第三种方法,让我们以最简单的示例为例: 年龄字段丢失,但是后六位的ID号码被阻止,所以...
4. 重新获取: 如果某些指标非常重要且丢失率很高,则需要与数据获取人员或业务人员一起了解是否还有其他渠道来获取相关数据.

以上内容只是对清除缺失值的步骤进行了分类,但是其中一些比我说的要复杂得多,例如填写缺失值. 许多有关统计方法或统计工具的书都会提到相关方法,有兴趣的人可以深入学习.
如果数据来自系统日志,则格式和内容通常与元数据的描述一致. 如果数据是手动收集或由用户填写的,则格式和内容很有可能会出现问题. 简而言之,存在以下几种格式内容问题:
1. 时间,日期,数值和全角字符等显示格式不一致
这类问题通常与输入端子有关. 集成多源数据时也可能会遇到此问题,并且可以将其处理为一致的格式.
2. 内容中不应包含某些字符
某些内容可能仅包含一部分字符,例如,ID号是数字+字母,中文名称是中文字符(赵C仍然是少数). 最典型的是头部,尾部和中间的空格,而且名称中可能存在数字符号,ID号中出现汉字等问题. 在这种情况下,必须使用验证和半手动方法来发现可能的问题并删除不必要的字符.
3. 内容与该字段的内容不符
姓名中写有性别,号上写有手机号码,等等,这是一个问题. 但是,此问题的特殊性在于无法简单地通过删除来解决,因为原因可能是人工填充错误,前端可能没有验证或导入时某些或所有列未对齐数据. 因此数据清洗,有必要详细确定问题类型.

格式内容问题是一个更详细的问题,但是此坑中植入了许多分析错误,例如跨表关联或VLOOKUP失败(多个空格导致该工具认为“ Chen Danyi”和“ Chen Danyi”并不孤单),统计信息不完整(当然,在数字上加字母后结果会出现问题),模型输出失败或效果不佳(数据错误,日期和年龄混合,所以...). 因此,请注意清洁工作的这一部分,尤其是在手动收集处理的数据时,或者在您确定产品前端验证设计的质量不好时.
这部分工作是删除一些可以使用简单逻辑推理直接发现问题的数据,以防止分析结果出现偏差. 它主要包括以下步骤:
1,重复数据删除
一些分析师喜欢将重播放在第一步,但是我强烈建议在清除格式内容之后再放重播,原因已经说过了(多个空格使工具认为“ Chen Danyi”和“ Chen Danyi” “不是一个人,重复失败). 而且,并非所有重复都可以如此简单地删除...
我曾经做过与电话销售有关的数据分析,发现销售人员没有用任何东西来接订单……例如,一家名为“ ABC Butler Co.,Ltd.”的公司在销售A手中,然后是销售B抓住该客户数据清洗,然后在系统中输入“ ABC官方家庭”. 您看,如果不仔细看就看不到两者之间的差异,即使您可以看到,也可以保证不存在“ ABC Official Home Co.,Ltd.”之类的东西. 这次,您必须拥抱RD大腿,让别人为您编写一个模糊匹配算法,或者用肉眼看到它.
这不是最残酷的,请参见下图:
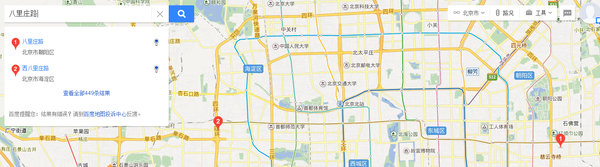
在您的系统中,两条道路都很有可能称为八里庄路. 您敢直接重复吗? (附上繁琐的提示: 八里庄路的两个门牌号范围不同)

当然,如果没有手动输入数据,则只需删除重复项即可.
2. 删除不合理的值
可以用一句话弄清楚: 一个人盲目填写表格,年龄200岁,年收入100万元(估计他们没有看到“万”这个词). 此类型将被删除或视为缺失值. 如何找到这个值?提示: 可用但不限于箱形图.
3. 纠正矛盾的内容
可以互相验证某些字段,例如: ID号为1101031980XXXXXXXX,年龄为18岁. 尽管我们了解人们永远都在18岁这一想法,但我们知道实际年龄可以为用户提供更好的服务(还有废话……). 此时,有必要根据该字段的数据源确定哪个字段提供了更可靠的信息,并删除或重建不可靠的字段.
除了上面列出的案例外,还有许多未列出的案例. 逻辑错误应在实践中处理. 另外,可以在后续的数据分析建模过程中重复此步骤,因为即使问题非常简单,也无法一次发现所有问题. 我们所能做的就是使用工具和方法来最大程度地减少出现问题的可能性. 性,使分析过程更高效.
此步骤非常简单: 删除不必要的字段.
但是实际上,存在很多问题,例如:
我在前两种情况下提出的建议是: 如果数据量足够大而无法删除该字段而不删除该字段,则不应删除无法删除的字段. 在第三种情况下,请备份您的数据...
如果您的数据有多个来源,则必须验证关联. 例如,如果您有汽车的离线购买信息和电话客户服务调查表信息,则这两个名称和移动电话号码相关. 然后查看同一人下线注册的车辆信息和问卷询问的车辆信息. 如果不是同一辆车(不要笑(如果业务流程设计不好,很可能会出现这种问题!),那么您需要调整或删除数据.
严格来说,这已离开了数据清理的范围,并且模型中应涉及相关的数据更改. 但是我仍然想提醒您,来自多个来源的数据集成是一项非常复杂的工作. 您必须注意数据之间的相关性. 在分析过程中尽量不要互相冲突,但是您不会注意到它.
以上是对数据清理过程的简单回顾. 由于能力的限制,不可避免会损失10,000. 请给我您的反馈,谢谢.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-244362-1.html
-
 中岛爱
-
马志元
而且
-
 windows 内核编程黑客..黑客.微信:
 HBV DNA定量检测的正常范围是什么
 部: 要花三年时间才能实现国家户口和公民编号的唯一性
 原版镜像和Ghost差别很大吗?Ghost系统与原版系统的区别