数据清理
电脑杂谈 发布时间:2020-06-13 23:08:34 来源:网络整理
学习笔记,请参见原始作者
数据清理是数据分析的第一步. 清理数据或转换格式通常需要很多时间.
首先,数据预处理
1. 部署环境,导入分析包和数据
import pandas as pd
import numpy as np
DataDF=pd.read_csv('C:/Users/jzgao/Desktop/ecommerce-data/data.csv',encoding = "ISO-8859-1",dtype = str)
# dtype = str,最好读取的时候都以字符串的形式读入,不然可能会使数据失真
# 比如一个0010008的编号可能会读取成10008
# encoding = "ISO-8859-1" -- 用什么解码,一般会默认系统的编码,如果是中文就用 "utf-8"
2. 尝试了解此数据集
我们可以通过询问数据集来判断该数据是否足以回答我们的问题. 数据是否干净无需进一步处理. 问题包括但不限于:
数据集中有多少数据?
包括哪些字段?字段格式是什么?
这些字段代表什么?
字段之间的关系是什么?可以使用什么分析?还是可以满足分析要求?
是否有任何缺失的价值;如果是这样,有多少个缺失值?
现有数据中是否有任何脏数据?特别是,您需要注意手动输入的数据. 在很多情况下,名称写错,输入更多空格等.
3. 让我们结合代码来看一下数据
# 1.从宏观一点的角度去看数据:查看dataframe的信息
DataDF.info()
![DataDF.info()]()
```python#2.检查丢失的数据#如果要检查每列中丢失的数据数量,使用以下代码是最快的方法. #使您可以更好地了解哪些列缺少更多数据,从而确定如何执行下一个数据清除和分析操作. DataDF.isnull(). sum(). sort_values(ascending = False)`
![检查丢失的数据]()
`python#3.提取部分数据,直观地理解数据的含义,并尽可能多地发现一些问题DataDF.head()`
! [提取一些数据]()
您可以看到:
1)出现InvoiceDate的特定时间,您可以将其删除
2)描述手动填充数据的可能性很大,并且通常存在更多的格式问题.

猜测标点符号/标点符号不一致以及其他不一致之处会存在问题,因此将对这些手动填充的数据进行进一步的重复数据删除以进行研究
# 查看这个商品名称的去重项
DataDF['Description'].unique()
![查看重复数据删除的项目]()
```python#设置所有内容的输出#阈值是设置了多少个项目,将被省略#(例如threshold = 10表示将省略10个以上)np.set_printoptions(threshold = np . inf)DataDF ['Description']. unique()```
![所有内容]()
我发现很多空格有问题
在数据预处理的第一步之后,整理数据集并要解决以下问题:
1)调整数据类型: 由于开始使用str进行导入,因此计划在以后更改格式,并且需要调整数据类型.
2)修改列名: 数据名称不易理解数据清洗,需要更改列名
3)选择一些子集: 因为数据分析中不需要其中的一些子集
4)可能有一些逻辑问题需要筛选: 例如,单价为负数
5)格式一致性: 说明可能存在标点问题/大小写不一致/空格重复等问题.
6)消除空值: CustomerID,Description,Country和UnitPrice均具有需要删除的NaN值
**第二,调整数据类型**
DataDF.dtypes
! [调整数据类型之前]()
```python#将字符串转换为数值(整数)DataDF ['Quantity'] = DataDF ['Quantity']. astype('int')#将字符串转换为数值(浮点型)DataDF ['UnitPrice' ] = DataDF ['UnitPrice']. astype('float')
DataDF.dtypes
<br>
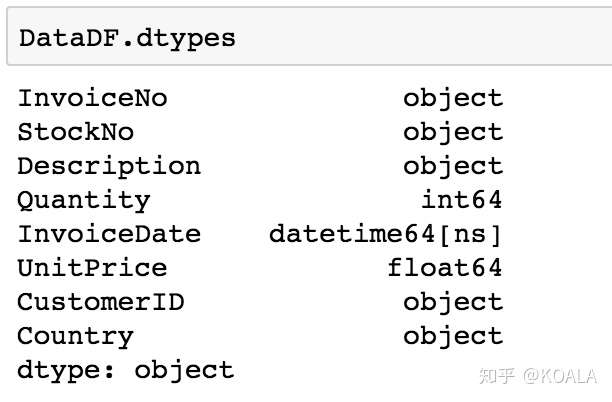
<br>
**三、修改列名**
```python
DataDF.head(10)
![在修改列名之前]()
```python#创建一个字典字典: 旧列名和新列名之间的对应关系colNameDict = {'InvolceDate': 'SaleDate','StockCode': 'StockNo'}#!! ⚠️请确保将旧列名称放在#之前的冒号中. 每个组之间的对应关系之间用[逗号] DataDF.rename(columns = colNameDict,inplace = True)分隔
DataDF.head(10)
<br>

<br>
**四、选择部分子集**
```python
DataDF
![数据集]()
```python#选择一个子集,选择subDataDF1 = DataDF [“ InvoiceDate”]]中的一个
subDataDF1
<br>

<br>
```python
#选择子集,选择其中两列
subDataDF2=DataDF[["InvoiceDate","UnitPrice"]]
subDataDF2
! [两栏子集]()
使用切片来过滤数据功能df.loc
loc此代码有点像Excel中的鼠标左键,您可以拉出需要切片的数据.
逗号用作分隔边界,左侧为索引,右侧为列
subDataDF3=DataDF.loc[:,"InvoiceDate"]
subDataDF3
#单一个冒号意味着不作限制的全选
![subDataDF3]()
```pythonsubDataDF4 = DataDF.loc [0: 9,: ] subDataDF4`''
![subDataDF4]()
``pythonsubDataDF5 = DataDF.loc [1: 8,“ StockNo”: “ CustomerID”] subDataDF5```
![subDataDF5]()
需要筛选五个逻辑问题
它也是Dataframe.loc函数的知识点.
因为loc还可以判断条件是否为真
DataDF.loc[:,'UnitPrice']>0
![UnitPrice> 0]()
通常来说,价格不能为负,因此从逻辑上讲,如果价格小于0,则应过滤掉数据
#删除异常值:通过条件判断筛选出数据
#查询条件
querySer=DataDF.loc[:,'Quantity']>0
#应用查询条件
print('删除异常值前:',DataDF.shape)
DataDF=DataDF.loc[querySer,:]
print('删除异常值后:',DataDF.shape)
! [删除异常值后]()
六. 格式一致性

1. 大小写/删除空格
将数据的描述列中的所有内容更改为大写:
DataDF['Description']= DataDF['Description'].str.upper()
DataDF.head()
类似的代码还具有字符串修改方法:
str().
upper()
lower()
title()
lstrip()
strip()
# str.strip()把字符串头和尾的空格,以及位于头尾的 \n \t 之类给删掉。
DataDF['Description']= DataDF['Description'].str.strip()
如何使用strip()
2. 删除字符串符号和乱码
3. 空格分隔
#定义函数:分割InvoiceDate,获取InvoiceDate
#输入:timeColSer InvoiceDate这一列,是个Series数据类型
#输出:分割后的时间,返回也是个Series数据类型
def splitSaletime(timeColSer):
    timeList=[]
    for value in timeColSer:
        #例如2018/01/01 12:50,分割后为:2018-01-01
        dateStr=value.split(' ')[0]
        timeList.append(dateStr)
#将列表转行为一维数据Series类型
    timeSer=pd.Series(timeList)
    return timeSer
最后将其分配回去
DataDF.loc[:,'InvoiceDate']=splitSaletime(DataDF.loc[:,'InvoiceDate'])
七,处理缺失的值
缺少三种类型的Python值:
1)Python的内置None值
2)在熊猫中,缺失值表示为NA,表示不可用.
3)对于数字数据,pandas使用浮点值NaN(非数字)表示缺少的数据. 数据稍后出来,如果遇到错误: 什么是浮点错误,它是一个缺失的值,您需要对其进行处理
None和NaN有什么区别?
None是Python的数据类型,
NaN是浮点类型
两者都用作空值
print(type(None))
print(type(NaN))
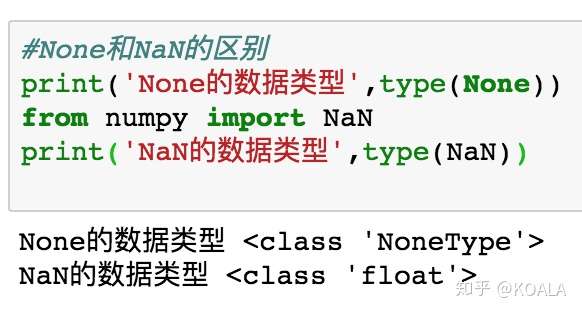
1. 删除缺失的值

# 再一次提醒检查缺失数据
DataDF.isnull().sum().sort_values(ascending=False)
删除缺少值的知识点:
DataFrame.dropna
DataFrame.dropna(axis = 0,how ='any',thresh = None,subset = None,inplace = False)
# 默认(axis=0)是逢空值剔除整行,设置关键字参数axis=1表示逢空值去掉整列
# 'any'如果一行(或一列)里任何一个数据有任何出现Nan就去掉整行,
# 'all'一行(或列)每一个数据都是Nan才去掉这整行
DataDF.dropna(how='any')
DataDF.dropna(how='all')
# 更精细的thresh参数,它表示留下此行(或列)时,要求有多少[非缺失值]
DataDF.dropna(thresh = 6 )
2. 填写缺失的内容: 可以通过四种方式填充一些缺失的值:
使用业务知识或经验猜测来输入缺失的值(默认)
使用相同指标的计算结果(均值,中位数,众数等)填充缺失值
用相邻的值填充缺失的值
用不同指标的计算结果填充缺失值
删除缺少值的知识点:
1)填充默认值-df.fillna('')
我们应该删除那些不友好的NaN值. 但是,我们应该取代什么价值?此时,您可能需要结合自己对这个数据集的理解,以查看哪种数据更合适. 以下是常用方法.
在此数据集中,我们粗略地判断,如果CustomerID不太重要,则可以使用“”空字符串或其他默认值.
DataDF.Country= DataDF.Country.fillna('Not Given')
2)使用相同指标的计算结果(均值,中位数,众数等)填写缺失值
平均df.fillna(df.mean())
使用数字数据可以通过这种方法减少错误.
例如,在这种情况下的价格. 填写0或“未给出”是不合适的,但是可以根据其他数据来估算这个近似价格.
DataDF.UnitPrice = DataDF.UnitPrice.fillna(DataDF.UnitPrice.mean())
3)另外,还有一种通用方法数据清洗,就是用相邻的值填充
这在时间序列分析中很常见. 可以向后填充与前面相邻的值,或者向前填充与后面相邻的值.
print(DataDF)
print(DataDF.UnitPrice.fillna(method='ffill')) # 前向后填充
print(DataDF.UnitPrice.fillna(method='bfill')) # 后向前填充
4)用不同指标的计算结果填写缺失值
关于此方法,年龄字段丢失了,但是有一个带掩码的六位ID号用于计算特定年龄.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-244358-1.html
-

-
赵构
小编你是无知还是意淫
-
神乐雛田
国之幸
-
张栗铭
只要进入12海里
-
 蓝月亮洗衣液区域经销商代理商价格表
 基于区块链的分布式云计算简介
 34064653的博客
 已无实体 家居“新零售”究竟是什么 卫浴企业能否赶上?
相信世界上