数据结构知识: 链表,队列和堆栈之间的区别
电脑杂谈 发布时间:2020-06-09 00:07:11 来源:网络整理
链接列表,队列和堆栈都是所有类型的数据结构. Sartaj Sahni在他的书“数据结构,算法和应用程序”中说: “数据结构是数据对象,对象实例与构成实例的数据元素之间存在各种连接. 这些连接可以通过以下方式定义: 给出了相关的功能. ”他将数据对象(数据对象)定义为“数据对象是实例或值的集合. ”
一个. 链接列表
1. 定义
链表(Linked list)是一种常见的基本数据结构,是一个线性表,但不以线性顺序存储数据,而是由节点组成,每个节点(节点)都存储数据变量(数据)和指针变量(节点下一个),并且有一个头节点(head)连接到下面的节点,最后一个节点指向null(null). 您可以在链接列表类中定义添加,删除,插入,遍历,修改和其他方法,因此通常用于存储数据.
2. 优势
(1). 使用链表结构可以克服阵列链表需要事先知道数据大小的缺点. 链表结构可以充分利用计算机的内存空间,实现灵活的内存动态管理.
(2). 数据访问通常按不同的排序顺序进行转换,并且链接列表是自指示数据类型,因为它包含指向同一类型的另一数据的指针(链接). 链接列表允许在列表的任何位置插入和删除节点,但是不允许随机访问.
3. 缺点
链表失去了随机读取数组的优点. 同时,链表增加了节点的指针字段链表的结构,空间开销比较大.
4. 输入
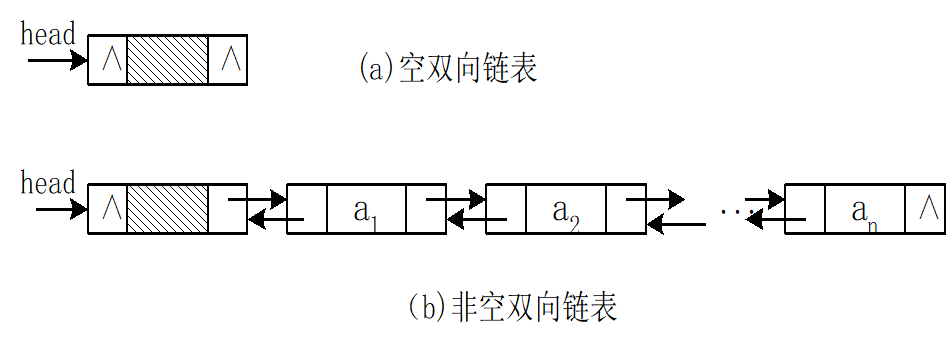
主要有单向链表,双向链表和循环链表.
5. 例子
(1). 单向链表

(2). 双向链接列表


6. 与数组比较
使用链表不需要了解数据的大小,并且在创建数组时必须指定数组的大小.
链表没有对应的下标,只有指向下一个数据的指针,并且每个数组都有对应的下标.
存储在链表的内存中的数据可以是不连续的,并且存储在数组中的数据占据内存的连续部分,并由标识符标识.
两个. 队列
1. 定义
队列是一个特殊的线性表. 它仅允许在表的前面进行删除操作,并在表的后面进行插入操作. 执行插入操作的末端称为队列的尾部,执行删除操作的末端称为队列的首部. 当队列中没有元素时,称为空队列.
在队列的数据结构中,首先插入的元素将是首先删除的元素;否则,最后插入的元素将是最后删除的元素,因此队列也称为“先进先出”(FIFO —先入先出).
2. 排队方法
add(E e)将指定的元素插入此队列(如果立即可行并且不违反容量限制),则成功则返回true
之前没有可用空间,将引发IllegalStateException. 返回布尔值.
element()获取此队列的头而无需将其删除. 如果此队列为空,则抛出NoSuchElementException并返回通用E.
当使用具有容量限制的队列时,
offer(E e)将指定的元素插入此队列(如果立即可行并且不违反容量限制),

此方法通常比add(E)更好,后者可能无法插入元素,而只会引发异常. 返回布尔值.
peek()获取此队列的头部而不删除它;如果此队列为空,则返回null. 返回通用E.
poll()获取并删除此队列的头部;如果此队列为空,则为null. 返回通用E.
remove()获取并删除此队列的头. 返回通用E.
3. 使用队列和虚假溢出
队列可以与数组Q [1 ... m]存储在一起,数组的上限为m,最大容量为m. 在队列操作中,需要设置两个指针: 团队负责人(head),它指向团队实际负责人的先前位置;团队的尾部(尾巴),它指向实际团队的位置,即队列中元素的数量. 数量为: N =尾巴头. 通常情况下,两个指针的初始值设置为0,则队列为空,没有元素.
如果数组定义Q [1 ... 10],则head = 2,tail = 8. 如果要使行的首部更清晰,则需要将头指针增加1. 即,head = head + 1,头指针向上移动一个位置并指向Q(3),指示Q(3 3)已出队. 如果希望有新元素加入团队,则需要将尾指针向上移动一个位置. 那是tail = tail + 1,然后Q(9)加入团队. 当队列的尾部已在顶部进行处理时,即tail = 10,如果要执行入队操作,则会发生“溢出”,但实际上队列中有三个空位置,因此将这种溢出称为“假”溢出”.
4. 循环队列的概念
要充分利用向量空间,克服“错误溢出”现象的方法是将向量空间视为首尾相连的环,并将此向量称为循环向量. 存储在其中的队列称为循环队列.
循环队列入队算法:
(1). tail = tail + 1;
(2). 如果tail = m + 1,则tail = 1;
(3). 如果head = tail尾指针与head指针重合,则判断为空还是满;
(4). 否则,Q [tail] = X,结束(X是新的进入和退出元素).
循环队列出队算法:

(1). 如果head = tail尾指针与head指针重合,则判断为空还是满;
(2). 如果不重叠,则head = head + 1;
(3). 如果head = m + 1,则head = 1;
(4). 移去Q [head]并结束.
在循环队列中,进入团队时,尾部指针追上了头部指针;离开团队时,头指针追上了尾指针,导致团队为空且团队满员时头指针和尾指针相等. 因此,条件front == rear不能用于确定队列是“空”还是“满”.
至少有两种方法可以解决此问题:
①设置另一个布尔变量以区分空队列和满队列;
②另一种方法通常用于数据结构: 组队满时: (tail + 1)%n = head,n是队列的长度(所用数组的大小),因为tail和head是指向所用空间的指针,循环这只是一个逻辑循环,因此我需要计算余数. 如图所示,团队已满,但尾巴+ 1 = 5 + 1 = 6,n = 6,剩下的6%6 = 0 =头.

5. 阻塞队列(BlockingQueue)的概念
三个. 堆叠
1. 定义
堆栈是硬件. 主要作用表示为数据结构,这是一种特殊的线性表,只能在一端插入和删除. 它按照后进先出的原则存储数据. 第一个输入的数据被压入堆栈的底部,最后一个数据被压入堆栈的顶部. 当需要读取数据时,将从堆栈顶部弹出数据(首先读取最后一个数据).
堆栈是一个特殊的线性表,允许在同一端进行插入和删除操作. 允许插入和删除的一端称为堆栈的顶部,另一端称为堆栈的底部. 堆栈的底部是固定的,而堆栈的顶部是浮动的;当堆栈中的元素数为零时,称为空堆栈. 插入通常称为PUSH,而删除称为POP. 堆栈也称为后出表.
2. 堆叠方法
empty()测试堆栈是否为空. 返回布尔值.
peek()查看堆栈顶部的对象,但不要将其从堆栈中删除. 返回通用E.
pop()删除堆栈顶部的对象,并将其作为此函数的值返回. 返回通用E.
push(Eitem)将项目推入堆栈的顶部. 返回通用E.
search(Objecto)返回对象在堆栈上的位置,以1为基数. 返回int.
3. 堆栈的实现
1. PUSH算法
①如果TOP≥n,则会给出溢出信息并进行错误处理(进入堆栈之前请先检查堆栈
满链表的结构,满时溢出; ②)如果不满;
②设置TOP = TOP + 1(向堆栈指针加1指向堆栈地址);
③S(TOP)= X,结束(X是堆栈上的新元素);
2. POP算法
①如果TOP≤0,它将给出下溢信息并进行错误处理(退出堆栈之前检查是否为空,
如果为空,将溢出;如果不为空,则将完成②);
②X= S(TOP),(拆堆后分配给X的元素):
③TOP= TOP-1,结束(堆栈指针减1,指向堆栈的顶部).
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-238799-1.html
-
 周济川
-
欧梦婷
但是好费电
-
高章
淘宝是假货的天堂
-
-
姬欢
又在这里自娱自乐
-
王海洋
#fx_4walls##fx_4walls##fx_4walls#
-
 冠状病毒会传染人吗 关于中东呼吸综合征(MERS)应该了解的那些事
 运维体系 实时计算平台 人工智能给云时代的智能运维带来了哪些创新