网络爬虫的基本原理(1)
电脑杂谈 发布时间:2020-06-07 21:27:14 来源:网络整理
网络搜寻器是搜索引擎搜寻系统的重要组成部分. 搜寻器的主要目的是在Internet上下载网页,以形成Internet内容的镜像备份. 该博客主要简要介绍了搜寻器和搜寻系统.
首先,网络爬虫的基本结构和工作流程
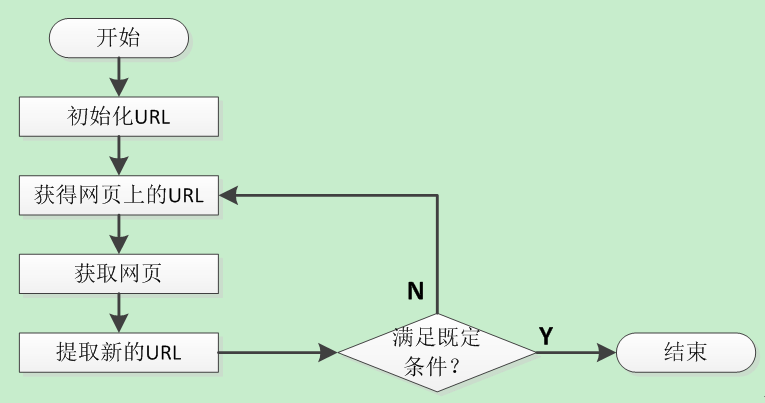
图中显示了一个通用的Web搜寻器框架:

网络搜寻器的基本工作流程如下:
1. 首先选择经过精心选择的网址的一部分;
2. 将这些URL放入要抓取的URL队列中;

3. 从要爬网的URL队列中删除要爬网的URL,解析DNS,获取主机的ip,下载与该URL对应的网页,并将其存储在下载的网页库中. 另外,将这些URL放入爬网URL队列中.
4. 分析爬网的URL队列中的URL,分析其中的其他URL,然后将该URL放入要爬网的URL队列,以进入下一个周期.
第二,从爬虫的角度划分互联网
相应地,Internet上的所有页面可以分为五个部分:

1. 下载未过期的网页
2. 已下载和已过期的网页: 爬行的网页实际上是Internet内容的镜像和备份. Internet正在动态变化网络爬虫的工作原理,Internet上的某些内容已更改. 目前,您访问的网页的这一部分已过期.

3. 要下载的网页: URL队列中要爬网的那些页面
4. 已知网页: 它尚未进行爬网,也不在要爬网的URL队列中,但是通过分析爬网页面或要爬网的URL的对应页面获得的URL被认为是已知网页.
5. 仍然存在某些网页,爬网程序无法直接爬网和下载. 被称为未知网页.
三,抓取策略
在搜寻器系统中,要搜寻的URL队列是非常重要的部分. 爬网URL队列中的URL的顺序也是一个非常重要的问题,因为它涉及先爬网该页面然后爬网哪个页面. 确定这些URL的顺序的方法称为爬网策略. 以下重点介绍了几种常见的爬网策略:
1. 深度优先遍历策略
深度优先遍历策略意味着Web爬网程序将从起始页面开始,在另一个链接之后跟踪一个链接,然后在处理此行之后,转到下一个起始页面并继续跟踪该链接. 让我们以下面的图片为例:


行进路径: A-F-G E-H-I B C D
2. 宽度优先遍历策略
广度优先遍历策略的基本思想是将在新下载的网页中找到的链接直接插入要爬网的URL队列的末尾. 也就是说,Web爬网程序将首先对在起始页面中链接的所有页面进行爬网,然后选择链接的页面之一以继续对在此页面中链接的所有页面进行爬网. 以上面的图片为例:
横行路径: A-B-C-D-E-F G H I
3. 反向链接编号策略
反向链接数是指其他网页链接所指向的网页数. 反向链接的数量表示他人推荐网页内容的程度. 因此,搜索引擎的爬网系统通常会使用此指标来评估网页的重要性,从而确定不同网页的爬网顺序.
在真实的网络环境中,由于存在广告链接和欺诈链接,因此反向链接的数量不能完全等于他和我的重要性. 因此,搜索引擎通常会考虑一些可靠的反向链接.
4. 部分PageRank策略
部分PageRank算法借鉴了PageRank算法的思想: 对于下载的网页,以及要抓取的URL队列中的URL网络爬虫的工作原理,形成了一个网页集合,并计算了每个页面的PageRank值. 计算后,要爬网的URL根据PageRank值排列队列中的URL,并按此顺序对页面进行爬网.
如果每次爬网页面,都会重新计算PageRank值. 一种折衷方法是: 每次抓取K页时都要重新计算PageRank值. 但是在这种情况下会出现问题: 对于在下载的页面中分析的链接,即我们前面提到的未知网页的一部分,暂时没有PageRank值. 为了解决这个问题,这些页面将被赋予一个临时的PageRank值: 将所有传到该页面链中的PageRank值进行汇总,从而形成未知页面的PageRank值,以便参与排序. 以下是一个示例:
5. OPIC策略策略
该算法实际上为页面的重要性打分. 在算法开始之前,给所有页面相同的初始. 下载某个页面P后,将P的分配到从P分析的所有链接中,并清空P的. URL队列中要爬网的所有页面均根据量进行排序.
6. 大型网站的优先级策略
对于要爬网的URL队列中的所有页面,将根据它们所属的网站对它们进行分类. 对于要下载大量页面的网站,优先考虑下载. 因此,该策略称为“大站点优先级策略”.
参考文献:
1. “这是搜索引擎对核心技术的详细说明”,张俊林电子工业出版社
2. “搜索引擎技术基金会”刘义群和清华大学出版社
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-237605-1.html
-

-
上官昭容
你收了多少
 如何在单词中设置数字的千位分隔符?两种轻松完成的方式
 如何编写图书管理系统 河北宏润钢木家具
 SpringBoot AOP(方面注释方法)的详细说明
 为什么有人写计算机病毒
美国的航母战斗群在台湾海峡一横就能执行自己意志的时代一去不复返了