实时OLAP系统Druid
电脑杂谈 发布时间:2020-06-06 22:09:30 来源:网络整理
稍后,我将写几篇文章来介绍OLAP的大数据系统体系结构. Druid不是阿里巴巴的连接池,而是用于大数据实时OLAP的Druid.
经常将OLAP和OLTP聚集在一起进行讨论. 其中,OLAP的全名是联机分析处理,而OLTP的全名是联机事务处理. 在互联网上对这两个系统的分析和比较通常是漫长而累人的. 实际上,从系统角度来看,OLAP与OLTP的最大区别仅在于以下几点:
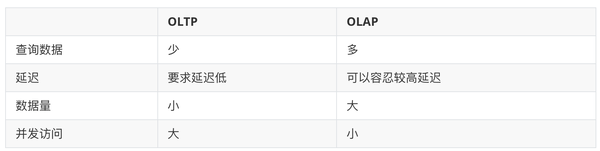
OLTP对应于常见的关系,例如MySQL. OLAP分为实时OLAP和脱机OLAP. 某些大数据体系结构(例如常见的Hive + Hadoop,SparkSQL + HDFS,Kylin等)是脱机OLAP,而某些监视和警报系统(例如具有更高实时性的系统)是实时OLAP.
Druid是实时OLAP. 去年大约这个时候,我们从0到1开始使用Druid来构建我们的实时OLAP系统. 该系统当前运行半年,单个DataSource提取的数据量达数百亿. 在这个过程中,我遇到了许多问题,并发现了Druid的一些局限性. 本文首先简要介绍了Druid的体系结构和一些功能. 下一篇文章介绍了一些最佳实践.
德鲁伊很早就进入了Apache孵化器,但尚未毕业. 官方网站: druid.apache.org,Github: apache / incubator-druid
根据官方文件,德鲁伊的核心功能主要包括:
我不知道这名官员是否故意增加,只有十个. 实际上,其中许应视为OLAP系统的通用功能,例如列式存储. 当我选择德鲁伊时,以下三个项目最吸引我:
在我看来,德鲁伊的体系结构仍然相对复杂,包含6个不同的组件.
各个组件之间的交互如下:
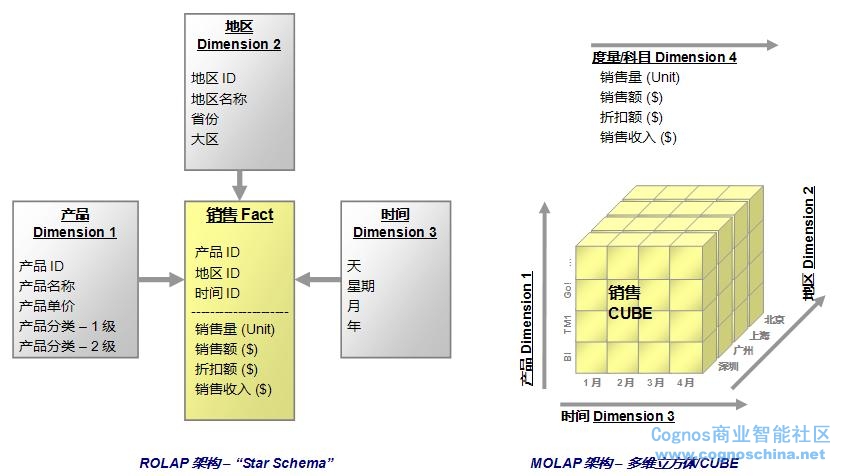

根据线条,上面的图片主要集中在三个部分:

德鲁伊的数据存储单位是段,段按时间粒度划分(可以通过参数segmentGranularity指定). 每个段都将存储在深度存储和历史记录进程所在的节点上. 当然,该段可以有多个备份. 这样,可以在查询过程中实现并行查询,而不是为了实现高可用性. 深度存储可确保高可用性.
Druid的数据格式如下:
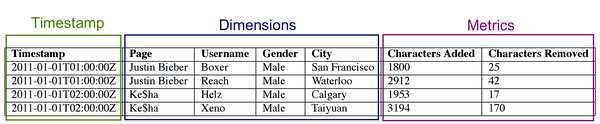
分为三个部分:
Druid将自动汇总数据,即汇总. 如果时间粒度为一小时,则具有相同维的数据将在该小时内合并为一个,时间戳将成为整点,度量将根据聚合函数进行聚合olap特性,例如sum,max,min等请注意,没有平均平均值. 时间戳和度量标准只是简单地压缩和存储,这相对简单. 以下重点介绍维度的存储.
Druid的一大亮点是对多维实时聚合查询的支持,简单来说就是过滤器和分组. 实现此功能的关键技术主要有两点: 位图+倒置.
首先,Druid将维度值代码映射到数字ID,类似于数据仓库中的维度表,主要是为了节省存储空间. 例如,上图中的Page维度: Justin Bieber编码为0,Ke $ ha编码为1. 对于Username维度: Boxer-> 0,Reach-> 1olap特性,Helz-> 0,Xeno-> 1.
然后页面数据将存储为[0,0,1,1].
最后,位图用于指示某列包含该值以表示特定维的某个值,例如:
然后过滤器查询Page ='Justin Bieber'和Username ='Boxer',直接对1100和1000执行位操作. 组相似.
上面的位图实际上是一种倒排. 常规倒排后面的列表直接包含文档ID. 在这里,它直接表示为位图,实际上是相同的.
如前所述,德鲁伊的数据获取支持实时流模式和批处理模式,这是典型的Lambda架构. Lambda架构只是两点:
如果我阅读上一篇有关Google DataFlow的文章,那么作者当时批评了lambda架构,然后在Google中,MillWheel支持一次精确的语义来避免使用lambda架构. 德鲁伊的数据获取正式支持多种方法,下图总结了各种方法的比较.

关于上图中的“可以处理最新数据”,为简要说明,我们在上面的数据存储部分中提到了Druid的基础存储使用段结构. 例如,如果时间间隔为1小时,则从12:00到13:00的数据将存储在一个段中. 但是这里有一个小问题要考虑,该段的数据何时准备就绪,我怎么知道?流处理中的常见做法是水印. 简单来说,设置一个可接受的时间延迟,例如5分钟,那么12:00〜13:00将始终接收数据直到13:05,然后此段将被越区切换,并且数据在12:00〜13之间: 00将不再被接受. 此过程称为“处理后期数据”. 然后我们发现上图中的“宁静”不支持后期数据处理,这需要特别注意.
从上图可以看到,本机批处理和Hadoop对应于Lambda架构中的批处理,而Tranquility对应于Lambda架构中的实时处理,这是一种推送方法. 再有一种叫做Kafka Indexing Service的方式,这种通过拉取方式摄取数据的方式,我们还可以看到Kafka Indexing Service是一种实际上可以完成数据摄取并满足所有需求的服务,否则它将通过这两种方法结合. 但是,Kafka Indexing Service的最大问题是与Kafka的牢固耦合.
由于我们的业务位于阿里云公共云上,然后所有数据收集都使用阿里云的日志服务(SLS)处理,因此我们不能在此处使用Kafka索引. 在这里,我们使用Tranquility + Hadoop方法进行数据提取. 单个DataSource的数据摄入量达到数百亿.
Druid最初不支持SQL查询. 本地查询是通过查询Broker提供的http服务器来实现的,如下所示:
curl -X POST <queryable_host>:<port>/druid/v2/?pretty -H Content-Type:application/json -H Accept:application/json -d @<query_json_file>以下是一个简单的json查询示例.
{
  queryType: timeseries,
  dataSource: sample_datasource,
  intervals: [ 2012-01-01T00:00:00.000/2012-01-03T00:00:00.000 ],
  granularity: day,
  aggregations: [
    { type: longSum, name: sample_name1, fieldName: sample_fieldName1 },
    { type: doubleSum, name: sample_name2, fieldName: sample_fieldName2 }
  ],
  context: {
    grandTotal: true
  }
}
同时,社区还为Druid查询提供了多种语言的客户端,例如我们使用的Java客户端zapr / druidry. 有关更多语言的客户端,请在此处参考客户端库.
德鲁伊的查询类型如下:
聚合查询:
元数据查询
Druid的元数据通常存储在MySQL中,并包含一些数据源和段的元数据信息.
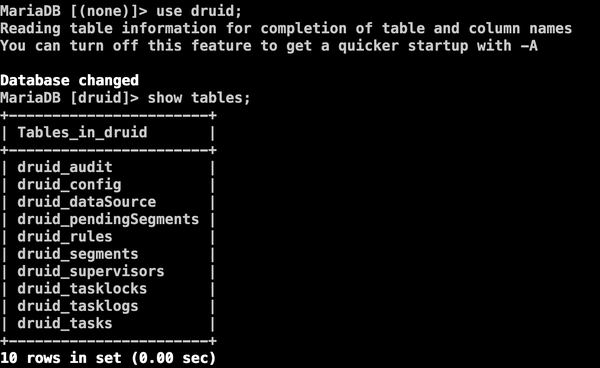

德鲁伊提供了以下三个元数据查询
搜索查询(搜索查询)
Druid的基础存储使用时间进行分片,因此查询时必须带一个时间间隔.
我曾经说过,德鲁伊的汇总不支持平均值,这是平均值,所以如果我查询时要查询平均值,该怎么办? (实际上,查询平均值是非常常见的要求. 关于Druid的汇总不支持平均值,请留言以讨论. )
答案是聚合后的. Druid可以在查询期间定义聚合操作,该操作在查询期间直接计算. 同时,德鲁伊还为合计值提供了合计操作,称为后合计. 一个查询json文件的简单示例.
{
  queryType: timeseries,
  dataSource: sample_datasource,
  granularity: day,
  descending: true,
  filter: {
    type: and,
    fields: [
      { type: selector, dimension: sample_dimension1, value: sample_value1 },
      { type: or,
        fields: [
          { type: selector, dimension: sample_dimension2, value: sample_value2 },
          { type: selector, dimension: sample_dimension3, value: sample_value3 }
        ]
      }
    ]
  },
  aggregations: [
    { type: longSum, name: sample_name1, fieldName: sample_fieldName1 },
    { type: doubleSum, name: sample_name2, fieldName: sample_fieldName2 }
  ],
  postAggregations: [
    { type: arithmetic,
      name: sample_divide,
      fn: /,
      fields: [
        { type: fieldAccess, name: postAgg__sample_name1, fieldName: sample_name1 },
        { type: fieldAccess, name: postAgg__sample_name2, fieldName: sample_name2 }
      ]
    }
  ],
  intervals: [ 2012-01-01T00:00:00.000/2012-01-03T00:00:00.000 ]
}
SQL在大数据系统(尤其是OLAP)中的重要性不言而喻. 因此,我看到Druid在早期不支持SQL查询. 我很惊讶. Druid仍然启动了SQL查询. 该层建立在本机请求之上,这意味着将SQL解释为本机查询,然后请求Broker.
Druid SQL解析基于Apache Calcite. 说到Apache Calcite,这是业界非常广泛使用的SQL语法解析模块. 如果您没记错的话,Hive似乎会使用它.
Druid SQL值得一提的是,它提供了许多函数,包括数值计算,字符串运算,时间运算等. 例如,其中一个字符串操纵函数称为REGEXP_EXTRACT(expr,pattern,[index]),对expr进行常规匹配并提取特定字段. 使用此功能可以做很多事情. 但是有时函数对SQL执行计划优化不是很友好. 我不知道德鲁伊团队如何称重它.
这里列出了其他值得讨论的主题.
由于Druid将汇总存储的数据,因此在正常情况下,无法存储详细信息. 但是,如果您需要详细信息,则可以使用一种方法将所有列(包括指标)设置为维度,并将聚合粒度设置为可接受的粒度(例如秒).
这里的高基数是指德鲁伊维数的值. 可能有很多价值观. 这就带来了一个问题,它将在存储期间消耗大量空间,并且还将对CPU占用产生一定的影响.
总体而言,Druid是一个出色的实时OLAP系统. 尽管在某些地方设计不完美,但无法掩盖缺陷. 本文简要介绍了德鲁伊的总体情况,希望为使用德鲁伊的学生提供一些参考. 下一篇文章将介绍我们在过去一年中基于Druid的实践以及我们所遇到的一些陷阱.
我还有最后一个问题. 我很好奇. 与Apache Foundation项目相比,Druid在很多方面都非常出色,但是为什么它还没有从Apache毕业,这确实令人困惑.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-236438-1.html
-

-
王语童
直男癌晚期
-
 中国高性能计算机TOP100排名呈锕獾诎舜味峁?太平言网
 document.write( ); 四川乐山女交警谭霞10年坚守春节一线保路畅(图)
 在Ubuntu下设置您自己的“超级计算机集群”
 OGNL表达式的基本语法和用法
看过【超级战舰】吗