数据产品不可或缺的技术知识: 数据仓库简介,足以阅读本文
电脑杂谈 发布时间:2020-06-06 05:05:26 来源:网络整理
摘要: 对于正在准备求职数据产品的童鞋,可能没有几个仓库的朋友可以咨询. 自己学习,那些经典书籍太理论化了. 似乎生命胜于死亡,数据产品不是数据开发. 您可能会了解一些入门常识,并且有一个通用概念. 我一直在逐步积累这一知识. 我梳理了这两天,形成了以下内容.
关键字: 数据产品
数据仓库可以被视为数据产品必须理解的技术知识. 一年前在数据产品的求职分析中,技能要求中,数据仓库占有一席之地.
但是,对于正在准备求职数据产品的童鞋,可能不是Shukura开发的朋友可能会问. 自己学习,那些经典书籍太理论化了. 似乎生命胜于死亡,数据产品不是数据开发. 您可能了解一些入门常识,并且有一个一般概念.
我一直在逐步积累这一知识. 我梳理了这两天以形成以下内容. 希望对大家有帮助. 对于非的数据仓库开发人员,如果有任何不准确之处,我希望每个人都可以纠正我.
文章结构
首先,什么是数据仓库
第二,数据仓库的特征是什么
三,为什么要建立数据仓库
四个数据仓库结构
五,ETL
六. 数据集市
VII. 消耗臭氧层物质
八,元数据
首先,什么是数据仓库
可以理解为: 面向分析的存储系统.
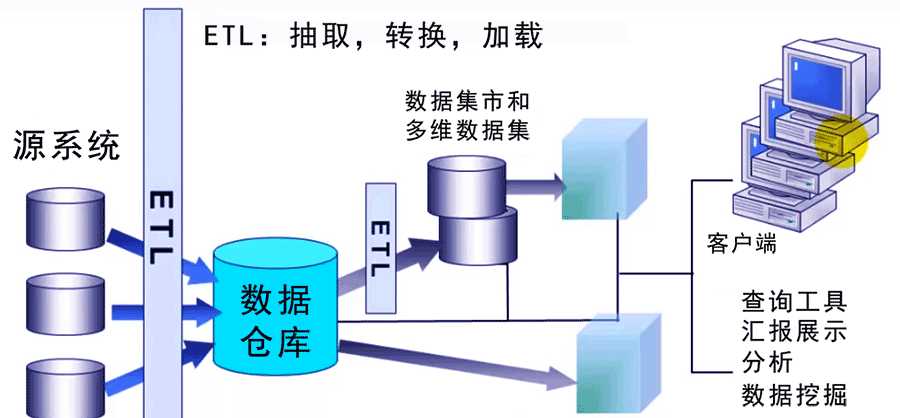
也就是说,数据仓库存储数据,并插入企业的各种数据. 主要目的是有效地分析数据,然后将其输出以用于分析和挖掘数据,或者数据应用所需的数据,例如公司的分析报告和各种报告,为公司的决策提供了支持.
首先了解上面的含义,然后从头开始,首先看一下关系,它可以分为两种基本类型: 操作和分析.
1. 运营
它主要面向应用程序,用于业务支持,并支持实际业务的处理. 也可以称为业务.
可以理解为通常意义上的(后端开发学生经常在此提及).
2. 分析
主要用于数据分析,侧重于决策支持,作为公司的独立数据存储,负责使用历史数据对公司主题领域进行统计分析.
由于分析中的操作都是查询,因此无需严格满足关系的某些设计规范. 在这种情况下,将其分类为是不合适的,并且不容易引起混乱,因此将其称为“这是数据仓库”.
这里可以说数据处理可以大致分为两类: OLTP(事务处理)和OLAP(分析处理).
OLTP(联机事务处理)是操作的主要应用程序,它更加侧重于基本的日常事务处理,包括数据的添加,删除和修改.
OLAP(分析处理)是分析的主要应用. 它以多维方式分析数据,稍后将对其进行整理.
第二,数据仓库的特征是什么
与相比,数据仓库具有以下特征
(1)面向主题
数据仓库通过主题域从多个业务系统中加载数据,并为分析各种主题(例如用户,订单,商品等)而构建. 建立运营以支持各种业务.
(2)集成
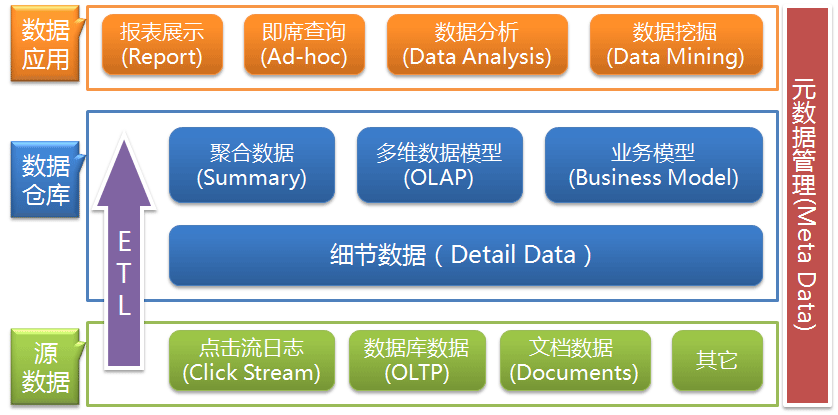
数据仓库聚合来自不同源的数据.
(3)历史悠久
与可操作的相比,数据仓库中的数据是为企业数据分析而构建的,因此数据仓库,数据在加载后通常会保留很长时间. 前者通常会保存几个月,而后者可能会保存几年甚至几十年.
(4)时变
表示数据仓库包含其时间范围内不同时间段的数据快照. 获得这些快照后,用户可以对其进行汇总,并为每个历史阶段生成数据分析报告.
(5)稳定性
数据仓库中的数据通常仅执行查询操作,很少删除或更新. 但是数据需要定期加载和刷新.
三,为什么要建立数据仓库
简单地说,它是用于有效的数据分析.
您说要直接从业务中获取数据进行分析?
这也不是没有可能,因为有许多业务系统,当业务复杂时,您会发现结构复杂,数据脏,难以理解,缺乏历史记录以及查询缓慢的问题.
当业务达到一定规模时,每个人都需要面对的问题变得越来越复杂和深入. 数据需求不再只是昨天的收入,上个月的紫外线,而是“社区中28-45岁女性的活跃程度. 详细分析了公司计划的特殊内容活动之间的关系,很难从中提取此类数据.
毕竟,业务旨在支持业务,而不是查询和分析数据.
四个数据仓库结构
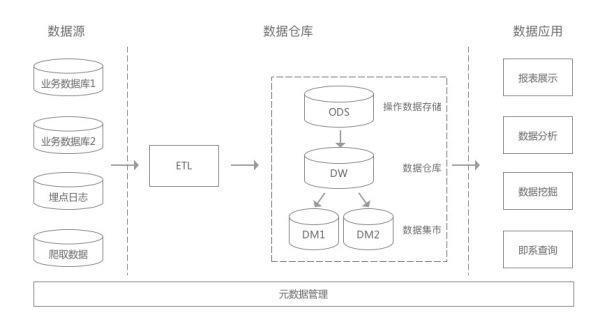
使用AXURE绘制,如下所示: 简单来说,就是将每个数据源中的数据ETL到数据仓库中,然后数据仓库将对数据进行集成和计数,然后将其输出到每个数据应用. 涉及的模块将单独介绍.

五,ETL
ETL代表: 提取,转换和加载.
(1)提取(提取)
从数据源提取指定的数据. 需要指定数据. 并非必须提取所有数据. 某些源数据对分析没有任何价值,或者它可能产生的值远低于存储这些数据的值. 不会提取所需数据仓库的实施成本和性能.
(2)转换(Transform)
将数据转换为指定的格式并执行数据清理以确保数据质量.
数据转换,包括代码转换(m / f->公/母),字段转换(balance-> bal),测量单位转换(cm-> m)和数据粒度转换. 业务系统数据存储非常详细的数据,并且对数据仓库中的数据进行了分析,不需要非常详细. 业务系统数据根据数据仓库的粒度进行汇总.
数据清理,例如清理不完整的数据,错误的数据,重复的数据和其他脏数据.
(3)加载(加载)
将转换后的数据加载到目标数据仓库中. 加载有两种类型:
满载: 一次加载所有数据.
增量加载: 通常,它需要第一次完全加载,但是如果在第二个或第三个周期中仍然完全加载,则会消耗大量的物理和时间资源. 某些数据源可能没有更改,而某些数据源可能仅添加了少量数据. 对于数据源中的数据,只有新修改的记录和新插入的记录才被视为增量负载.
ETL可能是数据仓库开发中最耗时和最耗资源的链接,因为该链接需要整理主要业务系统中的混乱数据并协调元数据之间的差异. 工作量非常大,但这也是构建数据仓库的重要组成部分,对数据仓库的后续部分有更大的影响.
六. 数据集市
数据集市(DM)可以理解为“小型数据仓库”,通常面向部门,单个主题或特定的应用程序,并且互不影响.
可以分为以下两种类型:
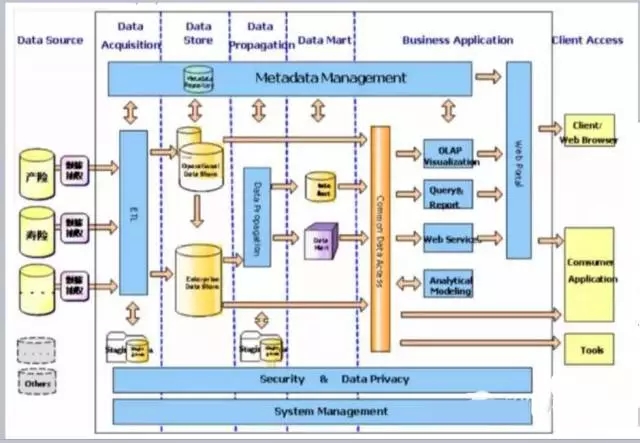
独立数据集市: 具有自己的源和ETL体系结构;
独立数据集市: 没有自己的源数据,其数据来自数据仓库. 当用户或应用程序不需要/不必要/不允许访问整个数据仓库时,他们可以直接访问数据集市,为用户提供数据仓库的“子集”.

一个简单的理解是,结构与具有ETL的数据仓库完全相同,然后由其自身存储和计算;另一种是直接使用数据仓库处理的数据,然后再次合并和集成. 稍后通过数据分层可能会更好地理解.
VII. 消耗臭氧层物质
ODS: 全名是Operational Data Store,即操作数据存储.
存储主要业务的ETL之后的数据是最接近数据源中数据的层,主要目的是为了数据集中.
通常,它们大多数都是根据源业务系统的分类方法进行分类的,因此它们将具有业务的鲜明特征,甚至在关系中具有某种形式的数据范式组织.
但是它不等同于原始数据,数据格式根据数据仓库的要求统一,并且只需清理即可.
八,元数据
元数据(元数据),即元数据数据仓库,元数据可以分为技术元数据和业务元数据.
技术元数据供IT人员开发和管理数据仓库. 它描述了与数据仓库开发,管理和维护相关的数据,包括数据源信息,数据转换描述,数据仓库模型,数据清洗和更新规则,数据映射和访问权限等.
业务元数据为管理层和业务分析师提供服务,并从业务角度描述数据,包括业务术语,数据仓库中的数据,数据的位置以及数据的可用性,以帮助业务人员更好地理解数据仓库中有哪些可用数据以及如何使用.
第30届CIO班报名
->法国布列斯特商学院硕士班招生
-> Beida Soft EXIN网络空间和IT安全基本认证培训
Beida Soft EXIN DevOps认证培训
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-235585-1.html
-

-
周艺峰
和我家过的
 weixin_30480583
 计算机OCR字符识别技术的原理和未来发展趋势
 semaphore java.util.concurrent常用类(Cou
 C语言中的Static和内联函数
>你敢怎么着