火花提交(火花提交)
电脑杂谈 发布时间:2020-06-04 12:09:07 来源:网络整理
spark-submit脚本用于启动集群上的应用程序,它位于Spark的bin目录中. 这种启动方法可以通过统一的界面使用Spark支持的所有群集管理功能,因此您不必为每个应用程序配置应用程序.
如果您的代码依赖于其他项目,则需要将它们与应用程序打包在一起,然后才能将代码分发到Spark集群. 为此spark程序入口,创建一个包含代码及其依赖项的程序集jar(或“超级” jar). sbt和Maven都有集成的插件. 创建程序集jar时,Spark和Hadoop被列为提供的依赖项;这些不需要捆绑,因为它们是由集群管理器在运行时提供的. 组装好jar后,您可以调用bin / spark-submit提交脚本来传递jar.
对于Python,您可以使用spark-submit的--py-files参数添加.py,.zip或.egg文件,以与应用程序一起发布. 如果您依赖多个Python文件,建议将它们打包为.zip或.egg.
捆绑用户应用程序后,可以使用bin / spark-submit脚本启动它. 该脚本负责使用Spark及其依赖项设置类路径,并且可以支持Spark支持的不同集群管理器和部署模式:
./bin/spark-submit \
  --class <main-class> \
  --master <master-url> \
  --deploy-mode <deploy-mode> \
  --conf <key>=<value> \
  ... # other options
  <application-jar> \
  [application-arguments]

或者,如果您的应用程序是从远离工作机器的机器(例如笔记本电脑上的本地机器)提交的,则群集模式通常用于最小化驱动程序和执行程序之间的网络延迟. 当前,独立模式不支持Python应用程序的群集模式.
对于Python应用程序,只需将.py文件而不是JAR文件传递给
一些可用选项特定于所使用的集群管理器. 例如,使用具有集群部署模式的Spark独立集群,还可以指定--supervise以确保如果使用非零退出代码失败,则驱动程序将自动重启. 要枚举spark-submit的所有可用选项,请使用--help运行它. 以下是一些常见选项的示例:
# Run application locally on 8 cores
./bin/spark-submit \
  --class org.apache.spark.examples.SparkPi \
  --master local[8] \
  /path/to/examples.jar \
  100
# Run on a Spark standalone cluster in client deploy mode
./bin/spark-submit \
  --class org.apache.spark.examples.SparkPi \
  --master spark://207.184.161.138:7077 \
  --executor-memory 20G \
  --total-executor-cores 100 \
  /path/to/examples.jar \
  1000
# Run on a Spark standalone cluster in cluster deploy mode with supervise
./bin/spark-submit \
  --class org.apache.spark.examples.SparkPi \
  --master spark://207.184.161.138:7077 \
  --deploy-mode cluster \
  --supervise \
  --executor-memory 20G \
  --total-executor-cores 100 \
  /path/to/examples.jar \
  1000
# Run on a YARN cluster
export HADOOP_CONF_DIR=XXX
./bin/spark-submit \
  --class org.apache.spark.examples.SparkPi \
  --master yarn \
  --deploy-mode cluster \  # can be client for client mode
  --executor-memory 20G \
  --num-executors 50 \
  /path/to/examples.jar \
  1000
# Run a Python application on a Spark standalone cluster
./bin/spark-submit \
  --master spark://207.184.161.138:7077 \
  examples/src/main/python/pi.py \
  1000
# Run on a Mesos cluster in cluster deploy mode with supervise
./bin/spark-submit \
  --class org.apache.spark.examples.SparkPi \
  --master mesos://207.184.161.138:7077 \
  --deploy-mode cluster \
  --supervise \
  --executor-memory 20G \
  --total-executor-cores 100 \
  http://path/to/examples.jar \
  1000
传递给Spark的主要URL可以采用以下格式之一:

主网址说明
在本地运行Spark一个工作线程(也就是说,根本没有并行性).
使用K个辅助线程在本地运行Spark(理想情况下,将其设置为计算机上的内核数).
使用与计算机上逻辑核心数量相同的工作线程在本地运行Spark.
spark: // HOST: PORT

连接到给定的Spark独立集群主机. 该端口必须是您的主机配置为使用的端口,默认情况下为7077.
mesos: // HOST: PORT
连接到给定的Mesos群集. 该端口必须是您配置为使用的端口,默认值为5050. 或者,对于使用ZooKeeper的Mesos群集,请使用mesos: // zk: //.... 要使用--deploy-mode群集提交, HOST: PORT应该配置为连接到MesosClusterDispatcher
根据-deploy-mode的值,以客户端或群集模式连接到YARN群集. 将根据HADOOP_CONF_DIR或YARN_CONF_DIR变量找到群集位置.
spark-submit脚本可以从属性文件加载默认的Spark配置值并将其传递给应用程序. 默认情况下,它将从Spark目录中的conf / spark-defaults.conf中读取选项. 有关详细信息,请参阅有关加载默认配置的部分.

以这种方式加载默认的Spark配置可以避免需要某些标志来触发提交. 例如,如果设置了spark.master属性,则可以安全地从spark-submit中省略--master标志. 通常,在SparkConf上显式设置的配置值具有最高优先级spark程序入口,然后将该标志传递给spark-submit,然后将该值设置为默认值.
如果您不清楚配置选项的来源,则可以使用--verbose选项运行spark-submit来打印出细粒度的调试信息.
使用spark-submit时,应用程序jar和-jars选项中包含的所有jar将自动传输到集群. --jars之后提供的URL必须用逗号分隔. 此列表包含在驱动程序和执行器类路径中. 目录扩展名不适用于--jars.
通过提供以逗号分隔的Maven坐标和--packages列表,用户可以包括任何其他依赖项. 使用此命令时,将处理所有传递依赖项. 您可以使用--repositories标签添加其他存储库(或SBT中的解析器),并以逗号分隔. (请注意,在某些情况下,您可以在存储库URI中提供受密码保护的存储库的凭据,例如: password @ host /.... 以这种方式提供凭据时请小心. )可以使用它带有pyspark,spark-shell和spark-submit,包括Spark软件包.
对于Python,等效的--py-files选项可用于将.egg,.zip和.py库分发到可执行程序.
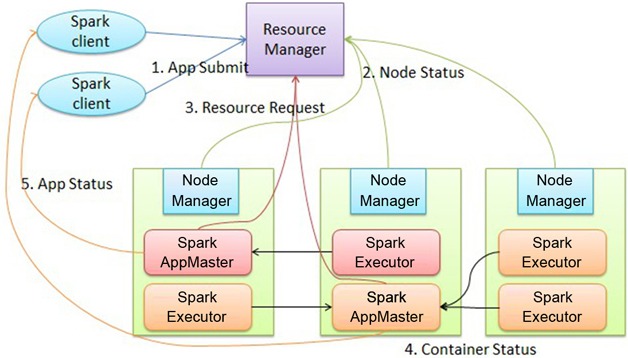
在部署应用程序之后,[集群模式概述] []将介绍分布式执行中涉及的组件以及如何监视和调试应用程序.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-233546-1.html
-

-
韩璐璐
-
晋敬公
都是从资本市场中成为顶级的富豪的
 底部剪切定律问题
 面向对象的PHP(OOP)
 c# 图书管理系统源代码_窗体图书管理系统代码
 软件测试教程-软件测试技术和工具
这IP