数据分析和算法摘要
电脑杂谈 发布时间:2020-06-03 20:07:27 来源:网络整理
简而言之: 如果特定空间中某个样本的K个最近邻居中的大多数都属于某个类,那么该样本就属于该类.
k最近邻的目的是测量不同特征值与分类数据集之间的距离
欧洲距离
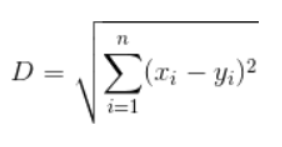
优点: 准确性高,对异常值不敏感,并且没有数据输入假设.
缺点: 时间复杂度高,空间复杂度高.
适用数据范围: 数字类型和标称类型.
分类问题: 从sklearn.neiors导入KNeiorsClassifier
回归问题: 从sklearn.neiors导入KNeiorsRegressor
n_neiors: 取相邻点的数量k. k取1-9的测试权重: 距离的权重;均匀: 体重一致; distance: 距离的倒数作为权重p: Minkowski距离的p值; p = 1: 欧洲距离; p = 2: 曼哈顿距离; p参加1-6考试
[关键字]线性最小二乘
平方误差可以写成:

W的导数,当导数为零时,平方误差最小,则W等于:

从sklearn.linear_model导入LinearRegression
Ridge回归是带有二阶正则项(lambda * I)的最小二乘. 它主要在过度拟合严重或变量之间存在多重共线性时使用. 岭回归具有偏差,这里的偏差是使方差变小.
为了获得一致的假设,使假设过于严格称为过拟合,
bias: 指样本上模型输出与真实值之间的误差
方差: 是指每个模型的输出与所有模型的平均值(期望值)之间的误差

从sklearn.linear_model导入Ridge
alpha: 调整为大于1的数字
1. 简化方法可以删除不重要的参数,以便更好地理解数据. 另外,与简单的线性回归相比,约简方法可以获得更好的预测结果
2. 岭回归是最小二乘法,添加了二阶正则项. 它主要在过度拟合严重或变量之间存在多重共线性时使用. 岭回归有偏差. 缩小方差.
Ring回归可以解决特征数量大于样本大小的问题. 作为简化算法,岭回归可以确定哪些特征重要或不重要. 它有点类似于降维的效果. 归约算法可以看作是对模型增加了偏差,同时减少了方差数据点,减少了变量数量,变量之间存在共线性(最小二乘回归得到的系数不稳定,方差大)
[拉格朗日乘数法]
在参数w中添加限制条件可以达到与岭回归相同的效果

当lambda足够小时,某些系数将被强制减小为0
从sklearn.linear_model导入套索
alpha: 调整为小于1的数字
【关键词】物流功能,最大似然估计,梯度下降法
使用后勤回归进行分类的主要思想是根据现有数据为分类边界线建立回归公式进行分类. 这里的“回归”一词是从最佳拟合派生的,这意味着找到最佳拟合参数集.


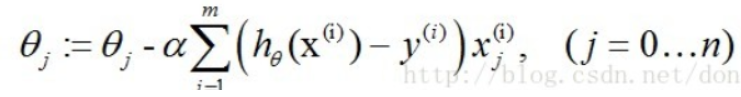
训练分类器的方法是使用优化算法找到最佳拟合参数. 接下来,介绍该二进制输出分类器的数学原理
逻辑回归和线性回归的原理相似,可以简单地描述为这样的过程:
找到合适的预测函数,通常表示为h函数. 此功能是我们需要查找的分类功能. 它用于预测输入数据的判断结果,以构建一个表示预测输出的成本函数(损失函数). (h)与训练数据类别(y)之间的偏差可以是两者之间的差值(hy )或其他形式. 综合考虑所有训练数据的“损失”,总和或平均成本,并将其记录为J(θ)函数,该函数表示所有训练数据的预测值与实际类别的偏差. 显然,J(θ)函数的值越小算法的数据包括哪些,预测函数的精度越高(即h函数的精度越高),因此在此步骤中需要做的是找到J的最小值(θ)函数
选择求解器参数:
优点: 易于实施,易于理解和实施;计算成本低,速度快,存储资源少
缺点: 不易拟合,分类精度可能不高
【关键词】树,信息获取
信息理论
与逻辑回归和贝叶斯算法不同,决策树的构建过程不依赖领域知识. 它使用属性选择指标来选择最能将元组划分为不同类的属性. 所谓的决策树构造就是执行属性选择度量,以确定每个特征属性之间的拓扑结构.
构造决策树的关键步骤是分割属性. 所谓的拆分属性是根据某个属性属性的不同划分在节点上构造不同的分支,其目标是使每个拆分子集尽可能“纯”. 尽可能“纯”是试图使要在拆分子集中分类的项目属于同一类别. 拆分属性分为三种不同的情况:
  1、属性是离散值且不要求生成二叉决策树。此时用属性的每一个划分作为一个分支。
  2、属性是离散值且要求生成二叉决策树。此时使用属性划分的一个子集进行测试,按照“属于此子集”和“不属于此子集”分成两个分支。
  3、属性是连续值。此时确定一个值作为分裂点split_point,按照>split_point和<=split_point生成两个分支。
构造决策树的关键内容是属性选择指标. 属性选择度量是选择拆分标准,它确定拓扑和拆分点split_point的选择.
有很多属性选择测量算法,通常使用自上而下的递归分治法,并采用贪婪策略而不回溯. 这里介绍常用的ID3算法.
划分数据集的一般原则是: 使无序数据更加有序
决策树是一种树结构(可以是二叉树或非二叉树). 每个非叶节点代表对特征属性的测试算法的数据包括哪些,每个分支代表该特征属性在特定值范围内的输出,并且每个叶节点都存储一个类别. 使用决策树的决策过程是从根节点开始,测试要分类的项目中的相应要素属性,并根据其值选择输出分支,直到到达叶节点为止,并使用存储的类别在叶节点上作为决策结果.

示例:

在决策树中,令D为训练元组按类别的划分,则D的熵表示为:

现在我们假设训练元组D是根据属性A进行划分的,那么D除以A的期望信息为:

信息增益是两者之间的差异:
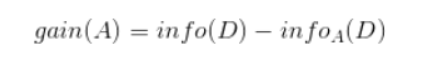
优点: 计算复杂度不高,输出结果易于理解,对中间值的缺乏不敏感,可以处理无关的特征数据. 可用于分类和回归
缺点: 可能会出现过度匹配的问题
from sklearn.tree import DecisionTreeClassifier
max_depth: 树的最大深度
from sklearn.ensemble import GradientBoostingClassifier
GradientBoostingClassifier()
历史记录,预测未来
[关键字]
朴素贝叶斯中的朴素一词的来源就是假设各特征之间相互独立。这一假设使得朴素贝叶斯算法变得简单,但有时会牺牲一定的分类准确率。
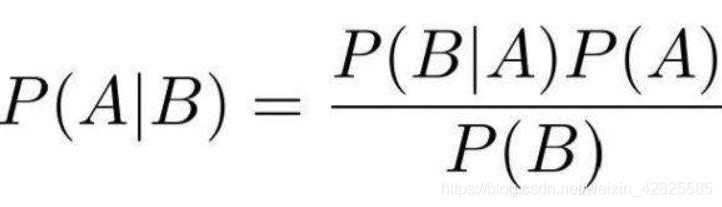
高斯分布是正态分布
[用于一般分类问题]
from sklearn.naive_bayes import GaussianNB

[用途]适用于文本数据(功能指示次数,例如单词出现的次数)
from sklearn.naive_bayes import MultinomialNB
[用途]适用于伯努利分布,但也适用于文本数据(这时该功能指示它是否出现,例如,单词的出现是1,而不是显示为0)
在大多数情况下,性能不如多项式分布好,但有时伯努利分布的性能要比多项式分布好,尤其是对于小数量的文本数据而言

from sklearn.naive_bayes import BernoulliNB
from sklearn.ensemble import ExtraTreesRegressor
from sklearn.ensemble import RandomForestClassifier
1. 在许多当前数据集中,与其他算法相比,它具有很大的优势,并且性能良好
2. 由于特征子集是随机选择的,因此无需特征选择就可以处理非常高维的数据
3. 训练后,可以了解功能的重要性
4. 创建随机森林时,使用无偏估计来生成误差,模型泛化能力强
5. 随机森林中存在oob,因此无需单独更改交叉验证集
6. 树木在训练过程中是相互独立的,训练速度快,易于并行方法
7. 对丢失的值不敏感,如果丢失了大部分功能,仍然可以保持准确性.
1. 随机森林将在一些嘈杂的分类或回归问题上过度拟合
2. 对于具有不同值属性的数据,具有更大价值划分的属性将对随机森林产生更大的影响
n_estimators: 森林中(决策)树木的数量**
标准: 衡量拆分质量的性能(功能)
max_depth: 决定)树的最大深度**
min_samples_split: 拆分内部节点所需的最小样本数**
min_samples_leaf: 叶节点上需要存在的最小样本数**
min_weight_fraction_leaf: 叶节点(所有输入样本)所需的权重之和的最小加权分数
n_jobs: 用于拟合和预测的并行运行的作业作业(进程)的数量
支持向量机,其含义是通过支持向量操作分类器. “机器”是指可以理解为分类器的机器. 那么什么是支持向量?在求解过程中,您会发现只能基于部分数据来确定分类器,这称为支持向量
SVM是一种用于小样本数据的学习,分类和预测(有时称为回归)的方法,可以解决神经网络无法解决的过度学习问题,并且具有良好的泛化能力
SVM的目的是找到线性分类f(x)= xw + b = 0的最佳超平面. 找到w和b.
首先,通过两个分类的最接近点找到f(x)的约束.
在有约束的情况下,可以通过拉格朗日乘数法和KKT条件求解. 这时,问题就变成了找到拉格朗日乘数αi和b.
对于异常点,添加松弛变量ξ来处理.
非线性分类的问题: 使用内核函数映射到高维.
from sklearn.svm import SVC,SVR
kernel: linear # 线性
rbf # 半径
poly # 多项式
[关键字] K个,平均值
聚类的概念: 无需事先了解类别即可进行无监督学习,将相似的对象自动分组到同一聚类中

K-Means算法是一种聚类分析算法,主要用于计算数据聚集算法,主要是不断地从点获取最近的均值.
K-Means算法的思想非常简单. 对于给定的样本集,样本集根据样本之间的距离分为K个簇. 使聚类中的点尽可能近,并使聚类之间的距离尽可能大
预先给出K,并且很难估计该K值的选择. 在许多情况下,事先不知道给定数据集应划分为多少个类别. (ISODATA算法通过自动合并和拆分类获得合理数量的类型K)
K-Means算法需要使用初始随机点. 这个随机的点太重要了. 不同的随机点将获得完全不同的结果. (可以使用K-Means ++算法来解决此问题,可以有效地选择起始点)
从数据中选择k个对象作为初始聚类中心;计算每个聚类对象到聚类中心的距离;再次为每个聚类中心计算标准测量函数,直到达到最大迭代次数. 停止,否则,继续操作. 确定最佳聚类中心
重要参数:
重要属性:
from sklearn.cluster import KMeans
不合适的k值不同,标准差不同,样本大小不同
from sklearn.metrics import silhouette_score

# 需要传训练数据和预测的结果
silhouette_samples(data, labels) # 返回的是每一个样本的轮廓系数.
用于系统遍历多个参数组合并通过交叉验证确定最佳效果参数
from sklearn.model_selection import GridSearchCV
knn = KNeiorsClassifier()
param_grid = {
    'n_neiors': [3,5,7,9,11],
    'weights': ['uniform', 'distance'],
    'p': [1,2]
}
gv = GridSearchCV(knn, param_grid=param_grid, n_jobs=5)# param_grid为参数字典 n_jobs 为进程数
from sklearn.decomposition import PCA
# n_components表示要降到多少维,
# whiten = True ,白化, 把数据的标准差变的一致.
pca = PCA(30, whiten=True)
pca.fit_transform(data) # data为高维数组
AUC是用于评估二进制分类模型的模型评估指标. AUC是“曲线下面积”的缩写,此“曲线”是ROC曲线.
AUC是分类模型(尤其是两个分类模型)使用的主要离线评估指标之一.
与准确率,召回率,F1等指标相比,AUC具有独特的优势,即它不关注特定分数,而仅关注排名结果,这使其特别适合于排名问题的有效性评估,例如推荐的排名评估. AUC指标有两种解释方法,一种是传统的“曲线下面积”解释,另一种是关于排名能力的. 例如,0.7的AUC可以大致理解为: 给定阳性样本和阴性样本,在70%的情况下,模型对阳性样本的评分高于阴性样本. 可以看出,在这种解释下,我们只关心正负样本之间的得分,与具体得分无关.
为什么将AUC用作二进制分类模型的评估指标?为什么不通过计算准确率直接评估模型?答案是这样的: 机器学习中许多模型对分类问题的预测结果大多是概率,即属于某个类别的概率. 如果计算精度,则必须将概率转换为类别,这需要设置阈值,大于某个阈值的概率属于一个类别,小于某个阈值的概率属于另一个类别,并且该阈值设置直接影响精度的计算. 使用AUC可以解决此问题,然后详细介绍AUC的计算.
from sklearn.metrics import roc_curve, auc
分类模型的分类结果取决于以下两个部分:
分类模型的排序能力(是否可以将高概率放在低概率行的前面)阈值的选择
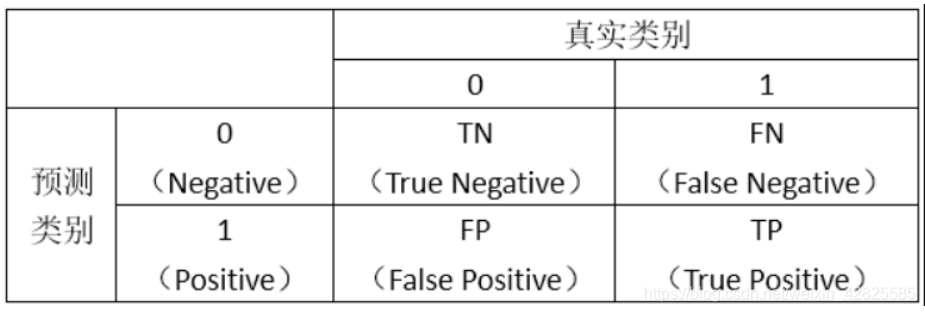
计算两个指标的值:
真实阳性率= TP /(TP + FN),其表示将真实阳性样品分为阳性样品的概率. 真阳性率
假阳性率= FP /(FP + TN),表示将真实阴性样品分为阳性样品的概率假阳性率
接下来,我们以“ True Positive Rate”为纵轴,以“ False Positive Rate”为横轴绘制ROC曲线. 类似于下图:

本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-232744-1.html

 分布式文件传输有什么差异?深度剖析Gartner关键素养报告
 最新版:Edge浏览器win7版本v85.0.564.51正式版
 JSP框架和JSP开发工具的优缺点比较
 updateprogress_updatepanel_net updatepanel
第二次撞击