在正则表达式中组织使用问号
电脑杂谈 发布时间:2020-05-30 00:12:18 来源:网络整理
我每次看到它时,都会想到什么?在正则表达式和包含?的特殊字符中,我的脑海里一片混乱.
今天,我特意搜索了相关书籍并将它们清楚地分开.
(?: )
(?=)
(?<=)
(?<!)
(?!)
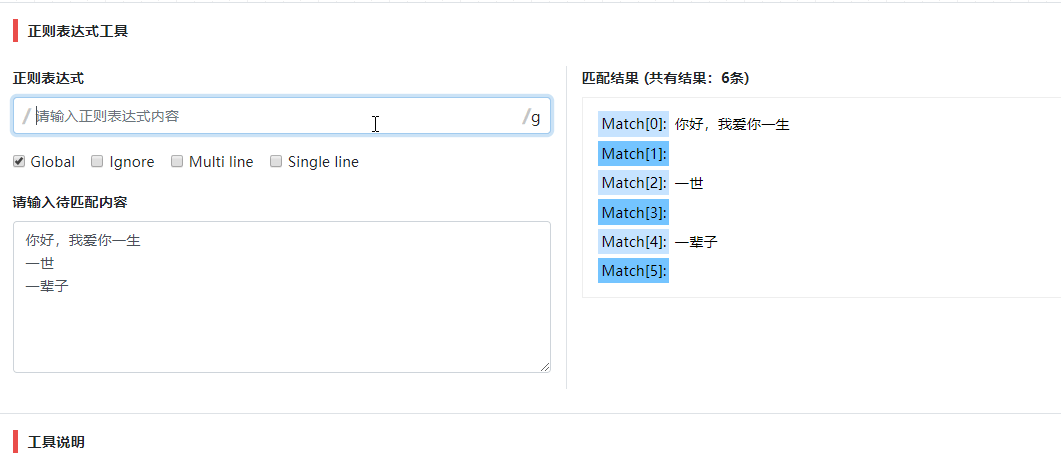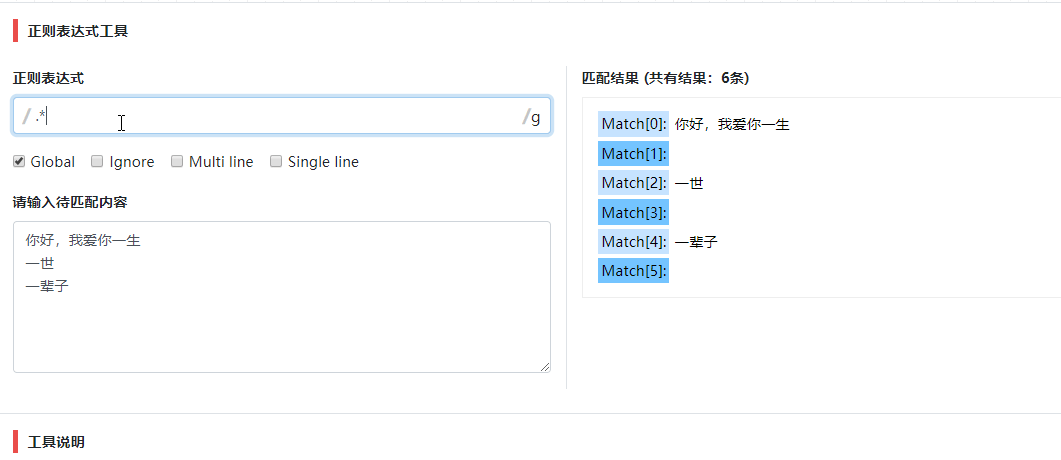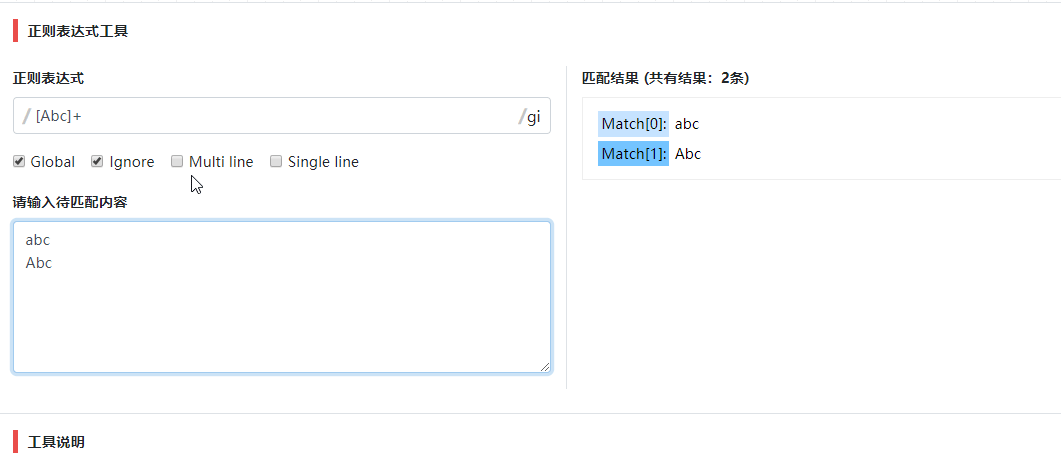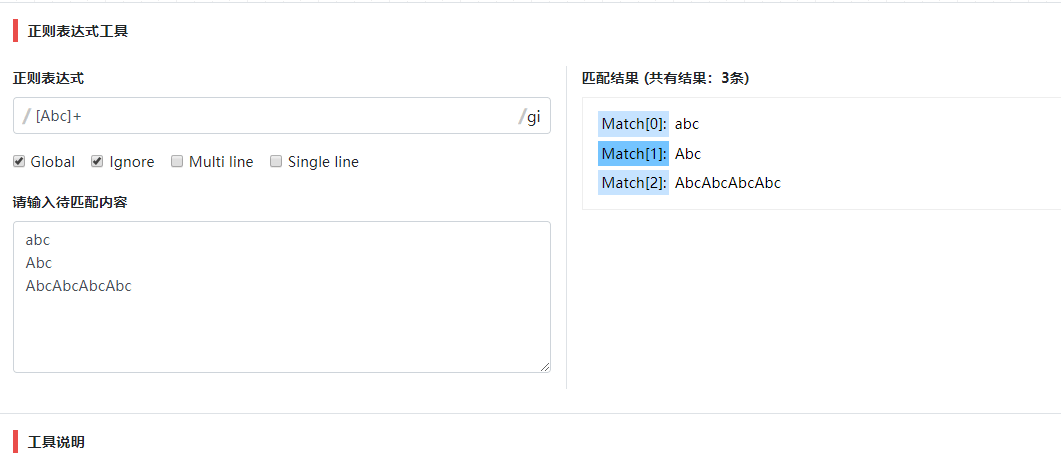
第一个?代表量词,它前面的字符不能出现,或者只能出现一次(单个可选)
示例如下: 两个字符串都将匹配
#! / usr / bin / perl
$ str =“ zhengzebiaodashi”;
$ str2 =“ zhenzebiaodashi”;
if($ str =〜/ zheng?/ g){
打印“匹配\ n”;
}其他{
打印“不匹配\ n”;
}
if($ str2 =〜/ zheng?/ g){
打印“匹配\ n”;
}其他{
打印“不匹配\ n”;
}
单个问号的另一含义
单个问号在+,*等其他量词中使用,表示非贪婪模式
非贪婪模式将尝试至少匹配以使整个表达式成功匹配. 以下是文本“ dxxxdxxxd”的示例:
表达匹配结果
(d)(\ w +?)“ \ w +?”将在第一个“ d”之后匹配尽可能少的字符,结果是: “ \ w +?”仅匹配一个“ x”
(d)(\ w +?)(d)为了使整个表达式成功匹配,请使用“ \ w +?”. 必须匹配“ xxx”以匹配后面的“ d”正则表达式匹配问号,以便整个表达式成功匹配. 因此,结果是: “ \ w +?”匹配“ xxx”
第二个(?:)表示不捕获括号,仅分组而不捕获
示例如下: 不带((: :)和(?:)的$ 1,$ 2的输出不同
#! / usr / bin / perl
$ str1 =“正则表大石”;
$ str2 =“正则表大石”;
如果($ str1 =〜/(\ w +)\ s +(\ w +)\ s +(\ w +)\ s + / g){
打印“ $ 1 $ 2 \ n”;
}
如果($ str2 =〜/(?: \ w +)\ s +(\ w +)\ s +(\ w +)\ s + / g){
打印“ $ 1 $ 2 \ n”;
}
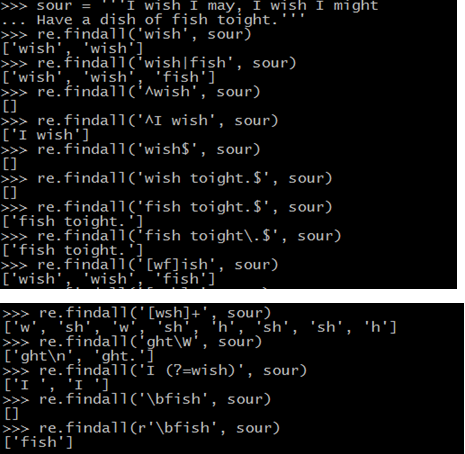
这是环顾四周的四种类型,

(?=)肯定顺序环顾四周
(?<=)肯定以相反的顺序环顾四周
(?<!)反向反转顺序查看
(?!)以负序环顾四周
环顾四周结构不匹配任何字符正则表达式匹配问号,仅匹配文本中的特定位置,不容易理解,仅找到一个示例
在数字的特定位置添加逗号
#! / usr / bin / perl
$ str =“ 298444215”;
$ str =〜s /(?<= \ d)(?=(\ d \ d \ d)+ $)/,/ g;
打印$ str;
输出结果: 298,444,215
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-227007-1.html
-

-
张星慧
它们敢来
 windows 内核编程黑客..黑客.微信:
 HBV DNA定量检测的正常范围是什么
 部: 要花三年时间才能实现国家户口和公民编号的唯一性
 原版镜像和Ghost差别很大吗?Ghost系统与原版系统的区别
我们公司已经拖欠4个月工资了