数据结构和算法安排的摘要---二叉搜索树
电脑杂谈 发布时间:2020-05-26 23:15:24 来源:网络整理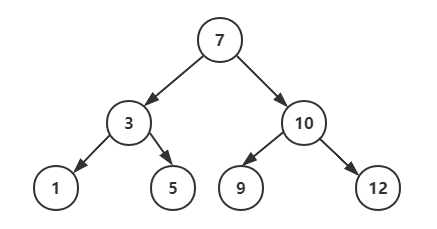
分支搜索树是分支树中最常用的类型,也称为分支搜索树. 顾名思义,fork搜索树用于快速搜索. 但是,它不仅支持快速查找一条数据,而且还支持快速插入和删除一条数据.
所有这些都取决于二进制搜索树的特殊结构. 交叉搜索树要求,对于树中的任何节点,左子树中每个节点的值必须小于此节点的值,而右子树节点的值必须大于此节点的值.

1. 叉子搜索树的搜索操作
首先,让我们看看如何在派生搜索树中查找节点. 我们首先获取根节点,如果它等于我们要查找的数据,则返回. 如果要查找的数据小于根节点的值,则在左侧子树中进行递归搜索;如果要查找的数据大于根节点的值,则在右子树中递归搜索.

2. 叉子搜索树的插入操作
fork搜索树的插入过程在某种程度上类似于搜索操作. 新插入的数据通常在叶节点上,因此我们只需要从根节点开始,并按顺序比较要插入的数据和该节点之间的关系即可.
如果要插入的数据是节点的数据大小,并且该节点的右子树为空,则将新数据直接插入到右子节点的位置;如果不为空,则递归遍历右侧子树查找插入位置. 同样,如果要插入的数据小于节点值,并且节点的左子树为空,则将新数据插入到左子节点的位置;否则,将新数据插入到子节点的位置. 如果不为空,则递归遍历左侧子树以找到“插入位置”.

3. 叉搜索树的删除操作
交叉搜索树的搜索和插入操作相对简单易懂,但其删除操作则更为复杂. 针对要删除的子节点数量的差异,我们需要在三种情况下进行处理.
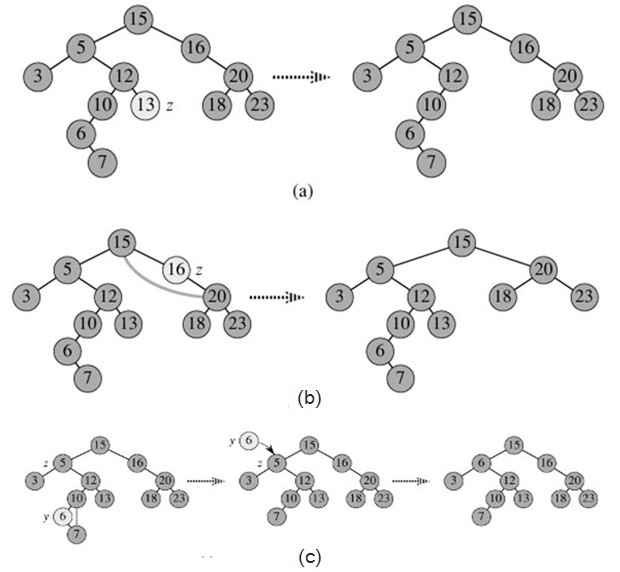
第一种情况是,如果要删除的节点没有子节点,我们只需要直接将指向要删除的节点的指针从该节点设置为null. ≐如图所示删除节点55.
第一种情况是,如果要删除的节点只有一个子节点(只有左子节点或右子节点),我们只需要更新指向该节点中要删除的节点的指针,使其指向节点节点的子节点就足够了. ‐如图所示,删除节点13.
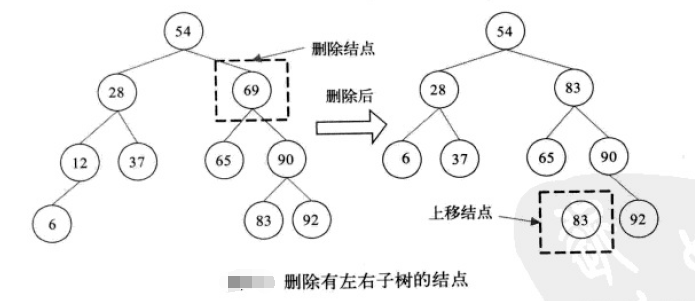
第三种情况是,如果要删除的节点有两个子节点,则更为复杂. 我们需要在该节点的右子树中找到最小的节点,并将其替换为要删除的节点. 然后删除这个最小的节点,因为最小的节点一定不能有一个左节点(如果有一个左节点二叉排序树查找 算法,则它不是最小的节点),因此我们可以应用上面的两个规则来删除这个最小的节点Small节点. 如图所示,删除节点18.

实际上,有一种非常简单而巧妙的方法来删除fork搜索树,即只是将要删除的节点标记为“已删除”,但实际上并没有从树中删除该节点. 去掉. 这样,原始删除的节点仍然需要存储在内存中,这浪费了存储空间,但是删除操作变得更加简单. 而且,这种处理方法不会增加插入和搜索操作码的难度.
4. fork搜索树的其他操作
除了插入,删除和搜索操作外,子搜索树还可以快速搜索最大节点和最小节点,前任节点和后继节点.
除了支持先前的操作外,fork搜索树还具有重要的功能,即fork搜索树的中阶遍历可以输出有序数据序列,时间复杂度为O(n) ,并不总是有效的. 因此,分叉搜索树也称为分叉排序树.
当我们谈论fork搜索树时,树中的节点默认存储数字. 很多时候,在实际的软件开发中,我们将具有多个字段的对象存储在fork搜索树中. 我们使用对象的字段作为关键字来构造派生搜索树. 我们将目标卫星数据中的其他字段称为
.
我们之前讨论的fork搜索树的操作是针对没有相同键值的情况. 如果存储的两个对象具有相同的键值,该如何处理?
第一种方法更容易. 分叉搜索树中的每个节点不仅将存储一个数据,因此我们通过链接列表和支持数组动态扩展的数据结构将具有相同值的所有数据存储在同一节点上.

第二种方法较难理解,但更优雅.
每个节点仍然只存储一个数据. 在搜索插入位置的过程中,如果遇到某个节点的值,该值与要插入的数据的值相同,我们会将要插入的数据放入该节点的右子树中,即是,把此新插入的数据视为大于此节点的值.

当我们寻找数据时,我们遇到具有相同值的节点. 我们不会停止搜索操作. 我们继续在右边的子树中搜索,直到遇到叶子子节点. 这样,可以找到所有键值等于要找到的值的节点.

对于删除操作,我们还需要首先找到要删除的每个节点,然后根据上述删除操作的方法将其逐个删除.

您应该很好地了解fork搜索树的常见操作的实现. 现在,让我们分析fork搜索树的插入,删除和搜索操作的时间复杂性.

实际上,有多种形式的子搜索树. 如此图所示,对于相同的数据集,我们构造了三种类型的二进制搜索树. 它们的搜索,插入和删除操作的效率都不同. 在图中的第一种分叉搜索树中,根节点的左右子树非常不平衡,并退化为链接列表,因此搜索的时间复杂度变为O(n).

我只是分析了最坏的情况之一. 让我们分析最理想的情况. 叉子搜索树是完整的叉子树(或完整的叉子树). 此时,插入,删除和搜索的时间复杂度是多少?
在前面的示例和图中,无论操作是插入,删除还是搜索,时间复杂度实际上都随着树的高度为O(高度)而为正.
哈希表的插入,删除和搜索操作的时间复杂度可以是常数O(1),这并不总是有效的. 在更平衡的情况下,插入,删除和搜索操作的时间复杂度为O(logn). 与哈希表相比,似乎没有优势. 那为什么要使用叉子搜索树呢?什么?
首先,哈希表中的数据按顺序存储. 如果要输出排序的数据,则需要高级排序. 对于二叉搜索树,我们只需要进行中序遍历即可输出O(n)时间复杂度内的有序数据序列.
首先,哈希表扩展会花费大量时间,并且在遇到哈希冲突时,性能会不稳定. 尽管fork搜索树的性能不稳定,但在此过程中,我们最经常使用的平衡是fork搜索树的性能并不总是稳定的,时间复杂度稳定在O(logn).
第三,通常,虽然诸如哈希表搜索之类的操作的时间复杂度是恒定的,但是由于存在哈希冲突,该常数不是固定的,因此实际搜索速度可能不确定,O(logn )很快. 再加上耗时的哈希函数,并非总是能够平衡二分搜索树的效率.
第四,哈希表和交叉查找树的构造很复杂,需要考虑很多因素. 例如散列函数的设计,冲突解决方法,扩展,缩小等. 平衡搜索树仅需要考虑平衡问题,并且该问题的解决方案相对成熟和固定.
最后,为了避免过多的哈希冲突二叉排序树查找 算法,哈希表加载因子不能太大,尤其是基于开放式寻址方法解决冲突的哈希表,否则会浪费一定的存储空间.
此作品采用“抄送协议”,转载时必须注明作者和本文的链接
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-223367-1.html
-

-
明景帝
从去年开始不再喝了
-
玛丽莲梦露
能怎么样
 用盗号软件盗qqtxt_qq被盗号怎么盗回来_盗号高手qq免费盗号
 关于计算机网络路由器的应用论文
 植物大战与僵尸花园大战计算机版下载
 走进深圳超级计算中心,揭开世界上第四台超级计算机“星云”的曙光
一如既往风格独特