火花知识和环境设置并运行第一个Spark程序
电脑杂谈 发布时间:2020-05-26 03:04:46 来源:网络整理
摘要: 由于内存计算的特性,作为新一代大数据计算引擎,Spark具有比hadoop更快的计算速度. 这里总结了对Spark的理解,虚拟机Spark的安装,Spark开发环境的构建以及第一个scala程序的准备以及第一个Spark程序的运行.
Spark是一个快速而通用的集群计算平台
1)火花很快
Spark扩展了流行的Mapreduce计算模型
Spark是基于内存的计算
2)Spark是通用的
Spark的设计可以容纳其他分布式系统的功能
批处理,迭代计算,交互式查询和流处理等
3)Spark高度开放
Spark提供Python,Java,Scala,SQL API和丰富的内置库.
Spark与hadoop,kafka等其他大数据工具很好地集成在一起.
Spark包含多个紧密集成的组件
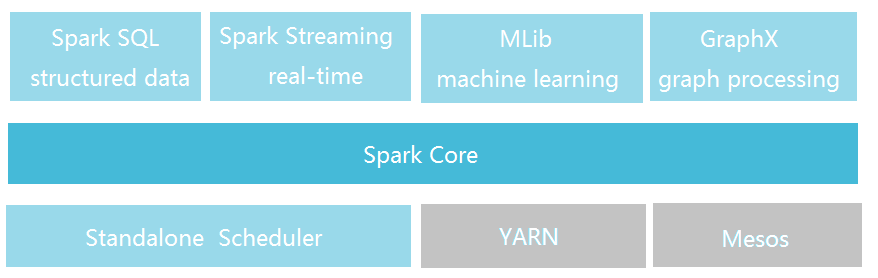
火花核心:
包含Spark的基本功能,包括任务调度,内存管理,容错机制等.
RDD(弹性分布式数据集)在内部定义
提供许多API来创建和操作这些RDD
为其他组件提供底层服务的应用场景
Spark SQL:
Spark是一个用于处理结构化数据的库,就像Hive SQL和Mysql
应用方案,用于报告企业中的统计信息

火花流:
它是实时数据流处理组件,类似于Storm
Spark Streaming提供了用于处理实时流数据的API
应用场景,用于企业从Kafka接收数据以进行实时统计
MLlib:
包含通用机器学习功能的软件包,机器学习库
包括分类,聚类,回归等,包括模型评估和数据导入.
MLlib提供的上述方法支持集群上的水平扩展.
应用场景,机器学习.
Graphx:
是用于处理图(例如,社交网络图)和图的并行计算的库.
类似于Spark Streaming和Spark SQL,它还继承了RDD API.
它提供了各种图形操作以及常用的图形算法,例如PangeRank算法.
应用场景,图形计算.
集群管理器:
是集群管理. Spark带有一个群集管理,该群集管理是一个单独的调度程序.
公用集群管理包括Hadoop YARN,Apache Mesos
Spark的底层已经过优化,基于Spark底层的组件也已得到相应的优化.
紧密集成,可以在组合使用各种组件时节省部署和测试的时间.
向Spark添加新组件时,其他组件可以立即享受新组件的功能.
Hadoop应用场景: 离线处理,及时性要求低
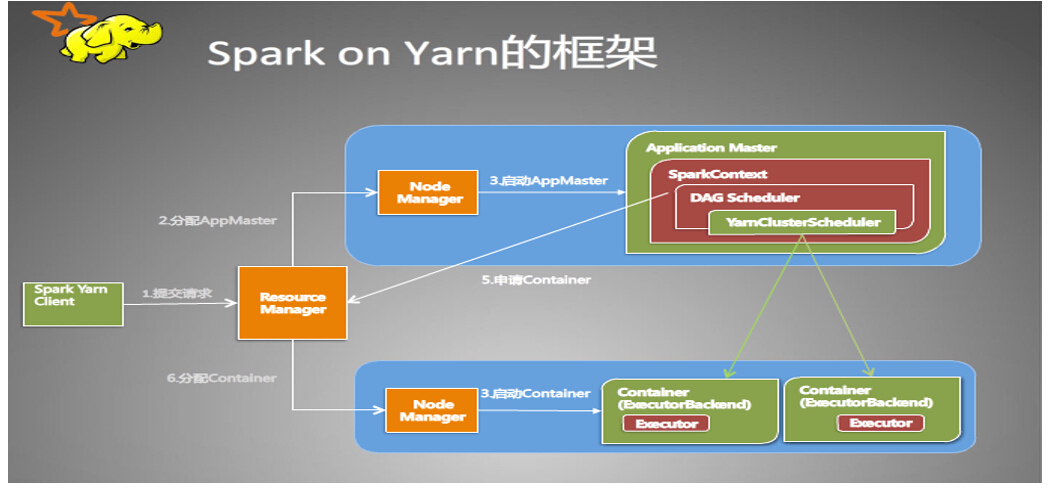
Spark应用程序场景: 具有高及时性要求,机器学习和其他领域的场景
Doug Cutting的观点: 这是一个生态系统,每个组成部分都有其作用,每个组成部分都可以很好地发挥作用. Spark没有HDFS的存储容量,它必须依赖于持久数据,例如HDFS. 大数据将孕育更多的新技术.
Spark由Scala编写,并且在JVM上运行,因此操作环境为Java7 +
如果使用Python API,则需要安装Python2.6 +或Python3.4 +
版本对应: Spark1.6.2-Scala2.10 Spark2.0.0-Scala2.11
Spark下载地址: 注意: Spark不需要Hadoop,如果您拥有hadoop集群,则可以下载相应的版本.
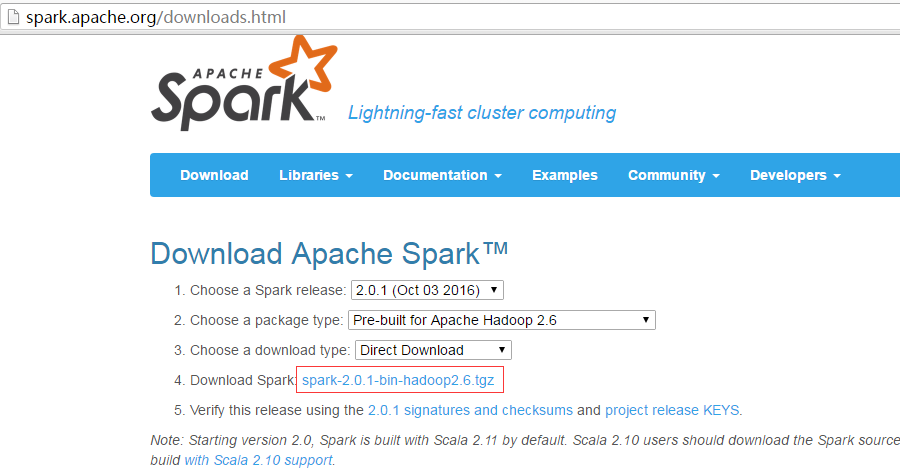
此文件安装在CentOS6.5虚拟机上,将下载的文件上传到虚拟机,然后执行解压缩: tar -zxvf spark-2.0.1-bin-hadoop2.6.tgz
火花目录:
bin包含用于与Spark交互的可执行文件,例如Spark shell.
示例包含一些独立的Spark作业,您可以研究并运行这些示例.
火花壳:
Spark的外壳程序可以处理分布在集群上的数据.
火花将数据加载到节点的内存中,因此可以在几秒钟内完成分布式处理.
快速使用迭代计算,通常可以在shell中完成实时查询和分析.
Spark提供了Python shell和Scala shell.
这里以Scala shell为例,演示了如何读取和操作本地文件:
输入Scala shell: ./ spark-shell
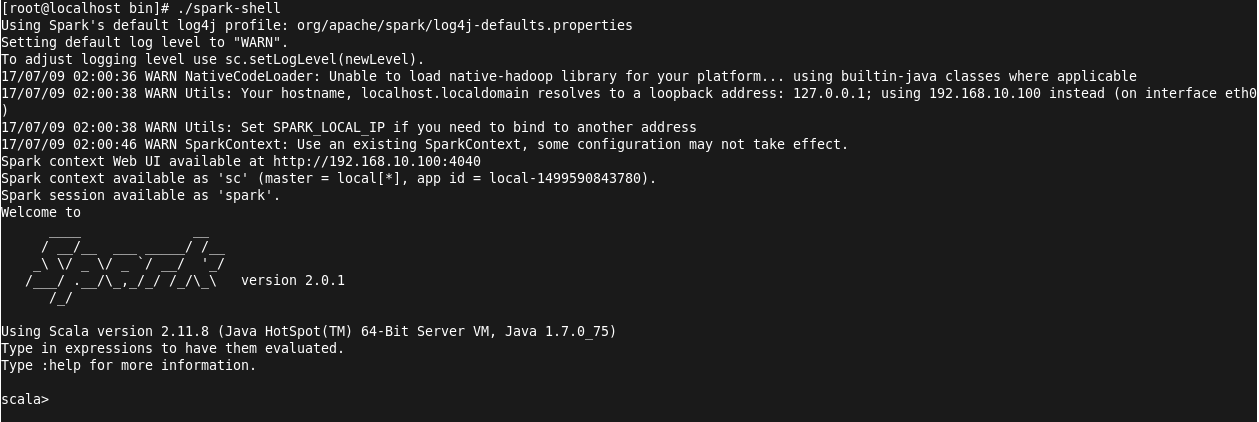
创建一个测试文件helloSpark并输入内容:
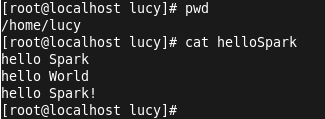
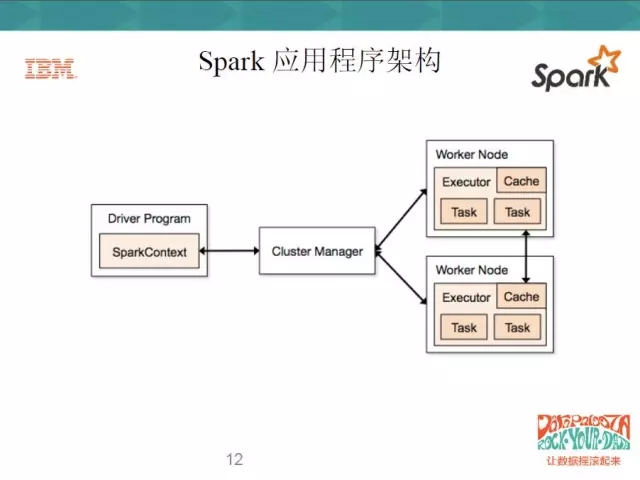
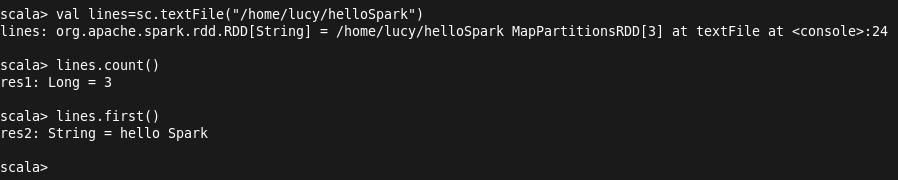
输入val行= sc.textFile(“ / home / lucy / hellospark”)来加载文件内容,输入lines.count()来计算行数: (注意: sc是spark内容)
ssh配置: (ssh本地主机需要密码,而在运行spark程序时是不可能的)
ssh-keygen(密钥生成)
.ssh目录中的
cat xxx_rsa.pub> authorized_keys
chmod 600授权密钥
Scala下载地址: 注意: 默认安装选项将自动配置环境变量,并且安装路径中不能有空格.
IntelliJ IDEA下载地址:
注册码地址:
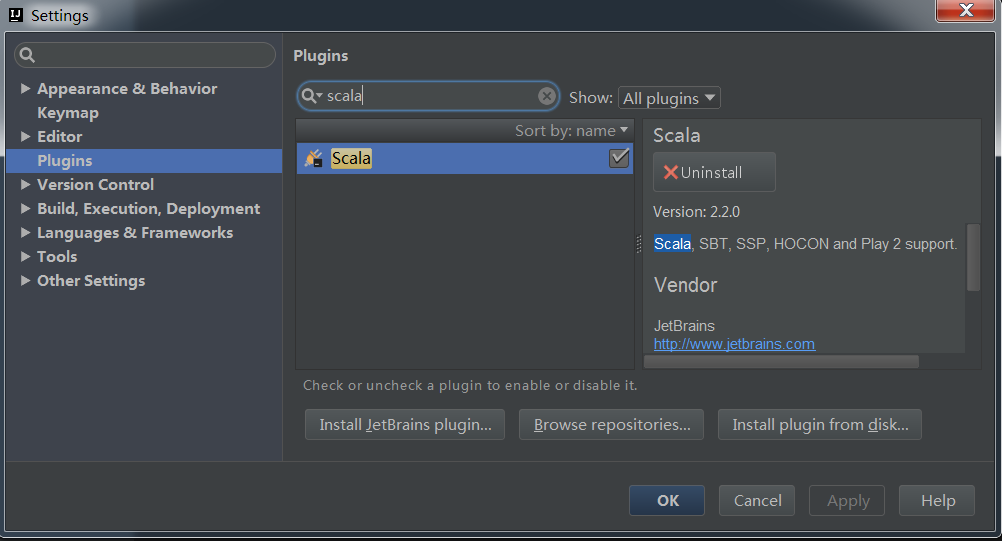
由于此处下载的ideaIU-15.0.2.exe已经包含Scala插件,因此,如果没有,则需要下载它. 要查看是否有用于创建新项目的scala插件,请打开“文件”->“设置”并选择“插件”,然后输入scala进行查看:
依次单击文件->新建->项目,选择Scala-> SBT,下一步,打开以下窗口:
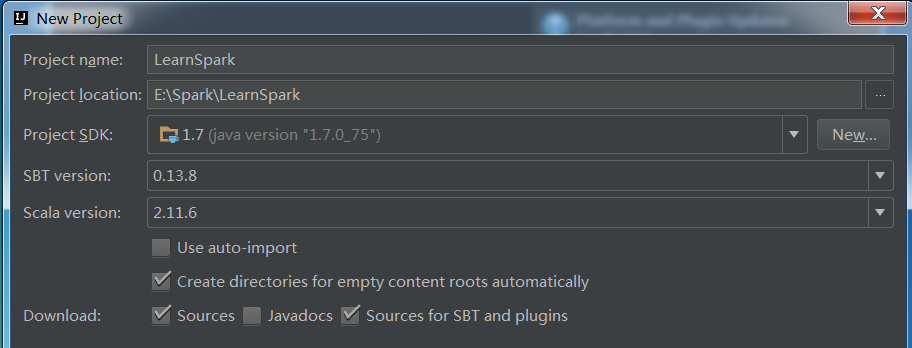
在此处将Scala选择为2.11.6,创建完成后,将执行初始化操作,并且将自动下载jar包. 下载通常取决于特定的网络情况. 完成所有进度条后,项目目录如下所示:
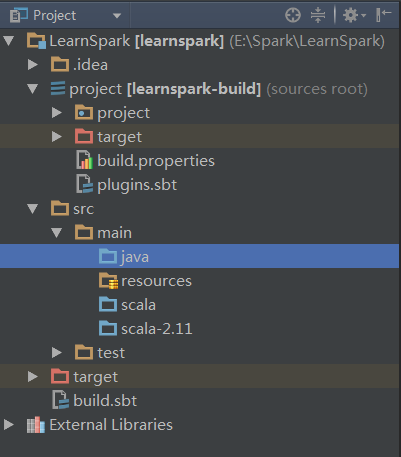
编辑build.sbt:
名称: =“ LearnSpark”
版本: =“ 1.0”
scalaVersion: =“ 2.11.1”
libraryDependencies + =“ org.apache.spark”%“ spark-core_2.11”%“ 2.0.2”

编辑后spark程序入口,单击刷新,相应的依赖项将在后台自动下载:

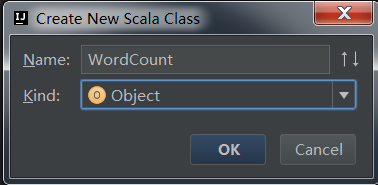
src-> scala右键单击以创建一个新的scala类WordCount
import org.apache.spark.{SparkContext, SparkConf}
/**
  * Created by Lucy on 2017/7/4.
  */
object WordCount {
  def main(args: Array[String]) {
    val conf=new SparkConf().setAppName("wordcount")
    val sc=new SparkContext(conf)
    val input=sc.textFile("/home/lucy/helloSpark")
    val lines=input.flatMap(line=>line.split(" "))
    val count=lines.map(word=>(word,1)).reduceByKey{case (x,y)=>x+y}
    val output=count.saveAsTextFile("/home/lucy/hellosparkRes")
  }
}
编写代码后,将其打包(配置jar包,构建):
配置jar包: File-> Project Structure,选择Artifacts,单击+号:
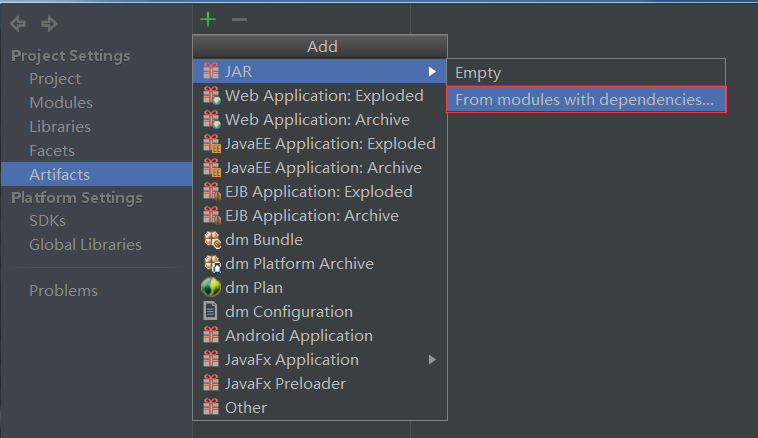

取决于此处的包装. 配置jar包后,请依次执行Build-> BuildArtifacts,并等待构建完成.
这里您需要先启动集群:
启动主服务器: ./sbin/start-master.sh
开始工作的工人: ./bin/spark-class org.apache.spark.deploy.worker.Worker spark: //本地主机: 7077
这里的地址是: 启动主服务器后spark程序入口,在浏览器中输入localhost: 8080以查看主服务器地址

成功启动后,jps查看过程:
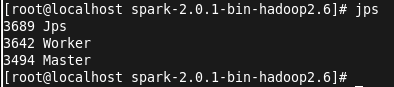
接下来执行Submit命令,将jar包上传到linux目录. jar包位于项目目录中的\工件下.
提交作业: ./bin/spark-submit --master spark: //本地主机: 7077 --class WordCount /home/lucy/learnspark.jar
您可以在端口4040上查看作业进度:

查看结果:
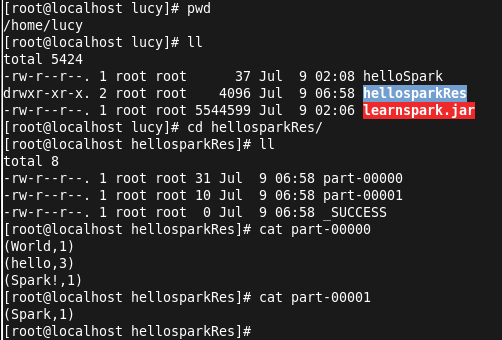
由于字符串是根据空格分割的,所以Spark!在这里被视为一个单词. 至此,任务结束了!
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-222348-1.html
-

-
岳云丽
“世界上由龙变虫的国家
 如何在单词中设置数字的千位分隔符?两种轻松完成的方式
 如何编写图书管理系统 河北宏润钢木家具
 SpringBoot AOP(方面注释方法)的详细说明
 为什么有人写计算机病毒
不行