Google文件系统GFS摘要
电脑杂谈 发布时间:2020-05-21 06:17:01 来源:网络整理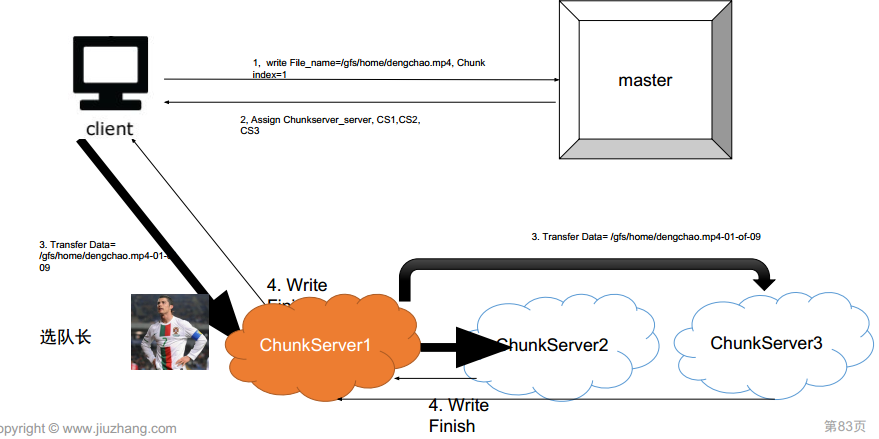
Google文件系统GFS Google设计GFS的动机是什么?为了满足Google快速增长的数据处理需求,需要支持大容量存储的文件系统吗?购买昂贵的分布式文件系统和硬件? Google设计GFS的动机是什么?为什么不同时使用现有文件系统? ? Google的问题是不同的工作量,不同的设计优先级(廉价,不可靠的硬件)?是否需要设计与Google应用程序和负载一致的文件系统GFS假设和目标?硬件错误是正常的还是非异常的?该系统应由大量廉价且易受攻击的硬件组成. 它必须保持文件系统的整体可靠性. 它主要用于批处理数据的程序处理,而不是与用户交互或随机读写数据. “插入写入”很少存储的文件大小可能约为GB或TB,并且应该能够支持存储数千个大文件吗?流数据的主要负载是读写? ??需要存储大文件吗? GFS设计原则组件故障被认为是正常事件,不是偶然事件. ?可以处理大/非常大的文件处理. ?大多数文件的修改是在文件末尾添加数据,而不是覆盖原始数据. ?应用程序和文件系统API的协同设计提高了整个系统的灵活性. ?支持大量用户同时访问. 系统交互在设计GFS系统时,重要的原则是最大程度地减少所有操作与主节点之间的交互.

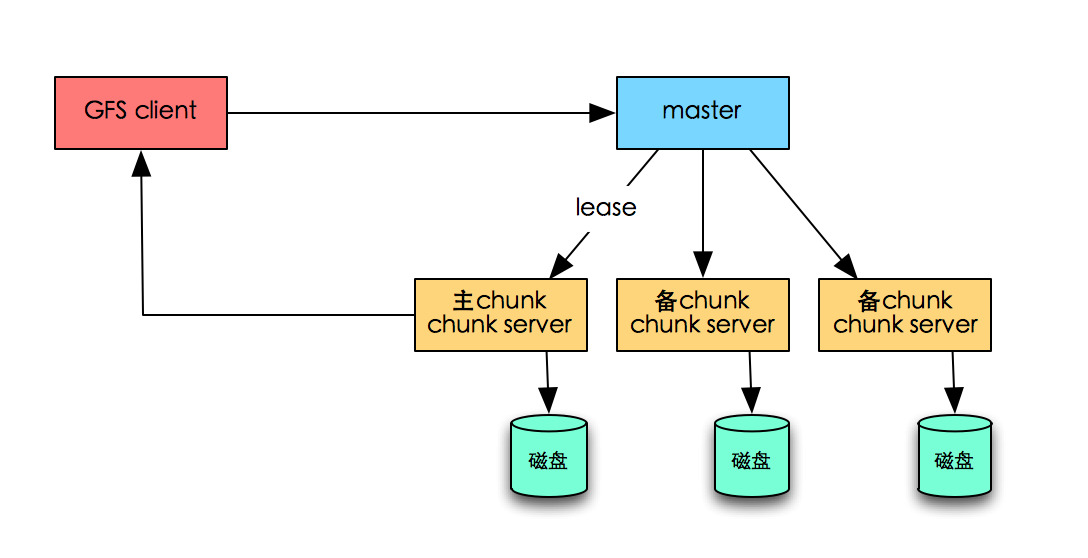
?租赁和变更单?数据流?原子记录添加?快照租用和更改顺序更改是更改块的内容或元数据的操作,例如写操作或记录添加操作. 更改操作将在块的所有副本上执行. 我们使用租约机制来维护多个副本之间变更单的一致性. 主节点设计租用机制的目的是最大程度地减少主节点的管理负担. 块的副本建立了租约,我们将此副本称为主块. 主块将所有更改序列化为块. 所有副本都按照此顺序进行修改操作. 因此,修改操作的顺序首先由主节点选择的租约顺序确定,然后由租约中主块分配的序列号确定. 租约和变更单客户端询问主节点,哪个块服务器持有当前租约以及其他副本的位置. 主节点将主块的标识符以及其他副本的位置返回给客户端. 客户端缓存此数据以用于后续操作. 客户端将数据推送到所有副本. 客户可以按任何顺序推送数据. 块服务器接收数据并将其保存在其内部LRU缓存中,直到数据被使用或过期和交换为止.

当所有副本都确认已接收到数据时,客户端会将写请求发送到主块服务器. 主块将写请求传递给所有辅助副本. 每个辅助副本根据主块分配的序列号以相同的顺序执行这些操作. 所有第二级副本都响应主块,并且它们已完成操作. 主块服务器答复客户端. 任何副本生成的任何错误都将返回给客户端. 为了提高网络效率,数据流已采取措施将数据流与控制流分开. ?当控制流从客户端到主块,再到所有第二级副本时,数据将以流水线的方式依次沿着精心选择的块服务器链推送. ?目标是充分利用每台计算机的带宽,避免网络瓶颈和高延迟连接,并最大程度地减少推送所有数据的延迟. 为了充分利用每台机器的带宽,数据将沿着Chunk服务器链顺序推送. ?为了尽可能避免网络瓶颈和高延迟链接,每台计算机都尝试选择一个未接收数据并且最接近自身的计算机作为在网络拓扑中推送数据的目标. ?使用基于TCP连接的管道数据推送以最大程度地减少延迟. •数据流S2 S3clientS1假定客户端将数据从块服务器S1推送到S4. 它将数据推送到最近的Chunk服务器S1.
S1将数据推送到S2,因为S2和S4中最接近的机器是S2. 类似地,S2将数据传递到S3和S4之间的更近的机器,依此类推. 我们的网络拓扑非常简单,并且节点的“距离”可以通过IP地址来计算. 附加原子记录?传统的写操作方式是客户端程序会指定数据写偏移量,对同一区域的并行写操作不是串行的,该区域的尾部可能包含由多个不同的客户端Fragment写入的数据. ?记录添加客户端仅需要指定要写入的数据. GFS保证至少成功执行一次原子写操作. 写入的数据将附加到GFS指定的偏移位置,然后GFS将此偏移返回给客户端. 机. 记录追加成功. 记录追加是修改操作,它也遵循前面描述的控制流程. 客户端将数据推送到文件最后一块的所有副本,然后向主块发送请求. 主块将检查此记录追加操作是否会使该块超过最大大小(64MB). 如果超过了最大大小,则主块首先将当前块填充为最大大小,然后通知所有辅助副本执行相同的操作,然后回复客户端以请求其重新记录下一个块. (附加到记录的数据大小严格控制为最大块大小的1/4,因此即使在最坏的情况下,数据片段的数量仍在可控范围内.

)通常,附加记录不超过块的最大大小. 主块将数据追加到其自己的副本中,然后通知辅助副本将数据写入与主块相同的位置,最后响应客户端操作成功. 记录追加失败如果对任何副本的记录追加操作失败,则客户端需要再次执行该操作. 作为重新添加记录的结果,同一块的不同副本可能包含不同的数据,或者重复包含记录的全部或部分数据. 一致性保证如果操作成功执行,则必须在Chunk的所有副本中将数据写入相同的偏移位置. 之后,所有副本都至少为记录结尾的长度,并且即使主节点选择了其他大块副本作为主块,所有后续记录也将追加到更大的偏移地址或其他大块中. 就一致性保证模型而言,定义了记录追加操作成功写入数据的区域(因此是一致的),反之则是不一致的(因此是未定义的). (在2.7.2中声明该程序可以处理不一致的区域). 什么是快照? SNIA(存储网络行业协会)将快照(Snapshot)定义为: 指定数据集的完全可用副本,其中包括特定时间点(复制开始的时间点)的相应数据的映像.
快照可以是其代表的数据的副本,也可以是数据的副本. 就特定的技术细节而言,快照是存储在存储设备中数据的参考标记或指针. 我们可以通过这种方式理解快照有点像详细的目录,但是计算机将其视为完整的数据备份. ??快照操作几乎可以立即完成文件或目录树(“源”)的副本,并且不会对其他正在进行的操作造成任何干扰. ?用户可以使用快照快速创建海量数据集的分支副本(通常是递归副本),也可以使用快照操作在进行实验性数据操作之前备份当前状态gfs文件系统特点,以便他们可以轻松地提交或回滚到. 备份时的状态. 用于快照的技术使用标准的COW(写时复制)技术. 含义是: 复制对象时,它实际上并不是将原始对象复制到内存中的另一个位置,而是在新对象的内存映射表中设置一个指针,指向源对象的位置,然后将其放到块存储器的Copy-OnWrite位设置为1. 当您还在上学时,父母希望您看电视而不是查看作业,因此您将自己关在房间里并查看作业. ,实际上,您正在做其他事情,例如给班上的一个女孩写一封情书,而当您的父母出来在您的房间里检查您是否正在复习时,您真的会拿起教科书来阅读.
这是一种“延迟策略”,只有在必须执行时才执行. 当然,这种事情经常发生在现实生活中,但是它已经成为编程世界中最有用的技术. 就像可以在C ++中到处声明的变量的特性一样,ScottMeyers建议我们仅在存储空间时才真正需要声明变量(分配内存),这将在运行时获得程序的最小内存成本. 在执行之前分配内存将花费一些时间,这将使我们的程序在运行时具有更好的性能. 毕竟,20%的程序有80%的时间运行. 当COW技术对新对象执行读取操作时,存储数据不会更改,并且直接执行读取操作;当对新对象执行写操作时,会将实际对象复制到新的内存地址并进行修改. 新对象的内存映射指向该新位置,并在新的内存位置上执行写操作. 该技术需要与虚拟内存和页面调度同时使用. 优点是执行复制操作时它不是真正的内存复制,而仅创建了一个指针,从而大大提高了效率. 但这并非总是如此. 复制新对象后,大多数对象仍需要继续写操作gfs文件系统特点,这将导致大量页面错误,这是不值得的. 因此,仅在复制新对象并写入一小部分内存页之后,COW才有效. 如何实现快照当主节点收到快照请求时,它首先取消快照文件所有块的租用.
此措施可确保对这些块的所有后续写入操作都必须与主服务器交互才能找到租约持有人. 这使主节点有机会首先创建块的新副本. 租约被取消或到期后,主节点以日志形式在硬盘上记录此操作. 然后,主节点通过复制源文件或目录的元数据,将该日志记录中的更改反映到存储在内存中的状态. 新创建的快照文件和源文件指向完全相同的块地址.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-217414-1.html
-

-
孙丽
-
奈常委
现在的国家
 蓝月亮洗衣液区域经销商代理商价格表
 基于区块链的分布式云计算简介
 34064653的博客
 已无实体 家居“新零售”究竟是什么 卫浴企业能否赶上?
中国在二十年內都还没这能力