什么是hadoop: 分布式系统基础架构
电脑杂谈 发布时间:2020-05-21 01:24:19 来源:网络整理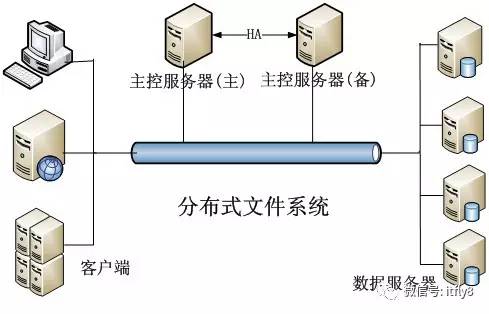
/ enpproperty->
什么是hadoop? hadoop可以拥有哪些应用程序? hadoop和大数据之间是什么关系?下面我们将详细介绍这些问题.
什么是hadoop?
Hadoop是Apache基金会开发的分布式系统基础结构.
用户可以在不了解分发的基本细节的情况下开发分布式程序. 充分利用群集的功能进行高速计算和存储.
Hadoop实现了分布式文件系统(Hadoop分布式文件系统),称为HDFS. HDFS具有高容错特性,旨在部署在低成本硬件上;并且它提供高吞吐量以访问应用程序数据,适用于那些具有大数据集(大型数据集)应用程序的人. HDFS放宽了POSIX的要求,并允许以流方式访问文件系统中的数据.
Hadoop框架的核心设计是: HDFS和MapReduce. HDFS为海量数据提供存储,而MapReduce为海量数据提供计算.
项目起源
Hadoop是Apache软件基金会于2005年秋季正式引入的,它是Lucene子项目Nutch的一部分. 它的灵感来自于Google Lab最初开发的Map / Reduce和Google File System(GFS).
2006年3月,Map / Reduce和Nutch分布式文件系统(NDFS)分别包含在一个名为Hadoop的项目中.
Hadoop是用于对Internet上的搜索关键字进行分类的最受欢迎的工具,但它也可以解决许多需要极高可伸缩性的问题. 例如,如果要grep一个10TB的巨大文件,会发生什么?在传统系统上,这将花费很长时间. 但是,Hadoop在设计时已经考虑了这些问题,并采用了并行执行机制,因此可以大大提高效率.
发展历史

Hadoop最初来自名为MapReduce的Google编程模型包. Google的MapReduce框架可以将应用程序分解为许多并行计算指令,从而在大量计算节点上运行非常大的数据集. 使用此框架的典型示例是在网络数据上运行的搜索算法. Hadoop最初仅与Web索引相关,并迅速发展成为用于分析大数据的领先平台.
目前,许多公司已经开始提供基于Hadoop的商业软件,支持,服务和培训. Cloudera是一家美国企业软件公司,于2008年开始提供基于Hadoop的软件和服务. GoGrid是一家云计算基础架构公司. 在2012年,该公司与Cloudera合作加速了基于Hadoop的应用程序的采用. Dataguise是一家数据安全公司,并于2012年为Hadoop启动了数据保护和风险评估.
Hadoop应用案例-全球知名企业应用案例
美国国会图书馆是世界上最大的图书馆. 自1800年成立以来,它已收集了超过1.5亿个物理对象,包括书籍,视频,旧地图,电影等. 数字数据量已达到235TB,但美国在eBay拍卖网站上,有8000万用户每天50 TB的数据,相当于5天的国会图书馆容量.
在国外,不仅跨国电子商务公司eBay感受到了海量数据的影响. 其他诸如美国领先的连锁超市沃尔玛和发行的Visa也在台湾,例如台湾集成电路(TSMC),中国电信和其他拥有大量的公司,像海啸一样袭击大数据的大数据浪潮. 如此大量的数据并不是毫无价值的数据,其中包含许多用户的亲身经历的第一手原始数据,甚至许多公司甚至都嗅到了商机.
这些公司从最早面临大数据挑战的搜索引擎公司Google和Yahoo那里学习,以学习处理大量数据的技术和经验. 其中,这些公司中最受欢迎的是用于解决海量数据问题的技术. Apache Foundation的分布式计算技术Hadoop项目.
Hadoop应用案例1-沃尔玛,全球最大的超市运营商
沃尔玛分析客户产品搜索行为并发现超越竞争对手的商机
全球最大的连锁超市沃尔玛(Wal-Mart)使用Hadoop分析客户的搜索行为什么是分布式系统,用户通过搜索引擎在沃尔玛网站上找到关键字. 使用这些关键字的分析结果来发现客户需求并计划下个季度产品的促销策略甚至打算分析客户在社交网站(例如Facebook和Twitter)上对产品的讨论,以期提前发现客户需求. 竞争对手.
尽管十年前沃尔玛在电子商务上进行了投资,但销售收入却远远落后于亚马逊. 后来,沃尔玛决定使用Hadoop来分析客户搜索产品的行为,并且用户通过搜索引擎在沃尔玛网站上找到了关键字. 这些关键字的分析结果用于发现客户需求并计划下一季的产品. 促销策略. 他们还打算分析在Facebook,Twitter和其他社交网络产品上的客户讨论,甚至沃尔玛都比女儿更快地了解女儿的怀孕消息,并积极发送相关产品的促销电子邮件,这比竞争. 对手提前一步找到了客户.
Hadoop应用案例2-eBay,世界上最大的拍卖网站
eBay使用Hadoop分解大量非结构化数据以减少数据存储负载

经营拍卖业务的eBay使用Hadoop分析网站上买卖双方的行为. eBay拥有世界上最大的数据仓库系统,每天增加50TB的数据. 单独存储是一个挑战. 更不用说对这些数据的分析了. 更为困难的挑战是这些数据包括结构化数据和非结构化数据,例如照片,电影,电子邮件,用户的网站浏览日志记录等.
eBay是世界上最大的拍卖网站,拥有8000万用户每天生成50TB数据,这相当于在五天内增加了国会图书馆的数据量. 这些数据包括结构化数据和非结构化数据,例如照片,电影,电子邮件,用户的网站浏览日志记录等. eBay使用Hadoop解决了分析大量结构化数据和非结构化数据的问题.
eBay分析平台高级总监Oliver Ratzesberger也承认,大数据分析的最大挑战是处理结构化和非结构化数据.
eBay在5年前就建立了一个软件和硬件集成平台Singularity,其中采用了压缩技术来解决结构化数据和半结构化数据分析的问题,并于3年前在该平台上集成了Hadoop. 非结构化数据,通过Hadoop预处理数据,将大块的结构化非结构化数据分解为小数据,然后将其放入数据存储系统的数据模型中进行分析,以加快分析速度并减少存储系统的数据分析负载
Hadoop应用案例3-Visa,世界上最大的公司
Visa迅速发现可疑交易,并将1个月的分析时间缩短至13分钟
Visa公司拥有VisaNet,这是世界上最大的支付网络系统之一,用于支付验证. 2009年,每天处理1.3亿笔授权交易和140万个ATM访问. 为了减少各种欺诈和盗窃事件的损失,Visa必须分析每笔交易的数据以查找可疑交易. 尽管每笔交易的数据记录只有200位,但VisaNet每天必须在全球范围内处理数亿笔交易,并且两年内的累积数据高达36TB. 仅需1个月即可获得结果,因此Visa也于2009年导入了Hadoop,并构建了2套Hadoop集群(每套集群少于50个节点),从而将分析时间从1个月缩短至13分钟,从而更快地识别了可疑交易. 及时,并且可以向银行提供预警,甚至及时防止欺诈交易.
许多企业用来解决大数据问题的分布式计算技术并不是一种崭新的技术. 它最早出现在2006年,而Hadoop的核心技术原理源自Google的搜索. 该引擎的关键技术后来由Yahoo支持的开源开发团队开发为一组Hadoop分布式计算平台,也成为Yahoo内部搜索引擎的关键技术.

大数据与Hadoop之间的关系
大数据是一种新兴的数据挖掘技术,它使数据处理和分析变得更加便宜和快捷. 一旦大数据技术进入超级计算时代什么是分布式系统,它将很快应用于普通企业. 在遍地开花的过程中,它将改变许多行业的经营方式. 但是许对大数据有误解,所以这就是大数据与Hadoop之间的关系.
我们都听到了这个预测: 到2020年,电子数据存储量将比2009年增长44倍,达到35万亿GB. 根据IDC的数据,截至2010年,该数字已达到120万PB,即1.2ZB. 如果所有这些数据都存储在DVD上,则光盘的高度将等于从地球到月球的一次来回行程,大约480,000英里.

对于那些担心的人,这是一个不祥的兆头,表明数据存储即将结束. 对于机会主义者来说,这就像一个信息金矿. 随着技术的进步,金矿开采将变得更加容易.
进入大数据,这是一种新兴的数据挖掘技术,它使数据处理和分析变得更加便宜和快捷. 一旦大数据技术进入超级计算时代,它将很快应用于普通企业. 在遍地开花的过程中,它将改变许多行业的经营模式.
在计算机世界中,大数据被定义为一种挖掘过程,该过程对大量有序或无序数据集合(包括但不限于分布式计算(Hadoop))使用非常规数据过滤工具.
大数据已经处于数据存储促进的最前沿,并且也存在很多不确定性,这与“云”非常相似. 我们要求一些分析师和大数据爱好者解释什么是大数据以及它对未来数据存储的意义.
大数据进入历史舞台
企业的大数据已经出现,部分原因在于减少了计算能耗,并且系统具有执行多种处理的能力. 并且随着主存储器成本的持续下降,公司可以在存储器中存储比以往更多的数据. 而且,将多台计算机连接到服务器群集变得更加容易. IDC管理分析师卡尔·奥洛夫森(Carl Olofson)说,这三个变化加起来构成了大数据.
他说: “我们不仅必须做好这些事情,还必须负担相应的费用. ” “过去,某些超级计算机还具有执行系统多处理功能的能力(这些系统紧密相连以形成集群),但是由于使用了专用硬件,其成本高达数十万美元甚至更多. ”现在,您可以使用通用硬件来完成相同的配置. 因此,我们可以更快,更便宜地处理更多数据. “
大数据技术尚未在拥有大型数据仓库的公司中广泛普及. IDC认为,要使大数据技术得到认可,首先,该技术本身必须足够便宜. 然后,它必须满足IBM称为3V标准的2V,即: 品种,体积和速度.
类型要求是指要存储的数据类型是结构化数据和非结构化数据. 卷意味着存储和分析的数据量可能很大. “数据量不只是几百兆兆字节,”
Olofson说: “这取决于具体情况,由于速度和时间之间的关系,有时可能需要几百GB. 如果我现在可以完成300GB的数据分析,那么需要花一个小时才能完成过去,结果将大为不同. 大数据就是这样的技术,它至少可以满足这三个要求中的两个,而且普通企业也可以部署. ”
关于大数据的三大误解
关于什么是大数据以及它可以做什么有许多误解. 这是关于大数据的三个误解:
1. 关系无法显着扩展,因此不能视为大数据技术(错误)
2. 无需考虑工作量或特定用途. Hadoop或任何类似的MapReduce都是大数据的最佳选择. (不正确)
3. 图形管理系统的时代已经结束. 插图的开发只会成为大数据应用的障碍. (可笑的错误)
大数据与开源之间的关系
“许认为Hadoop和大数据基本上意味着同一件事. 这是错误的,” Olofson说. 并解释说: Teradata,MySQL和“智能聚合技术”的某些安装不使用Hadoop,但也可以视为大数据.
Hadoop是用于大数据的应用程序. 由于它基于MapReduce,因此引起了极大的关注. (MapReduce是一种用于超级计算的通用方法,此后已由主要由Google资助的项目进行了优化,因此已简化和完善. )Hadoop是几个紧密相关的Apache项目的混合体. 主要的安装启动器,其中包括HBase MapReduce环境中的.
为了充分利用Hadoop和类似的先进技术,软件开发人员一直在努力开发各种技术,其中许多技术是在开源社区中开发的.
Olofson说: “他们已经开发了许多所谓的noSQL. 令人眼花so乱的种类很多,其中大多数是键值匹配,可以使用多种技术来优化性能或类型. 或容量. ” <
开源技术尚未获得商业支持. 他补充说: “因此,该领域还有一段发展和完善的过程. 这个过程可能需要几年时间. 因此,大数据可能需要一些时间才能在市场上成熟. ”
根据IDC,一年中至少有三家商业公司可以某种方式支持Hadoop. 同时,包括Datameer在内的多家公司将发布配备Hadoop组件的分析工具,这些工具可以帮助公司开发自己的应用程序. Hadoop出现在Cloudera和Tableau的产品列表中.
什么是hadoop?阅读以上信息后,相信读者对hadoop有一定的了解.
【编辑选择】
大数据时代更多地涉及合同精神区块数据. 大数据与Hadoop有什么关系?如何更好地利用大数据?专家: 利用大数据解决信息不对称问题
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-217170-1.html

 weixin_30480583
 计算机OCR字符识别技术的原理和未来发展趋势
 semaphore java.util.concurrent常用类(Cou
 C语言中的Static和内联函数
厂家一天生产那么多黑芝麻粉