Java解析XML文件的方法的比较
电脑杂谈 发布时间:2020-05-19 02:24:59 来源:网络整理
DOM
DOM是W3C的用于处理XML的标准API. 它是与XML处理相关的许多其他标准的基础,不仅Java,而且Java,PHP,MS .NET等其他语言也已实现该标准并成为应用程序. 最广泛的XML处理方法. 当然,为了提供越来越强大的功能,Java具有许多DOM直接扩展工具类,例如JDOM,DOM4J等,这是许多Java程序员所熟悉的. 它们基本上属于DOM接口功能的扩展,并保留了大量DOM. API的特征. 许多原始的DOM程序员已经毫无障碍地掌握了另外两个的使用. 直观且易于操作的方法使其在Java程序员中很受欢迎.
以DOM模式解析XML文件的步骤
1. 获取解析器,该解析器从xml生成DOM对象树
声明:
DocumentBuilderFactory docbf = DocumentBuilderFactory.newInstance();
2. 获取Doucument的,您可以使用解析器的newDocumentBuilder()来获取示例
声明:
DocumentBuilder docb = docbf.newDocumentBuilder();
3. 使用DocumentBuilder的parse()解析xml文件以获得Doucment对象.
声明:
文档doc = docb.parse(“ ProfessionalBooks.xml”);
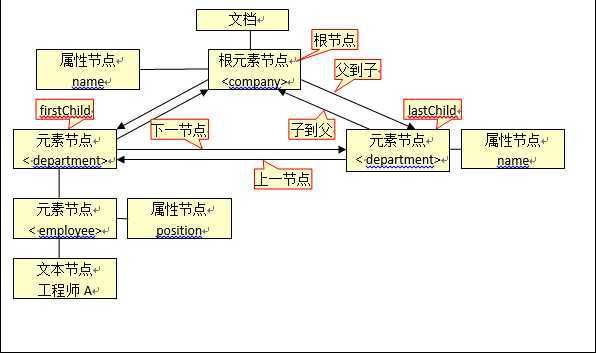
4. 获取当前节点的所有子节点
NodeList节点= doc.getChildNodes();
5. 由于xml是树结构,因此有必要编写一个遍历树的函数.
公共静态无效ReadTreeStructure(NodeList节点){
//遍历所有子节点
for(int i = 0; i //获取字节点名称,确定子节点的类型,并区分文本类型节点和元素类型节点 if(nodes.item(i).getNodeType()== Node.ELEMENT_NODE)
System.out.print(“节点的名称为: ” + nodes.item(i).getNodeName()+“”); 字符串值=((文本)(nodes.item(i).getFirstChild())). getData(). 修剪(); if(value.getBytes(). length!= 0){ System.out.print(“此节点的值为: ” +值); } System.out.println(); System.out.println(); } //获取子节点的值,否则解析xml,不输出 //如节点仍然有子节点解析xml,请继续阅读下层 if(nodes.item(i).getChildNodes(). getLength()!= 0){ ReadTreeStructure(nodes.item(i).getChildNodes()); } } } SAX SAX产生于其特殊需求. 为什么是绿色的?这是因为SAX使用最少的系统资源和最快的分析方法来提供对XML处理的支持. 但是,随之而来的繁琐的搜索方法给程序员带来了很多麻烦,并且通常令人头疼. 同时,它对XPath查询功能的支持使人们喜欢它,也讨厌它. 当SAX方法解析XML文件时,需要一个Handler类来提供解析方法, 第一步是首先生成一个xml解析工厂对象,例如: SAXParserFactory factory = SAXParserFactory.newInstance(); 然后使用工厂对象生成xml解析对象: XMLParser parser = factory.newSAXParser(); 然后使用此解析对象生成XMLReader对象: XMLReader reader = parser.getXMLReader(); 然后设置reade对象的contentHandler: reader.setContentHandler(***);请注意,此方法的参数是一个继承DefaulHandler的类. 最后,使用reader对象进行解析: reader.parse(***)的参数是一个InputSource对象,主要是要解析的字符串. Digester / JAXB Digester是Apache基金会下的一个开源项目. 作者对它的理解源于对Struts框架的研究. 许多程序员是否想了解主要的开源框架的设计,甚至想自己编写一个强大的功能?框架将遇到这样的问题: 这些用XML语言标记的各种配置文件,使用什么技术来解析框架的底部? DOM解析需要时间,SAX解析太麻烦,而且解析系统的开销太大,因此每个人都认为您需要使用与XML结构相对应的JavaBean来加载此信息,因此Digester应运而生. 它的出现为将XML转换为JavaBean对象的需求带来了方便的操作界面,这使更多类似的需求得到了更完美的解决方案,并且不再需要程序员实现此类繁琐的解析过程. 同时,SUN还发布了JAXB,这是一种用于转换XML和JavaBeans的工具,感兴趣的读者可以自己了解它. 工作原理如下: Digester的底层使用SAX(XML的简单API)来分析XML文件,因此自然而然地,对象转换是由“事件”驱动的. 遍历每个节点时,请检查是否存在匹配的模式. 如果存在,请执行规则定义操作,例如创建特定的Java对象或在特定的对象上调用方法. 这里的XML元素根据匹配模式进行标识,相关操作由规则定义. 下面的xml代码,右侧是与左侧元素相对应的匹配模式: [xhtml]查看普通副本 三种分析方法的比较 DOM 利与弊: 实施W3C标准,有多种支持此解析方法的编程语言,该方法本身简单快捷,易于初学者掌握. 处理方法是将整个XML作为树形方法进行操作和解析,并将其读取到内存中,因此它支持应用程序修改XML数据的内容和结构,但同时由于需要读取在处理开始时将整个XML文件放入内存中进行分析,因此在解析大量XML文件时会遇到类似的内存泄漏和程序崩溃的风险. 请对此多加注意. 应用范围: 小型XML文件解析,完整解析或大多数解析XML,以及修改XML树内容以生成您自己的对象模型 SAX SAX从根本上解决了解析XML文档时DOM消耗大量资源的问题. 它的实现是通过类似于流解析,读取整个XML文档树并通过事件处理程序响应程序员对XML数据解析的需求的技术来实现的. 因为不需要将整个XML文档读取到内存中,所以节省系统资源非常明显. 在需要处理大型XML文档且对性能的要求很高的某些情况下,它起着非常重要的作用. 支持XPath查询的SAX使开发人员更加灵活,并且更轻松地处理XML. 但与此同时,它仍然存在一些缺点,并困扰着大多数开发人员: 首先,其非常复杂的API接口令人生畏,其次,由于它是类似于流解析的文件扫描方法,因此不支持XML应用程序树木. 内容结构的修改等可能会带来不便. 应用范围: XML文件解析,仅部分解析或仅部分XML树内容,XPath查询要求以及需要自行生成特定的XML树对象模型 Digester / JAXB 优缺点: 因为它是从以上两个派生的工具类,所以为了满足将XML转换为JavaBean的特殊需求,没有特别明显的优缺点. 作为著名的开源框架Struts的XML解析工具Digester,它为我们提供了一种将XML转换为JavaBean的可靠方法. 应用范围: 需要将XML文档直接转换为JavaBeans. GDCA(数字安全时报)已经在国内独立发行了TrustAUTH SSL证书,并且是许多国际知名品牌指定的国内代理商: GlobalSign,Symantec,GeoTrust SSL证书. 为了使更多的国内网站升级到安全的https加密传输协议,暑假期间,GDCA开展了各种国际知名的SSL证书折扣活动,以实现HTTPS加密并显示网站的真实身份信息.


本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-214819-1.html
-

-
慕容部
都是中国人
 聚丙烯下游产业发展分析
 解决方法:如果无法在win10系统中弹出CD-ROM,该怎么办
 计算机网络最主要的功能是资源共享和通信
 沉重! 2020年知道世界大学排名发布!青贝并列14?纽约大学倒计时?
5毛钱都不给我