Awk用例摘要(将进行操作和维护)
电脑杂谈 发布时间:2020-05-13 14:09:39 来源:网络整理
来自: 以下知识点可能是错误的,请参考最新的Awk学习文章:
知识:
1)数组
数组是用于存储一系列值的变量,可以通过索引访问数组的值.
Awk中的数组称为关联数组,因为其下标(索引)可以是数字或字符串.
下标通常称为键. 数组元素的键和值存储在Awk程序内的表中. 该表使用哈希算法,因此数组元素是随机排序的.
数组格式: 数组[索引] =值
1,Nginx日志分析
日志格式: '$ remote_addr- $ remote_user [$ time_local]“ $ request” $ status $ body_bytes_sent“ $ http_referer”“ $ http_user_agent”“ $ http_x_forwarded_for”“
日志记录: 27.189.231.39-[09 / Apr / 2016: 17: 21: 23 +0800]“ GET /Public/index/images/icon_pre.png HTTP / 1.1” 200 44668“;” Mozilla / 5.0(Windows NT 10.0; WOW64)AppleWebKit / 537.36(KHTML,例如Gecko)Chrome / 44.0.2403.157 Safari / 537.36“”-“
1)统计日志中访问量最高的10个IP
想法: 对第一列进行重复数据删除并输出出现的次数
方法1: $ awk'{a [$ 1] ++} END {for(i in a)print a [i],i | “ sort -k1 -nr | head -n10”}'access.log <
方法2: $ awk'{print $ 1}'access.log |排序| uniq -c |排序-k1 -nr |头-n10
说明: [[$ 1] ++创建数组a,将第一列作为下标,使用运算符++作为数组元素,且元素初始值为0. 在处理IP时,下标是IP,元素增加1. 在处理第二个IP时,下标是IP,元素增加1. 如果IP已经存在,则元素增加1,这意味着IP出现两次,元素结果为2,依此类推. 因此,可以实现重复数据删除,并且可以计算出现次数.
2)IP在统计日志中被访问100次以上
方法1: $ awk'{a [$ 1] ++} END {for(i in a){if(a [i]> 100)print i,a [i]}}'access.log <
方法2: $ awk'{a [$ 1] ++; if(a [$ 1]> 100){b [$ 1] ++}} END {for(i in b){print i,a [i]}}'access.log
说明: 方法1是将结果保存在数组中,并判断输出期间符合要求的IP. 方法2是将结果保存在a数组中,并判断满足要求的IP放在b数组中,最后打印b数组的IP.
3)在2016年4月9日的一天内统计访问量最高的10个IP
思考: 首先过滤掉这段时间的日志,然后进行重复数据删除并计算发生次数
方法1: $ awk'$ 4> =“ [[9 / Apr / 2016: 00: 00:01” && $ 4 <=“ [[9 / Apr / 2016: 23: 59: 59” 1] + +} END {对于(a中的i)打印[i],i | “ sort -k1 -nr | head -n10”}'access.log
方法2: $ sed -n'/ \ [9 \ / Apr \ / 2016: 00: 00: 01 /,/ \ [9 \ / Apr \ / 2016: 23: 59: 59 / p'访问. 日志|排序| uniq -c |排序-k1 -nr | head -n10#前提条件开始时间和结束时间必须存在于日志中
4)计算当前时间前一分钟的访问次数
思考: 首先获取与当前时间前一分钟对应的日志格式的时间,然后匹配统计信息
$日期= $(日期-d'-1分钟'+%d /%b /%Y: %H: %M); awk -vdate = $ date'$ 0〜date {c ++} END {print c}'access.log
$日期= $(日期-d'-1分钟'+%d /%b /%Y: %H: %M); awk -vdate = $ date'$ 4> =“ [” date“: 00” && $ 4 <=“ [” date“: 59” {c ++} END {print c}'access.log
$ grep -c $(日期-d'-1分钟'+%d /%b /%Y: %H: %M)access.log
说明: 日期+%d /%b /%Y: %H: %M-> 09 / Apr / 2016: 01: 55
5)计算访问量最高的前10页($请求)
$ awk'{a [$ 7] ++} END {for(i in a)print a [i],i | “ sort -k1 -nr | head -n10”}'access.log
6)计算每个URL访问的内容的总大小($ body_bytes_sent)
$ awk'{a [$ 7] ++;大小[$ 7] + = $ 10} END {对于(i in a)打印一个[i],大小[i],i}'access.log
7)计算每个IP访问状态码($状态)的数量
$ awk'{a [$ 1“” $ 9] ++} END {for(i in a)print i,a [i]}'access.log
8)用访问状态代码404和出现次数对IP进行计数
$ awk'{if($ 9〜/ 404 /)a [$ 1“” $ 9] ++} END {for(i in a)print i,a [i]}'access.log
2. 两个文件的比较
文件内容如下:
$ cat a
1
2
3
4
5
6
$ cat b
3
4
5
6
7
8
1)找到相同的记录
方法1: $ awk'FNR == NR {a [$ 0]; next}(a中的$ 0)'a b
3
4
5
6
在进行解释之前,请先看一下FNR和NR之间的区别:
$ awk'{print NR,$ 0}'a b
1 1
2 2
3 3
4 4
5 5
6 6
7 3
8 4
9 5
10 6
11 7
12 8
$ awk'{print FNR,$ 0}'a b
1 1
2 2
3 3
4 4
5 5
6 6
1 3
2 4
3 5
4 6
5 7
6 8
可以看到NR正在处理一行记录,该数字将增加1,并且您还可以看到awk将这两个文件视为组合文件.
FNR将处理一行记录,并且该数目还将增加1. 但是,当处理第二个文件时,该数目将重新计数.
说明: FNR和NR是内置变量. FNR == NR通常用于处理两个文件. 这个示例可以理解为awk将两个文件视为一个文件.
当处理文件时,FNR等于NR,条件为true,执行[$ 0],下一个表达式,这意味着每条记录都作为下标(没有元素)存储在数组中,下一条出awk数组下标,类似于继续,不会执行以下表达式.
执行的过程是相同的,直到b被处理,FNR不等于NR(FNR重新计数为1,NR继续加1为7),条件为false,且其后的一个[$ 0 ],则不执行下一个表达式直接执行(a中的$ 0)表达式. 这句话意味着要处理b文件中的第一项,并继续确定它是否在a数组中. 如果是,则打印记录,依此类推.
这可能更好理解:
$ awk'FNR == NR {a [$ 0]} NR> FNR {if($ 0 in a)print $ 0}'a b
方法2:
$ awk'FNR == NR {a [$ 0] = 1; next}(a [$ 0])'a b#不能添加括号
$ awk'FNR == NR {a [$ 0] = 1; next}(a [$ 0] == 1)'a b
$ awk'FNR == NR {a [$ 0] = 1; next} {if(a [a [$ 0] == 1)打印}'a b
$ awk'FNR == NR {a [$ 0] = 1} FNR! = NR && a [$ 0] == 1'a b
注意: 首先,我们必须知道以下的[$ 0]不是数组,而是通过下标(每个记录在b文件中)访问a数组的元素. 如果由[b条记录行]获得的a数组的元素为1,则为true,即等于1,则打印该记录,否则无法获取,为false.
方法3:
$ awk'ARGIND == 1 {a [$ 0] = 1} ARGIND == 2 && a [$ 0] == 1'a b
$ awk'FILENAME ==“ a” {a [$ 0] = 1} FILENAME ==“ b” && a [$ 0] == 1'a b
说明: ARGIND具有内置变量来处理文件标识符. 第一个文件为1,第二个文件为2. FILENAME也是一个内置变量,指示输入文件的名称
方法4: $ a排序b | uniq -d
方法5: $ grep -f a b
2)查找不同的记录(与上面相同,相反)
$ awk'FNR == NR {a [$ 0];下一个}! (a中的$ 0)'a b
$ awk'FNR == NR {a [$ 0] = 1;下一个}! a [$ 0]'a b
$ awk'ARGIND == 1 {a [$ 0] = 1} ARGIND == 2 && a [$ 0]! = 1'a b
$ awk'FILENAME ==“ a” {a [$ 0] = 1} FILENAME ==“ b” && a [$ 0]! = 1'a b
7
8
方法2: $对a进行排序| uniq -d
方法3: $ grep -vf a b
3. 合并两个文件
1)将d文件性别合并到c文件中
$ cat c
张山100
lisi 200
wangwu 300
$ cat d
张三人
丽丝女人
方法1: $ awk'FNR == NR {a [$ 1] = $ 0; next} {打印a [$ 1],$ 2}'c d
张山100人
lisi 200女人
wangwu 300 man
方法2: $ awk'FNR == NR {a [$ 1] = $ 0} NR> FNR {打印a [$ 1],$ 2}'c d
描述: NR == FNR匹配第一个文件,NR> FNR匹配第二个文件,$ 1是数组的下标
方法3: $ awk'ARGIND == 1 {a [$ 1] = $ 0} ARGIND == 2 {print a [$ 1],$ 2}'c d
2)将a.txt文件中的服务名称合并为一个IP
$ cat a.txt
192.168.2.100: httpd
192.168.2.100: tomcat
192.168.2.101: httpd
192.168.2.101: 后缀
192.168.2.102: mysqld
192.168.2.102: httpd
$ awk -F: -vOFS =“: ”'{a [$ 1] = a [$ 1] $ 2} END {for(i in a)print i,a [i]}'a.txt
$ awk -F: -vOFS =“: ”'{a [$ 1] = $ 2 a [$ 1]} END {for(i in a)print i,a [i]}'a.txt
192.168.2.100: httpd Tomcat
192.168.2.101: httpd后缀
192.168.2.102: mysqld httpd
描述: a [$ 1] = $ 2第一列是一个下标,第二列是一个元素,其后的[$ 1]是通过第一列获取一个数组元素(服务名称),结果是$ 1 = $ 2 $ 2,并作为数组元素.
3)将第一行添加到下面每行的开头
$ cat a.txt
小李
a 100
b 110
c 120
$ awk'NF == 1 {a = $ 0; next} {print a,$ 0}'a.txt
$ awk'NF == 1 {a = $ 0} NF! = 1 {print a,$ 0}'a.txt
小李一个100
xiaoli b 110
xiaoli c 120
4. 在闪回列中打印文本
$ cat a.txt
小李一个100
xiaoli b 110
xiaoli c 120
$ awk'{for(i = NF; i> = 1; i-){printf“%s”,$ i} print s}'a.txt
一个小李100个
小李110 b
120 c xiaoli
$ awk'{for(i = NF; i> = 1; i-)如果(i == 1)printf $ i“ \ n”;其他printf $ i“”}'a.txt
说明: 使用NF降序输出,将最后一个字段作为第一个输出,然后递减,打印s或打印“”打印换行符
5. 从第二列到末尾打印
方法1: $ awk'{for(i = 2; i <= NF; i ++)if(i == NF)printf $ i“ \ n”; else printf $ i“”}'a.txt <
方法2: $ awk'{$ 1 =“”} {print $ 0}'a.txt
a 100
b 110
c 120
6. 将c文件中的第一列放入d文件中的第三列
$ cat c
a
b
c
$ cat d
1个
2 2
3 3
方法1: $ awk'FNR == NR {a [NR] = $ 0;下一个} {$ 3 = a [FNR]} 1'c d
说明: NR号用作下标,并且元素是每一行. 处理d文件时,第三列等于下标a数据的FNR(recount 1-3)数.
方法2: $ awk'{getline f <“ c”;打印$ 0,f}'d
1个一个
2两个b
3三c
1)替换第二列
$ awk'{getline f <“ c”; gsub($ 2,f,$ 2)} 1'd
1个
2 b
3 c
2)在第二栏中替换两个
$ awk'{getline f <“ c”; gsub(“ two”awk数组下标,f,$ 2)} 1'd
1个
2 b
3 3
7,数字求和
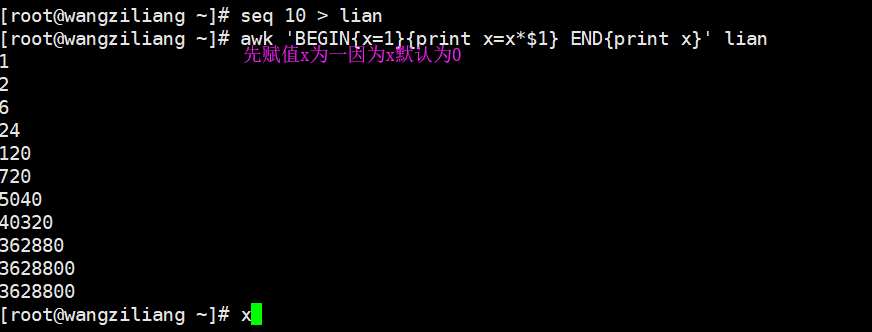
方法1: $ seq 1100 | awk'{sum + = $ 0} END {print sum}'
方法2: $ awk'BEGIN {sum = 0; i = 1;而(i <= 100){sum + = i;我++}列印金额}'
方法3: $ awk'BEGIN {for(i = 1; i <= 100; i ++)sum + = i} END {print sum}'/ dev / null
方法4: $ seq -s + 1100 |公元前
8. 每三行添加一个换行符或内容
方法1: $ awk'$ 0; NR%3 == 0 {printf“ \ n”}'a
方法2: $ awk'{print NR%3? $ 0: $ 0“ \ n”}'a
方法3: $ sed'4〜3s / ^ / \ n /'a
9. 字符串拆分
方法1:
$ echo“ hello” | awk -F'''{for(i = 1; i <= NF; i ++)print $ i}'
$ echo“ hello” | awk -F'''{i = 1;而(i <= NF){print $ i;我++}}'
h
e
l
l
o
方法2:

$ echo“ hello” | awk'{split($ 0,a,“''”);为(i in a)打印[i]}'#Unordered
l
o
h
e
l
10. 计算字符串中每个字母的出现次数
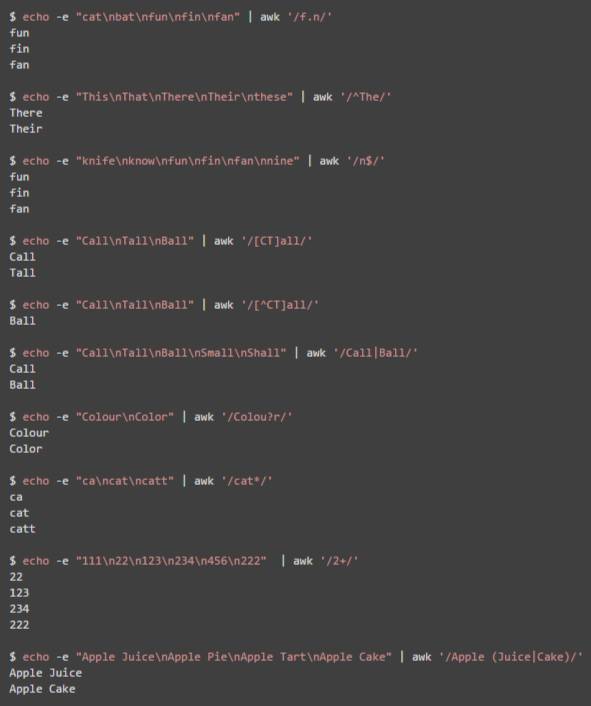
$ echo a,bca,ba | tr“ [,. ]”“ \ n” | awk -F'''{for(i = 1; i <= NF; i ++)a [$ i] ++} END {for(i in a)print i,a [i] | “ sort -k2 -rn”}'
a 3
b 2
c 1
11. 对第一列进行排序
$ awk'{a [NR] = $ 1} END {s = asort(a,b); for(i = 1; i <= s; i ++){print i,b [i]}}'a .txt
描述: 将每行的编号作为下标值$ 1,将a数组的值放入数组b,丢弃a下标,并指定默认的返回值asort(原始长度一个数组)到s,使用小于s的for循环行号,将排序后的数组从1打印到数组的长度.
12. 以相同顺序删除重复的行
$ awk'!一个[$ 0] ++'文件
博客地址:
QQ组: 323779636(Shell / Python操作和维护开发组)
13. 删除指定的行
删除第一行:
$ awk'NR == 1 {next} {print $ 0}'文件#$ 0可以省略
$ awk'NR! = 1 {print}'个文件
$ sed'1d'文件
$ sed -n'1! p'文件
14. 在指定行的前后添加一行
在第二行之前添加txt:
$ awk'NR == 2 {sub('/.*/',“ txt \ n&”)} {print}'a.txt
$ sed'2s /.*/ txt \ n&/'a.txt
在第二行之后添加txt:
$ awk'NR == 2 {sub('/.*/',“&\ ntxt”)} {print}'a.txt
$ sed'2s /.*/& \ ntxt /'a.txt
15. 通过IP获取网卡的名称
$ ifconfig | awk -F'[: ]''/^eth/{nic=$1}/192.168.18.15/{print nic}'
16. 浮点运算(数字46保留小数点)
$ awk'开始{print 46/100}'
$ awk'开始{printf“%.2f \ n”,46/100}'
$ echo 46 | awk'{print $ 0/100}'
$ echo'scale = 2; 46/100'|公元前| sed的/ ^ / 0 /'
$ printf“%.2f \ n” $(echo“ scale = 2; 46/100” | bc)
结果: 0.46
17. 用逗号替换换行符
$ cat a.txt
1
2
3
更换后: 1、2、3
方法1:
$ awk'{s =(s?s“,” $ 0: $ 0)} END {print s}'a.txt
描述: 三目运算符(a?b: c),第一个s是变量,s? s“,” $ 0: $ 0,当第一次处理为1时,未给s变量赋0的初始值0为false,结果打印为1,第二次处理为2,s值为1,真,结果是1,2. 以此类推,括号不能写.
方法2:
$ tr'\ n'',' 方法3: $ sed': a; N; s / \ n /,/; $! b a'a.txt 描述: 第一个标签a读取第一行记录1并将其附加到模式空间. 这时,模式空间的内容是1 $,执行$! b($!最后一行不跳转,b是控制流Jump命令)跳转到a标签,继续读取记录2的第二行并追加到模式空间,因为使用了N命令,所以每条记录都是除以换行符(\ n),且模式空间的内容为1 \ n2 $,执行命令以逗号替换换行符,然后继续跳至标签... 方法4: $ sed': a; $! N; s / \ n /,/; t a'a.txt 描述: 与上述类似,其中t是测试命令,仅在成功执行最后一个命令(替换)时跳转. 方法5: $ awk'{if($ 0!= 3)printf“%s,”,$ 0;否则打印$ 0}'a.txt 说明: 3是文本的最后一个数字 方法6: 读行时;做 a + =($行) 完成 echo $ {a [*]} | sed的/ /,/ g' 说明: 将每一行放入数组中,然后替换 18. 删除奇怪的换行符 $ cat b.txt 字符串 号码 a 1 b 2 $ awk'ORS = NR%2? “ \ t”: “ \ n”'b.txt#删除奇数换行符 $ xargs -n2 字符串编号 a 1 b 2 19. 费用统计 $ cat a.txt 名称,成本,数量 张山8000 1 zhangsan 5000 1 lisi 1000 1 lisi 2000 1 wangwu 1500 1 zhaoliu 6000 1 zhaoliu 2000 1 zhaoliu 3000 1 统计总费用和总人数: $ awk'{name [$ 1] ++;数字[$ 1] + = $ 3; money [$ 1] + = $ 2} END {用于(名字中的i)打印i,数字[i],货币[i]}'a.txt zhaoliu 3 11000 张山2 13000 wangwu 1 1500 lisi 2 3000 20. 打印乘法公式 方法1: $ awk'BEGIN {for(n = 0; n ++ <9;){for(i = 0; i ++ 1x1 = 1 1x2 = 2 2x2 = 4 1x3 = 3 2x3 = 6 3x3 = 9 1x4 = 4 2x4 = 8 3x4 = 12 4x4 = 16 1x5 = 5 2x5 = 10 3x5 = 15 4x5 = 20 5x5 = 25 1x6 = 6 2x6 = 12 3x6 = 18 4x6 = 24 5x6 = 30 6x6 = 36 1x7 = 7 2x7 = 14 3x7 = 21 4x7 = 28 5x7 = 35 6x7 = 42 7x7 = 49 1x8 = 8 2x8 = 16 3x8 = 24 4x8 = 32 5x8 = 40 6x8 = 48 7x8 = 56 8x8 = 64 1x9 = 9 2x9 = 18 3x9 = 27 4x9 = 36 5x9 = 45 6x9 = 54 7x9 = 63 8x9 = 72 9x9 = 81 方法2: #! / bin / bash for((i = 1; i <= 9; i ++));做 对于((j = 1; j <= i; j ++)) ;做 结果= $((($ i * $ j)) #let“结果= i * j” echo -n“ $ i * $ j = $结果” 完成 回声 完成 21. 只打印奇数或偶数行 打印奇数行: 方法1: $ seq 1 5 | awk'i =!我 说明: 首先知道对于数字运算,未定义变量的初始值为0,对于字符运算,未定义变量的初始值为空字符串. 读取记录的第一行,然后执行模式匹配,i是一个未定义的变量,即i =! 0!是逆的. 感叹号的右边是一个布尔值,0或空字符串为false,非零或非空字符串为true! 0为true,所以i = 1,条件为true,则打印第一条记录. 为什么不打印就打印?由于该模式没有任何动作,因此默认情况下将打印整个记录. 读取记录的第二行并执行模式匹配,因为i的值上次从0更改为1,此时i =! 1,条件为假. 读取记录的第三行,因为最后一个条件为false,所以我将初始值恢复为0,然后继续打印. 等等... 可以看出该操作中没有判断记录,但是通过布尔值判断是非. 方法2: $ seq 1 5 | awk'NR%2! = 0' 方法3: $ seq 1 5 | sed -n'1〜2p' 说明: 步长,每隔一行打印一次 方法4: $ seq 1 5 | sed -n'p; n' 描述: 首先打印第一行,执行n命令以读取当前行的下一行2,将其放在模式空间中,然后没有打印模式空间行操作,因此仅保存而不打印,以相同的方式继续打印第三行. 1 3 5 打印偶数行: $ seq 1 5 | awk'! (i =!i)' $ seq 1 5 | awk'NR%2 == 0' $ seq 1 5 | sed -n'0〜2p' $ seq 1 5 | sed -n'n; p' 描述: 读取当前行的下一行2,将其放在模式空间中,使用p命令打印模式空间的行,然后输出2.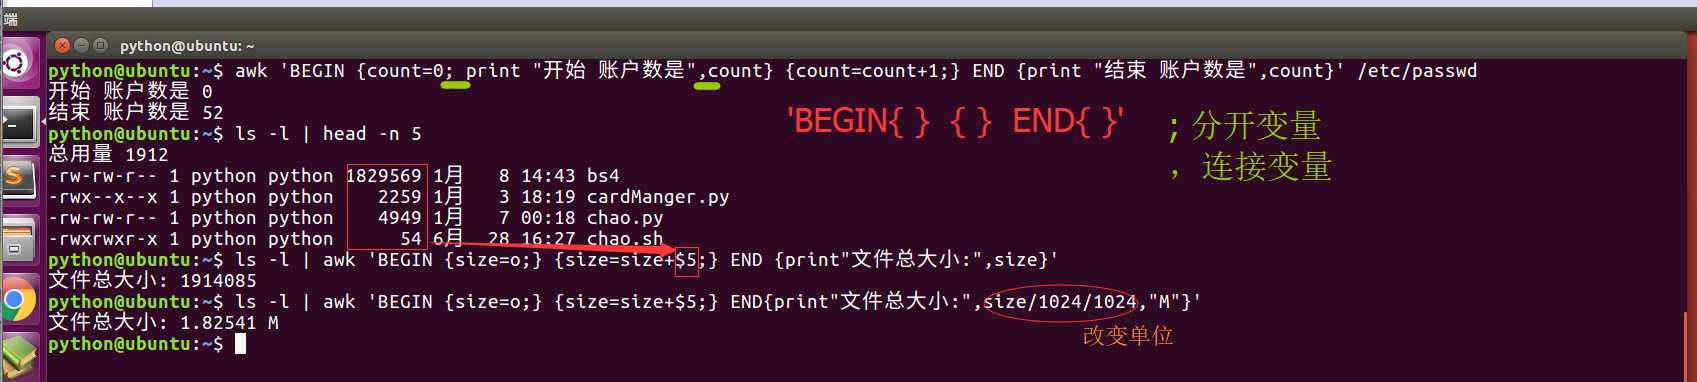
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-208701-1.html
-

-
张爽
说的太好了
-
陈猛
多170艘还好呢
 windows 内核编程黑客..黑客.微信:
 HBV DNA定量检测的正常范围是什么
 部: 要花三年时间才能实现国家户口和公民编号的唯一性
 原版镜像和Ghost差别很大吗?Ghost系统与原版系统的区别
使它在涨潮时也能在海面之上