分布式存储系统简介
电脑杂谈 发布时间:2020-05-13 05:30:15 来源:网络整理
来自
现代互联网已进入大数据时代. 每天产生成千上万的数据. 这些数据的规模很容易达到几P的水平. 传统的独立存储已经得到了扩展,并且根本无法满足存储系统的大数据需求. 此时,各种分布式系统应运而生.
事实上,分布式的概念早在多年前就被提出和研究,但是由于当时的网络数据很少,所以直到大数据时代来临为止,分布式无用的地方一直很冷淡. 当它出现时,它就被人们逐步应用于工程实践.
分布式存储系统是将数据存储在多个独立的设备中. 传统的网络存储系统使用集中式存储服务器来存储所有数据. 存储服务器成为系统性能的瓶颈,也是可靠性和安全性的关注焦点,无法满足存储应用的需求. 分布式网络存储系统采用可扩展的系统结构,使用多个存储服务器来共享存储负载,并使用位置服务器来定位和存储信息. 它不仅提高了系统的可靠性,可用性和访问效率,而且易于扩展.
分布式存储系统可以扩展到数百甚至数千个群集. 随着群集大小的增长,系统的整体性能呈线性增长.
分布式存储系统的自动容错和自动负载平衡机制使它可以在普通PC上构建. 此外,线性膨胀能力还使增减机器非常方便,并且可以实现自动操作和维护.
无论是用于整个群集还是单个服务器,分布式存储系统都必须具有高性能.
分布式存储系统需要能够提供易于使用的外部接口. 此外,它还需要具有完善的监视,操作和维护工具,并能够将文玩与其他系统集成.
分布式存储系统的挑战主要是数据和状态信息的持久性. 在自动迁移,自动容错和并发读写过程中,它要求数据的一致性. 分布式存储所涉及的技术主要来自两个领域: 分布式系统和.
如何将数据分发到多个服务器以确保数据均匀分发?将数据分发到多个服务器后如何实现跨服务器的读写操作?
分布式系统不同于传统的独立系统,因为它们可以将数据分布到多个节点并实现多个节点之间的负载平衡. 分布式存储系统的基本要求是透明性,包括数据分布透明性,数据迁移透明性,数据复制透明性和数据故障透明性.
哈希分配方法非常普遍. 该方法是根据数据的一定特性计算哈希值,并在哈希值和集群中的服务器之间建立映射关系,以便将不同哈希值的数据分配到不同的服务器上. 如果哈希函数的哈希函数非常好,则该哈希方法可以在群集中相对均匀地分布数据,并且需要在哈希方法中记录的元信息也非常简单. 该方法和模块化服务器的数量可以计算处理后的数据属于哪台机器.

传统的哈希分配算法存在问题. 当服务器联机或脱机时,N的值会更改,并且数据映射会中断. 为了解决这个问题,一种方法是不再简单地将哈希值和服务器数量除以除法,而是使用哈希值和服务器之间的对应关系作为元数据,并将其移交给特殊的元数据服务器进行管理. . 另一种方法是使用一致的哈希算法.
分布式哈希表(DHT)算法. 算法思想: 为系统中的每个节点分配一个随机令牌,这些令牌形成一个哈希环. 在执行数据存储操作时,首先计算Key的哈希值,然后按顺时针方向将其存储在大于或等于哈希值的第一个令牌所在的位置. 一致的哈希值的优点是,当添加或删除哈希值时,它仅影响哈希环中划分的节点,而对其他节点没有影响.
散列破坏了数据顺序,仅支持随机读取操作,不支持顺序扫描. 此外,以这种方式,可能存在一些用户的数据量太大的问题. 由于用户数据仅限于一个存储节点,因此无法发挥分布式存储系统的多机并行处理能力.
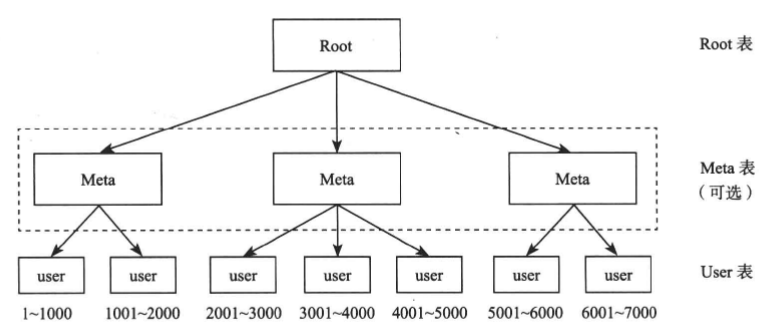
顺序分布在分布式表系统中更为常见. 通常的做法是将大表的顺序分为连续的范围. 每个范围称为一个子表. 主服务器负责根据某种策略分配这些子表. 到存储节点.
如果将多个数据副本复制到多个服务器,即使在异常情况下,也可以确保不同副本之间的数据一致性. 同一数据的多个副本通常将一个副本作为主副本,将另一个副本作为备份副本. 主副本将数据复制到备份副本. 复制协议有两种,强同步复制和异步复制. 两者之间的区别在于,是否需要将用户的读写请求同步到备用副本以返回成功. 如果有多个备份副本,则复制协议还要求将写请求同步到至少几个备份副本. 当主副本发生故障时分布式存储系统,分布式存储系统可以自动将服务切换到备份副本,以实现自动容错.
一致性和可用性是矛盾的. 强大的同步复制协议可以确保主副本和备份副本之间的一致性,但是当备份副本出现故障时,它也可能会阻止存储系统的正常写服务,并且会影响系统的整体可用性. 异步复制协议的可用性相对较好,但是并不能保证一致性,并且当主副本失败时可能会丢失数据.
数据的多个副本存储在分布式存储系统中. 一般来说,一个副本是主副本,另一个副本是备份副本. 通常的做法是将数据写入主副本. 主副本确定操作顺序,然后复制到其他副本.
客户端将写请求发送到主副本,而主副本将写请求复制到其他备用副本. 通常的做法是同步操作日志(Commit log). 主副本首先将操作日志同步到备用副本,然后备用副本重播操作日志,并在完成后通知主副本. 然后,主副本会修改计算机并等待所有操作完成,然后再通知客户端写入成功. 在此,要求主从同步成功后再返回客户端以成功写入. 该协议称为强同步协议. 强大的同步协议可提供强大的一致性,但是如果备用副本出现问题,则会阻止写操作,并且系统可用性会很差.
与强同步相对应的复制方法是异步复制. 在异步模式下,主副本无需等待备用副本的响应,而仅需要成功的本地修改就可以将成功的写操作通知客户端. 此外,主副本通过异步机制(例如单独的复制线程)将客户端修改操作推送到其他副本. 异步复制的优点是系统可用性良好,但一致性很差. 如果主副本中发生不可恢复的故障,则更新操作的最后一部分可能会丢失.
强同步复制和异步复制都以某种形式将主副本的数据发送到其他副本. 这种复制协议称为基于主副本的复制协议. 此方法要求一次只能有一个副本作为主副本,这决定了写操作之间的顺序. 如果主副本失败,则需要选择一个备用副本以成为新的主副本. 此步骤称为选举,例如Paxos协议. 此外,还有基于多个存储节点的复制协议(相对较少).
操作日志的原理很简单: 为了利用磁盘的顺序读写特性,客户端的写操作首先被写入磁盘,然后再应用于内存,因为内存是一个随机的读写设备,它可以通过各种数据结构,例如B +树,有效地组织数据. 当服务器关闭并重新启动时,仅需要累积一定数量的操作日志,然后将其分批写入磁盘. 这种技术通常称为组提交.

CAP是指一致性(一致性),可用性(可用性)和分区容忍度(网络分区容忍度).
分布式存储系统需要自动容错,并且必须始终满足分区容忍. 因此,不能同时满足写操作的一致性和可用性. 存储系统设计需要在一致性和可用性之间进行权衡. 在某些情况下,不允许丢失数据. 在其他情况下,允许以最小的概率丢失部分数据,而可用性更为重要.
如何检测服务器故障?如何将故障服务器上的数据和服务器自动迁移到群集中的其他服务器?
随着群集的大小变得越来越大,出现故障的可能性也会增加,并且大型群集每天都会发生故障. 容错是分布式存储系统设计的重要目标. 只有实现了自动容错能力,才能降低人工成本,才能达到分布式存储的规模效应.
单个服务器发生故障的可能性不高,但是,只要集群足够大,机器故障每天都会发生,并且系统需要能够自动处理它. 首先,分布式存储系统需要能够检测机器故障. 在分布式系统中,故障检测通常是通过租赁协议来实现的. 接下来,您需要能够将服务器复制或迁移到群集中其他正常服务的存储节点.
租约机制是具有超时授权的授权. 假设机器A需要检测机器B是否发生故障. 机器A可以向机器B发出租赁. 机器B持有的租赁仅在有效期内提供服务,否则将停止服务. 当机器B的租约即将到期时,请重新向机器A申请租约. 在正常情况下,机器B继续申请租约以延长有效期. 当机器B发生故障或机器A的初始蝗虫网络发生故障时,机器B的租约将到期,因此机器A可以确保机器B不再提供服务. B的服务可以安全地迁移到其他服务器.
单层结构和双层结构的故障恢复机制是不同的.

节点故障将影响系统服务. 在故障检测和故障恢复过程中,无法提供写服务和强一致性读服务. 中断时间包括故障检测时间和故障恢复时间两部分. 故障检测时间通常为几秒到十几秒,这与群集大小密切相关. 集群大小越大,故障检测对主控节点的压力越大,故障检测时间越长. 故障恢复时间通常非常短,单层结构的备用副本和辅助副本之间的实时同步得以维持,切换至主副本的时间非常短;双层结构的故障恢复通常仅通过数据索引而不是全部数据加载到内存中来实现.
主控制节点本身也可能失败. 为了实现主控节点的高可用性,主控节点的状态还将实时同步到备用计算机. 发生故障时,可以通过外部服务将备用计算机选为新计算机. 主控制节点以及此外部服务也必须具有高可用性. 为了选择系统中的主服务器或维护重要的全局信息,您可以维护通过Paxos协议实现的一组分布式锁定服务,例如Zookeeper.
在新添加的服务器和群集的正常运行期间如何实现自动负载平衡?如何确保现有服务在数据迁移期间不受影响?
分布式存储系统中的每个集群通常都有一个主控制节点,其他节点是工作节点. 主控制节点基于全局负载信息执行总体调度. 当工作节点处于联机状态时,主控制节点需要将数据迁移到该节点. 此外,系统还需要在系统运行期间连续执行迁移任务,以将数据从负载较高的工作节点迁移到负载较低的工作节点.

工作节点通过心跳数据包向主控制节点发送与节点负载有关的信息,例如CPU,内存,磁盘和网络资源使用情况,读取和写入时间以及读取和写入数据量. 主控制节点计算工作节点的负载信息和要迁移的数据,生成迁移任务并将其放入迁移队列中,等待执行.
负载平衡需要数据迁移操作. 在分布式存储系统中,通常会存储多个数据副本. 一个是主副本,另一个是备份副本. 主副本提供外部服务. 迁移备份副本不会影响服务,迁移主副本也可以先将数据读写服务切换到其他备份副本. 整个迁移过程可以是无缝的,并且对用户完全透明.
分布式系统中涉及许多协议,例如租赁,复制协议,一致性协议等. 其中分布式存储系统,两阶段提交协议和Paxos协议最具代表性. 两阶段提交协议用于确保跨多个节点的操作的原子性,即跨多个节点的操作要么在所有节点上成功执行,要么全部失败. Paxos协议用于确保多个节点同意投票(例如选择一个节点作为主节点).
两阶段提交(2PC)通常用于实现分布式事务. 在两阶段协议中,系统通常包含两种类型的节点: 一种是协调器,通常只有一个系统. 一;另一个是交易参与者(参与者,队列或工作人员),通常包括多个参与者. 该协议假定每个节点将记录操作日志并将其保存到非易失性存储介质中,即使该节点发生故障,该日志也不会丢失. 实现过程如下:
第二阶段,提交阶段. 协调员将根据第一阶段的投票结果做出决定,提交或取消. 当且仅当所有参与者同意提交交易时,协调器才通知所有参与者提交交易,否则协调者通知所有参与者取消交易. 参与者收到协调员的消息后,将执行相应的操作.
提交:
取消:
两阶段提交似乎确实提供了原子操作,但是不幸的是,两阶段提交仍具有一些缺点:
Paxos协议用于解决多个节点之间的一致性问题. 通过多个节点之间的操作日志同步数据. 如果只有一个节点是主节点,则很容易确保多个节点之间操作日志的一致性. 只要保证多个节点之间操作日志的一致性,就可以在这些节点上构建高可用性的全局服务,例如分布式锁定服务,全局命名和配置服务等.
为了获得高可用性,主节点通常以操作日志的形式将数据同步到备用节点. 如果主节点发生故障,则备用节点将其自身推荐为主节点. Paxos协议保证即使同时存在多个提议,它也可以确保所有节点最终将达到一致性并选择唯一的主节点. 以下是一个博客中引用Paxos协议的引言.
在paxos算法中,它分为四个角色: 提议者(提议者),接受者(决策制定者),客户(生产者)和学习者(最终决策学习者). 其中,提议者和决策者非常重要. 在整个算法中,其他两个角色应视为酱油. 提议者就像客户的使者. 提议者信使接受客户的问题向接受者提出建议,让接受者做出决定. 一个新术语出现在这里: 最终决定. 现在,让我们系统地介绍paxos算法中的所有行为:
上述学习者的最终学习目标是接受者最终接受哪些问题?请注意,这里是向所有接受者学习的内容. 如果大多数“接受者”最终接受提议,那么将获得最终结果,并达到算法的目的. 过程如下:


现在通过一个故事(分两个阶段提交)学习paxos算法的过程,有2个客户(老板,老板是竞争关系)和3个接受者(政府官员).
第一阶段:
现在进入提交的第二阶段:
Paxos进程结束. 这样,保证了一致性. 在算法的最后,所有提案都被投票为“ client2获胜”. 所有接受者都接受此问题. 也就是说,在第一,第二阶段,问题是先在先. 是的,无论谁先带头,后来的提议者都会在第一阶段学习此问题并修改自己的议程,因为没有行为,因此可以保证一致性,这是paxos算法的过程. 事实证明,paxos算法中的字符都是如此不可靠的,但是没关系,结果是可靠的. 该算法是追求结果的一致性.
不同的存储系统需要存储各种数据,这些数据可以大致分为: 非结构化数据,例如文本文件,图片,视频和音频格式;可以使用通常存储在关系中的结构化数据. 二维关系表结构指示模式和内容是分开的;对于半结构化数据(例如HTML文档),将模式结构和内容放在一起.
不同的分布式存储系统适用于存储不同的数据.
Internet应用程序需要存储大量非结构化数据对象,例如图片,照片和视频. 这种类型的数据以对象的形式组织,并且对象之间没有关联. 这种数据通常称为Blob(二进制大对象)数据.
分布式文件系统适合存储Blob对象,例如Google的GFS及其开源实现HDFS. 在系统实现级别,分布式文件系统根据数据块组织数据. 每个数据块具有相同的大小. 每个数据块都可以包含我的Blob对象或固定长度的块. 大文件也可以拆分. 放入多个数据块.
分布式键值系统存储具有简单关系的简单和半结构化数据. 它仅为主键(例如Dynamo,Redis和Memcache)提供CRUD功能. 从数据结构的角度来看,分布式键值系统类似于传统的哈希表. 不同之处在于,分布式系统支持将数据分发到群集中的多个存储节点. 分布式键值系统是分布式表系统的简化实现,通常用作缓存. 一致性哈希是分布式键值系统中一种常用的数据分发技术.
分布式表系统用于存储关系更复杂的半结构化数据. 与分布式键值系统相比,分布式表系统不仅支持简单的CRUD操作,而且还支持扫描一系列主键. 分布式表系统以表为单位组织数据. 每个表包括许多行. 行由主键标识. 支持按主键的CRUD功能和范围搜索功能.
分布式表系统利用许多关系技术,例如在某种程度上支持事务. 典型系统,例如Bigtable,HBase和DynamoDB. 与分布式相比,分布式表系统主要用于单个表的操作,并且不支持某些特别复杂的操作,例如多表关联,多表连接和嵌套子查询. 而且,在分布式表系统中,同一表的多个数据行不需要包含相同类型的列,这适用于半结构化数据. 分布式表单系统是一个很好的权衡. 这种类型的系统可能非常,并支持更,但实现起来往往更复杂.
分布式通常从独立的关系扩展为存储结构化数据. 分布式使用二维表来组织数据,提供SQL关系查询语言,支持多表关联,嵌套子查询和其他复杂操作,并提供事务和并发控制. 典型示例包括MySQL集群,Amazon RDS和Microsoft SQL Azure.
参考:
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-208276-1.html
-

-
张开元
-
尧员外
看起来是还可以的说
 易烊千玺在大学借书不还?中戏图书馆透露了消息,粉丝们
 广东新型腐竹机小型腐竹机价格新丰宾馆腐竹机
 分布式存储环境 中国科技大学培养了鄂维南等57位AI与大数据领域的专家
 华为畅享7和荣耀V9Play对比哪个好?看看你喜欢哪款?
只好做一些妥协