内部Hadoop技术: 对MapReduce架构设计和实现原理的深入了解
电脑杂谈 发布时间:2020-05-12 10:07:04 来源:网络整理
这确实是一本非常详尽的书,解释了Hadoop MapReduce的内部操作原理. 遗憾的是,本书在Hadoop 0.20版本中进行了解释深入解析mapreduce架构设计与实现原理,该版本与当前的Hadoop主流版本严重脱节. 但是即使如此,本书中的大多数内容仍然具有参考意义. 毕竟深入解析mapreduce架构设计与实现原理,尽管许多模块随版本的变化而有很大的不同,但核心思想不会改变.
这本书剖析了整个MapReduce,从其设计概念和体系结构到编程应用程序,然后逐步加深了节点之间的RPC通信原理以及作业的执行过程. 本书的后半部分详细介绍了MapReduce管理作业的实现原理和运行过程. 最后,介绍了Hadoop的集群调优和调度程序以及安全机制. 如果您能解决这个问题,您肯定会知道整个MapReduce的,但是不幸的是,我距离它还很远.
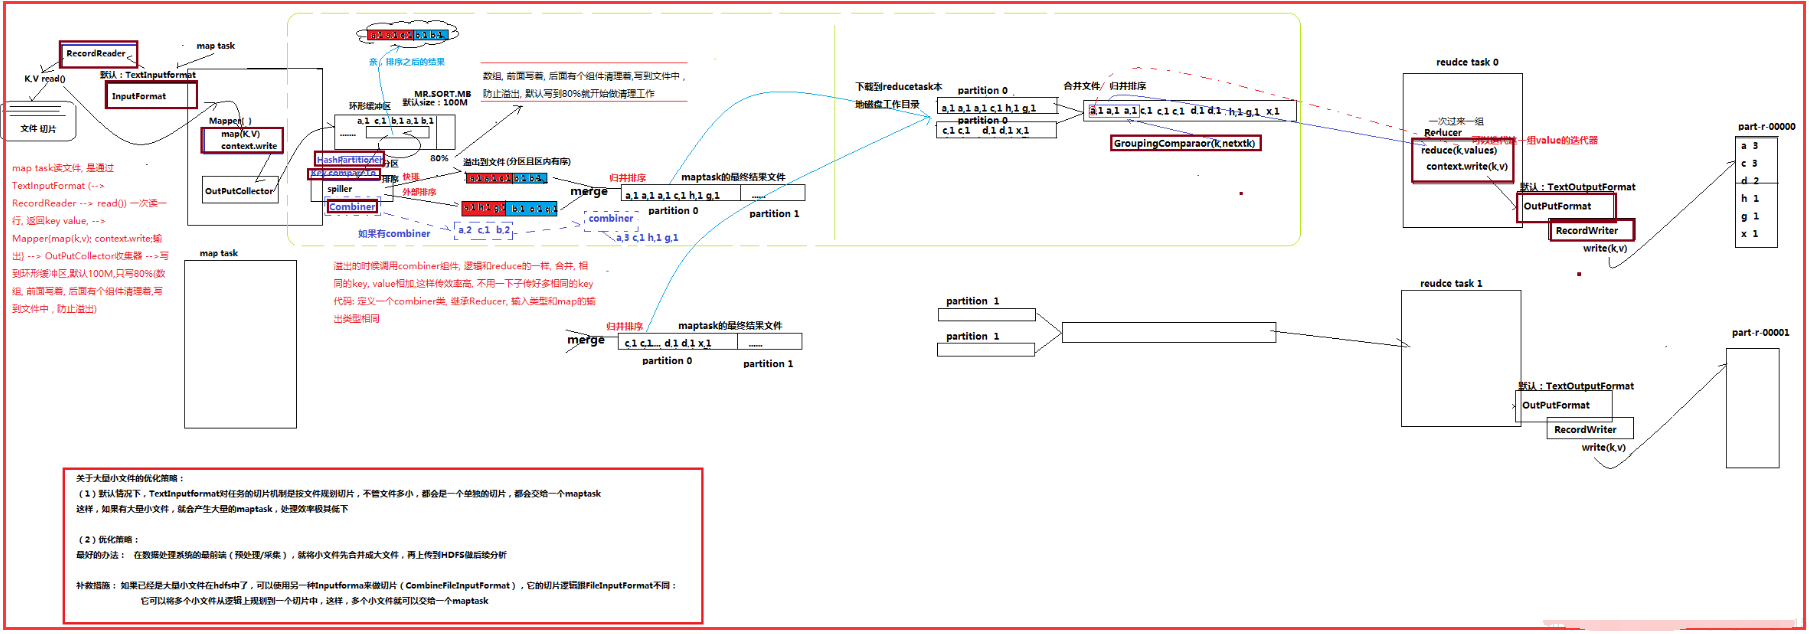
MapReduce的设计思想是将大量数据的分析需求分散到远远超过要在多台计算机上处理的任何计算机的处理能力,并以这种方式解决单个计算机无法解决的问题堆号. MapReduce适用于解决可以将问题分解为多个子问题的问题,这些子问题之间没有耦合关系,可以完全独立地解决任何子问题,从而达到间接解决总问题的目的. MapReduce的基本体系结构可分为Client,JobTracker,TaskTracker和Task. 这些内容基于非常旧版本的体系结构,因此不值得学习和研究,因此我不再赘述.
MapReduce编程模型,主要开放给开发人员编写以下模块

InputFormatPartitionermapperreducerOutputFormat
以上5个组件涵盖了从定制服务的输入到输出的MapReduce作业. 通过自定义上述组件,您基本上可以解决大数据领域中的任何问题.

由于MapReduce扮演着分布式计算模型的角色,因此跨计算机通信是其中的重要组成部分. MapReduce使用RPC通信机制的自定义版本. MapReduce的RPC使用Java的NIO作为其网络通信保证. 实际上,MapReduce RPC的基本体系结构与传统RPC体系结构并没有太大区别. 它们都使用C / S体系结构模型,并由三个组件组成: 1.通信模块; 2.存根程序; 3.计划程序. RPC的发展并不困难,基本上遵循模型学习一次. 有兴趣的人可以参考此博客文章:
MapReduce作业的执行过程非常复杂. 但是实际上,这在作业的初始化和任务的分解方面很复杂. 根据群集的性能和空闲状态将作业分为几部分,并进行分配,然后定期进行监视,这部分属于管理层的任务,这很麻烦. 运行子任务的过程相对简单,只需深入研究即可. 实际上,这也可以扩展到我们的工作中,不用看管理通常不做任何特定的工作,但实际上他们的事务确实不少于那些谁在工作.

下一部分是0.20版中MapReduce作业管理模块的内容. 它详细介绍了JobTrakcer和TaskTracker的源代码实现以及作业管理过程的实现. 它非常详细,但是现在没有太大价值. 没关系.
关于性能调优,作业调度程序和安全性机制,它与普通开发人员相距有点远,而忘记了.
因此,这本书并不重要.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-207306-1.html
-

-
尚哲
那么二炮可以点射犯我之敌
-
晋出公
 win8音频服务未运行怎么办usb音频硬件-驱动与驱动程序大全
 华为畅享5s园卡/插卡? 畅享5s手机sim卡安装图文方法
 大容量存储系统概述
 麦浚龙新片《风林火山》发布 梁家辉演心理专家
真不是个东西