图像技术在直播中的应用(下)-图像识别
电脑杂谈 发布时间:2020-05-08 19:24:53 来源:网络整理
在“图像技术在直播中的应用(第1部分)”中,我们简要介绍了Beauty Technology 1.0的原理和实际问题. 在本文的***中,我们提到了美容2.0人脸识别的最关键技术. 这是一项复杂但非常流行的技术. 在本文中,我们将讨论图像识别,其原理和实际问题. 这个分享系列在建筑师沙龙组织了自绘的CTO演讲.
最近,机器学习和深度学习的概念非常热门,尤其是今年AlphaGo打败了韩国国际象棋棋手,这引起了全世界的轰动. 机器学习和深度学习这两个概念相对容易混淆,因此许多媒体在编写报告时经常将这两个词混在一起. 由于这两个概念当前主要用于图像领域图像识别应用,因此我们仅在图像识别(尤其是面部识别)方面区分这两个概念.
机器学习的概念是较早提出的. 在1990年代初期,人们开始意识到一种更有效地构造模式识别算法的方法,即用数据代替专家(可以通过廉价的劳动力收集获得)(对图像有很多知识的人). 深度学习可以看作是机器学习的一个分支,在过去的十年中,它只是受到了广泛的关注和发展.
让我们谈谈具体差异.
首先,机器学习根据像素特征识别对象. 我们将收集大量的图像材料,然后选择一种算法,使用该算法解析数据,从中学习,然后对现实世界中的事件做出决策和预测.

深度学习可视为机器学习的一个分支,在过去的十年中它仅受到广泛的关注和发展. 它与机器学习的不同之处在于,它模拟了人类识别人脸的方式. 例如,神经科学家发现,当我们人类识别出某种事物并观察到某种事物时,边缘检测类别的神经元会首先做出反应,这意味着我们在观察物体时总是首先观察到边缘. 这样,经过科学家的大量观察和实验,得出的结论是,人眼识别的核心模式是基于从简单级别到复杂级别的特殊级别的抓取. 此过渡级别是一个抽象的迭代过程. 深度学习模拟了人类观察物体的方式. 首先,我们在Internet上获得了大量数据. 得到它之后,我们有大量的样本. 抓住大量样本进行训练,捕获核心功能并构建网络,因为深度学习是要构建多层神经网络,因此必须有许多层. 一些简单的算法可能只有四到五层,但是有些则更复杂,例如刚才提到的Google,它有一百多个层. 当然,其中一些层将进行一些数学计算,而某些层将进行图像预算. 通常,随着级别的降低,功能将变得越来越抽象.

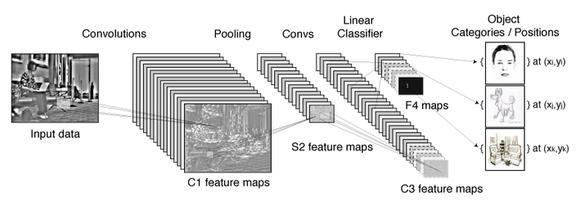
例如,识别一张脸. 如果在特定环境中是人脸,则遇到云层或雾气,或者被树部分遮挡,则人脸变得模糊,并且无法识别基于像素的像素特征的机器学习. 它太僵硬,很容易受到环境条件的干扰. 深度学习打破了所有要素,然后使用神经元“检查”: 面部特征,典型的脸型等等. ***,神经网络将根据各种因素和各种元素的权重,即该图像成为人脸的可能性,进行深思熟虑的猜测.
因此,深度学习在面部识别和各种识别性能方面比机器学习更好,甚至超过了人类的识别能力. 例如,在2015年,Google发布了一个用于人脸检测的Facenet网络,声称该网络可以实现98%以上的识别率. 而且我们人类自己可以看到样本的正确率,但这不是***,甚至某些使用深度学习算法的最先进技术也具有很高的准确性.
就机器学习而言,当前基于面部检测的主流计算是HOG算法和其他算法(如LBF功能). LBF是OpenCV. OpenCV是一个非常著名的开源库. 它具有与图像处理相关的各种功能,并且是开源的. 但是,它对移动平台的效果不佳,无法实现我们想要的效果. 这里提到它是因为它非常有名,并且包含与图像处理有关的各种功能,例如特殊处理,面部识别,对象识别等. OpenCV包含LBF算法的实现.

有很多用于深度学习的开源框架,例如Caffe和TensorFlow. 这些框架仅提供用于构建深度学习网络的工具,但是深度神经网络是最关键的事情. 如何构建网络?有很多方法可以构建网络. 例如,如果您注意这方面,通常会发现一些名词. CNN,RNN,CNN可能很热门,它是人脸识别中非常出色的网络. 现在,它也是一个相对主流的网络. 当然,还有许多网络,例如RNN或更快的CNN网络等,在解决某些特定问题时具有更好的性能.
第二,图像识别的一些具体实现-以智能识别为例
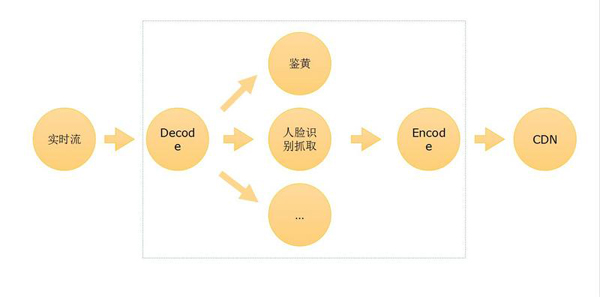
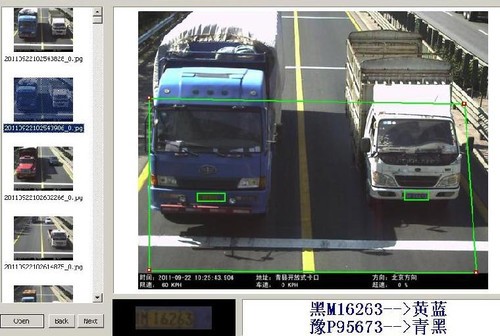
有了相关的深度学习技术,我们可以在服务器端构建应用程序. 例如,进行智能,一路输入视频流,解码后得到每一帧,识别出有问题的部分并进行处理;例如,放置一个镶嵌图或保存内容,然后向背景发送通知以告知背景此处出现了似乎难以描述的内容,等等,然后对其进行编码并将其输出到其他位置,例如分发到CDN等. 如果手动识别这些过程非常昂贵,则必须通过技术手段加以解决.
***谈谈手机体验: 彩绘产品在人脸检测性能方面的测试指标. 例如,我们在iOS和Android平台上进行的测试表明,在iPhone 6上,40个特征点捕获花费了40毫秒,相当于一秒钟内25帧. 当然,您不需要那么多次. 由于视觉的持久性,人眼观察事物. 一般来说,12帧是分隔线. 如果小于12帧,则可以感觉到图像冻结,但是只要大于12帧,请参阅连续. 因此,我们通常将其限制为17或8个测试,这在iOS上就足够了. 就Android而言,性能确实比iOS平台差. 无论是API封装还是整个硬件的匹配,它都可以是相同的GPU模型. 在Android设备上使用时,它无法获得与iOS相同的性能. iOS平台的确在各个方面都优于Android. 小米5是一个相对较新的设备,要花费40毫秒才能捕获40个特征点.
三,技术的发展瓶颈-***仍在争夺硬件
尽管在手机方面,例如iOS 9,深度学习API已启动,并且iOS 10已升级以提供更;但总的来说,我们是在PC上进行开发和培训的,直到代码准备就绪,然后在移动设备上运行它. 因为如前所述,机器学习和深度学习发展中非常关键的部分是培训.
培训是什么意思?
例如,我拍摄了10,000张照片以识别所有面孔,并处理了10,000个样本以获取经验. 脸部的特征是什么(例如涉及150个参数),获得了一个函数,并且在调整模型后获得了一个函数,然后对这些模型进行训练和测试以获得更好的模型. 接下来,找到大量测试数据,例如10,000条测试数据,以检测该模型. 如果运行良好,则说明该数据模型网络是可靠的,并且在实践中使用***.
但是此培训过程非常耗时. 我们进行了培训,CPU可能需要20到30个小时. 这仍然是一个简单的模型,有些复杂的模型,例如Google的125层神经网络,如果您使用CPU来运行,则可能需要三到四天的时间,这相当于在很长一段时间后得到一个模型,只知道这种模式是好是坏. 如果发现它不起作用图像识别应用,则已更改了一个较小的参数,结果将继续运行三到四天. 因此,唯一的解决方案是升级硬件. 例如,GPU取代了CPU以完成操作.
这里是详细指标的列表. 例如,某些算法需要在RGB空间中进行测试. 有没有难以形容的内容?如果我们使用GTX 980 Ti来运行,那么在i7 CPU上运行,它可以不到20毫秒一帧,这是800秒,这与GPU的运行是完全无法比拟的. 但是问题是专用于训练的GPU设备非常昂贵. 七千美元或八千美元的GPU在机器训练中并不好,并且为了不延迟复杂场景(例如AlphaGo训练)中的时间,您只能用大量的设备弥补这一费用. 这就是为什么只有具有一定优势的公司才能进行深度学习.
目前,世界上一些主流大公司(例如Microsoft)将许多FPGA服务用于包括云服务在内的许多服务. 百度也在做基于算术单元的芯片,而中国科学院也在做相关研究. 因此,深度学习一直在发展,事实上,它一直被卡在计算中,而计算能力远远落后于我们软件的要求,而***已成为硬件竞争的时代. 但是实际上,这个问题不仅是最近的. 早在人工智能的出现,神经网络的概念就已经存在,但是神经网络对“智能”的贡献很小,主要问题是计算能力不足. 因此,现在每个人都可以预见,一旦量子计算成为可能,那么人工智能时代就会真正到来.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-203288-1.html

 windows 内核编程黑客..黑客.微信:
 HBV DNA定量检测的正常范围是什么
 部: 要花三年时间才能实现国家户口和公民编号的唯一性
 原版镜像和Ghost差别很大吗?Ghost系统与原版系统的区别
变姐姐粉了