SEO基本条目搜索引擎的工作原理
电脑杂谈 发布时间:2020-05-03 01:03:11 来源:网络整理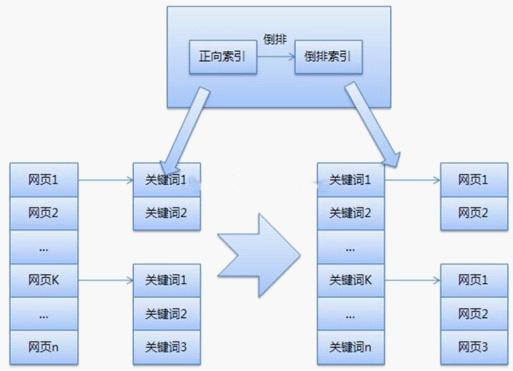
搜索引擎的工作原理可以分为三个部分:
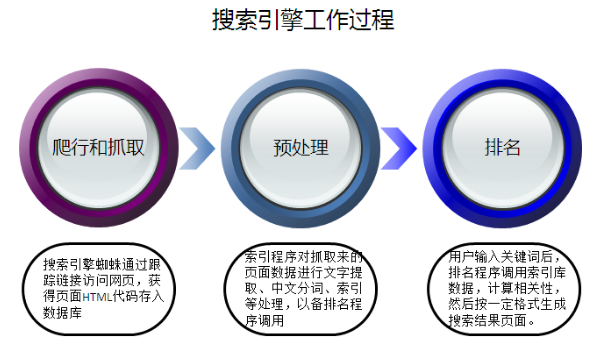
第1部分: 搜索引擎发送蜘蛛以在Internet上发现和收集网页信息,也称为“爬行”.
搜索引擎Spider会跟踪网页中的超链接,从网站的首页爬网到网站的其他页面,或者从该网站爬网到另一个网站,并通过超链接分析不断地爬网更多页面. . 爬网的网页称为“快照”. 在Internet中,超链接是各个页面之间的链接. 从理论上讲,搜索引擎蜘蛛可以收集大多数网页. (但是,由于某些操作错误或其他原因,始终会有某些页面未被蜘蛛抓取. 要进行SEO,蜘蛛会在我们的网站上抓取更多页面. )
搜索引擎蜘蛛的工作原理有两个方面:
①深度优先.

深度优先表示当蜘蛛到达页面时,它会找到一个锚文本链接,即爬网到另一个页面,然后在另一个页面上找到另一个锚文本链接,然后爬网直到最终完成此操作. . 网站. 如图所示:

②广度优先.
广度优先级是在爬虫到达页面后,发现没有直接输入锚文本,而是爬行了整个页面,然后将所有锚文本的另一页一起输入,直到整个网站被抓取.
不同的搜索引擎具有不同的蜘蛛:
百度蜘蛛: 百度蜘蛛,包括百度蜘蛛图像(抓取的图片),百度蜘蛛手机(抓取的wap),百度蜘蛛视频(抓取的视频),百度蜘蛛新闻(抓取的新闻)

Google Spider: Googlebot
360 Spider: 360Spider
搜狗蜘蛛: 搜狗新闻蜘蛛.
Sogou蜘蛛还包括以下内容: Sogou Web蜘蛛,Sogou Inst蜘蛛,Sogou spider2,Sogou博客,Sogou News蜘蛛,Sogou Orion蜘蛛
SOSO蜘蛛: Sosospider
Yahoo Spider: Yahoo! Slurp中国
Youdao蜘蛛: YoudaoBot或YodaoBot

MSN Spider: msnbot-media
Bing Spider: bingbot.
搜寻蜘蛛: YisouSpider.
Alexa Spider: ia_archiver.
Yishou Spider: EasySpider.
直接蜘蛛: JikeSpider.

第2部分: 处理网页,提取信息,组织和建立索引以及从搜索引擎中删除垃圾内容.
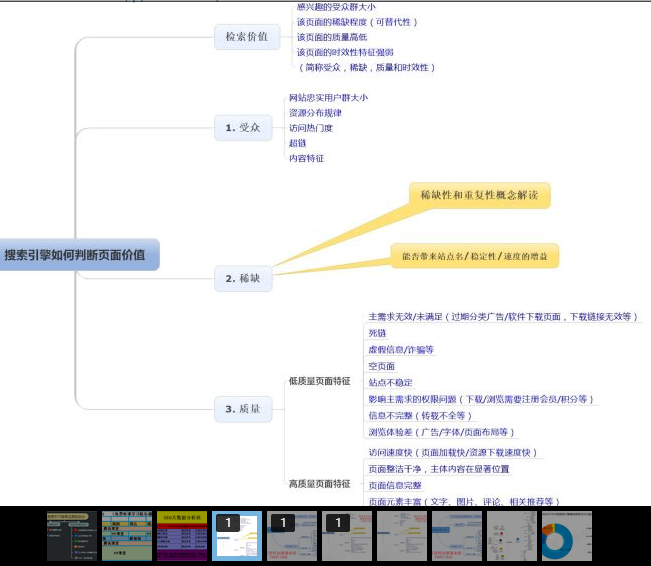
在搜索引擎捕获网页之后,需要进行大量预处理工作才能提供搜索服务. 其中,最重要的是提取关键字,建立索引库和索引. 其他包括删除重复的网页,分词(中文),判断网页类型,分析超链接以及计算网页的重要性/数量. 在此过程中,搜索引擎将从其自己的中删除低质量的内容搜索引擎原理 视频,并保留高质量的内容.
在此会议中,作为网站管理员,SEOer必须做好网站内容并提高网站内容的质量.
第3部分: 提供搜索服务并显示网站排名.
当用户输入要搜索的关键字时,搜索引擎会从索引中找到与该关键字匹配的网页;为了方便用户,除网页标题和URL外,还将提供网页摘要和其他信息. 搜索器根据用户输入的查询关键词,快速检测索引库中的文档,评估文档与查询的相关性,对输出结果进行排序搜索引擎原理 视频,然后将查询结果返回给用户.
注意: 仅爬行网站页面的蜘蛛不一定是排名,而是需要由搜索引擎进行审查,也就是说,如果它们包含在搜索引擎中,则将对它们进行显示和排名.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-197033-1.html
-

-
武瓘
-
宋伟
苏死的梨涡
-
朱瑞娜
都被人打残了
-
 weixin_30480583
 计算机OCR字符识别技术的原理和未来发展趋势
 semaphore java.util.concurrent常用类(Cou
 C语言中的Static和内联函数
希望能有所帮助