MapReduce执行过程和随机播放过程
电脑杂谈 发布时间:2020-04-30 16:13:00 来源:网络整理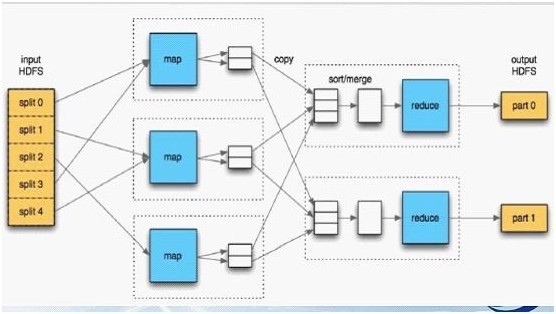
本节将主要从MapReduce作业执行过程和Shuffle过程方面介绍Hadoop MapReduce的工作机制. 通过加深对MapReduce工作机制的理解,程序开发人员可以使用MapReduce更加合理地解决实际问题. Hadoop MapReduce作业执行过程整个Hadoop MapReduce作业执行过程如图1所示,分为10个步骤.
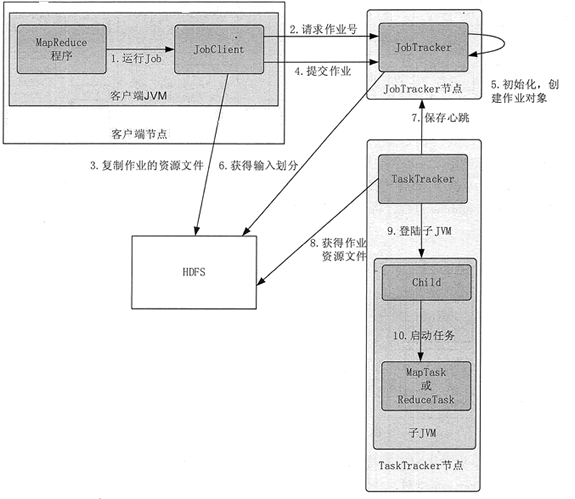
图1 Hadoop MapReduce的作业执行流程
1. 提交工作客户将工作提交给JobTracker. 首先,用户需要根据需要配置所有应配置的参数. 作业提交后,将自动执行. 在此过程中,用户只能监视程序的执行并强行中断作业,而不能干预作业的执行. 提交作业的基本过程如下.
1)客户端通过Runjob()方法启动作业提交过程.
2)客户端通过JobTracker的getNewJobId()请求新的工作ID.
3)客户端检查作业的输出描述,计算作业的输入碎片等. 如果有问题,它将引发异常,如果正常,它将运行作业所需的资源(例如作业Jar文件,配置文件,计算出的输入片段等)复制到以作业ID命名的目录.
4)通过调用JobTracker Submitjob()方法告知要执行的作业. 2.初始化作业JobTracker在JobTracker端开始初始化工作,包括在其内存中建立一系列数据结构以记录该作业的运行状态.
1)JobTracker收到对其SubmitJob()方法的调用后,会将调用放入内部队列中,并将其移交给作业调度程序进行调度. 初始化主要是为了创建一个代表正在运行的作业的对象,以便跟踪任务的状态和进度.

2)为了创建任务运行列表,作业调度程序首先从HDFS获取JobClient计算出的输入分片信息,然后为每个分片创建MapTask,并创建ReduceTask. 3.分配的任务JobTracker将询问HDFS NameNode数据在哪个文件中以及这些文件分散在哪个节点中. JobTracker需要根据“附近运行”的原则分配任务.
TaskTracker通过“心跳”定期与JobTracker进行通信,主要是通知JobTracker是否仍在运行以及是否准备运行新任务.
JobTracker收到心跳信息后,如果有要分配的任务,它将为TaskTracker分配一个任务,并将分配信息封装在心跳通信的返回值中,然后将其返回给TaskTracker.
对于Map任务,JobTracker通常选择最接近其输入分片的TaskTracker. 对于Reduce任务,JobTracker无法考虑数据的本地化. 4.执行任务1)将TaskTracker分配给任务后,将作业Jar文件通过HDFS复制到TaskTracker所在的文件系统中,同时TaskTracker从分布式缓存中复制应用程序所需的所有文件到本地磁盘. TaskTracker为该任务创建一个新的本地工作目录,并将Jar文件的内容提取到该文件夹中.
2)TaskTracker启动一个新的JVM以运行每个任务(包括Map任务和Reduce任务),以便JobClient的MapReduce不会影响TaskTracker守护程序. 任务的子进程每几秒钟将其进度通知父进程,直到任务完成. 5.流程和状态更新作业和每个任务都有状态信息,包括作业或任务的运行状态,Map任务和Reduce任务的进度,计数器值,状态消息或描述. 在任务运行时,请跟踪其进度.
这些消息以一定的时间间隔从ChildJVM聚合到TaskTracker,然后聚合到JobTracker. JobTracker将生成一个全局视图,指示所有正在运行的作业及其任务的状态,用户可以通过Web UI对其进行查看. JobClient每秒查询JobTracker以获得最新状态,并将其输出到控制台. 6.作业的完成当JobTracker收到的关于该作业的最后一个任务完成时,它将把作业的状态更改为“成功”. 当JobClient获得作业的状态时,它知道该作业已成功完成,然后JobClient打印一条消息以通知用户该作业已成功结束,最后从Runjob()方法返回. HadoopMapReduce的Shuffle阶段Hadoop MapReduce的Shuffle阶段是指从Map的输出开始的过程,包括执行排序的系统,然后将Map的输出传输为Reduce作为输入.
排序阶段是指对从Map端输出的键进行排序的过程. 不同的Map可能会输出相同的Key,并且必须将相同的Key发送到相同的Reduce端进行处理. Shuffle阶段可分为Map侧的Shuffle阶段和Reduce侧的Shuffle阶段. Shuffle阶段的工作过程如图2所示. 1. Map一侧的Shuffle阶段1)每个输入片段将由Map任务处理. 默认情况下,HDFS块的大小(默认为64MB)为片段. 当Map函数开始产生输出时,这不仅仅是将数据写入磁盘,因为频繁的磁盘操作将导致严重的性能下降. 其处理过程是先将数据写入内存中的缓冲区,然后进行一些预排序以提高效率.
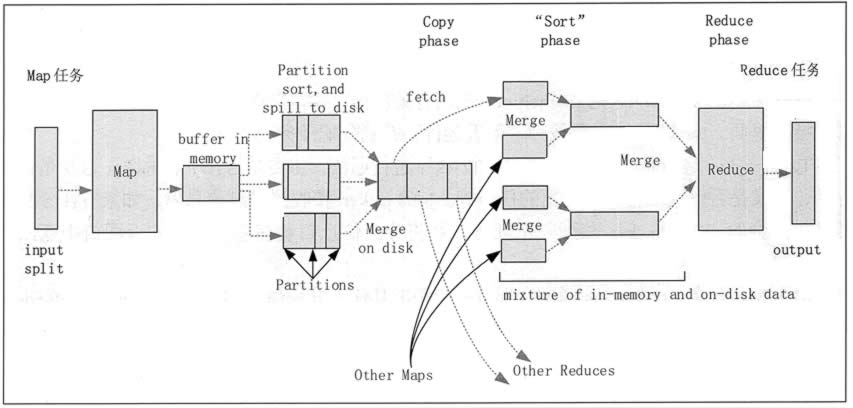
图2 Hadoop MapReduce的随机播放阶段

2)每个Map任务都有一个循环内存缓冲区,用于写入输出数据(默认大小为100MB). 当缓冲区中的数据量达到某个阈值(默认值为80%)时,系统A后台线程将启动以将缓冲区的内容写入磁盘(即Spill阶段). 在磁盘写入过程中,Map输出将继续写入缓冲区,但是如果在此期间缓冲区已满,则Map任务将阻塞,直到磁盘写入过程完成为止.
3)在写入磁盘之前,线程首先根据将数据最终传输到的Reduce任务将数据划分为相应的分区. 在每个分区中,后台线程均按Key排序. 如果有组合器,它将在排序的输出上运行.
4)一旦内存缓冲区达到溢出写阈值,就会创建一个溢出写文件,因此Map任务完成其最后的输出记录后,将有多个溢出写文件. 在完成Map任务之前,将溢出写文件合并到索引文件和数据文件中(多路合并排序)(排序阶段).
5)溢出写文件的合并完成后,Map任务将删除所有临时溢出写文件,并通知TaskTracker该任务已完成. 一旦完成Map任务之一,Reduce任务将开始复制其输出(复制阶段).
6)Map任务的输出文件放置在运行Map任务的TaskTracker的本地磁盘上. 它是TaskTracker运行Reduce任务所需的输入数据. 2. Reduce端的Shuffle阶段1)Reduce进程启动一些数据复制线程,并请求Map任务所在的TaskTracker获得输出文件(Copy阶段).
2)首先将从Map端复制的数据放入存储缓冲区. 合并具有三种形式,即内存到内存,内存到磁盘和磁盘到磁盘. 默认情况下,第一个窗体未启用,第二个窗体一直运行(溢出阶段),直到结束,而第三个窗体生成最终文件(合并阶段).
3)最终文件可能存在于磁盘或内存中,但默认情况下位于磁盘上. 还原的输入文件完成后,整个随机播放阶段结束,然后执行还原以将结果放入HDFS(还原阶段). Hadoop MapReduce的主要特征设计中MapReduce的主要技术特征如下.
1. 水平扩展到“外部”,而不是垂直扩展到“上”
MapReduce集群的构建完全选择了便宜且易于扩展的低端商用服务器,而不是昂贵且难以扩展的高端服务器.

对于数据处理,由于需要大量数据存储hadoop运行mapreduce作业的工作原理,因此基于低端服务器的群集要比基于高端服务器的群集优越得多. 这就是为什么MapReduce并行计算集群是基于低端服务器实现的.
2. 失败被认为是正常的
MapReduce集群中使用了大量的低端服务器. 因此,节点硬件故障和软件错误已成为常态. 因此,设计良好且容错能力强的并行计算系统不会由于节点故障而影响计算服务的质量.
任何节点的故障都不应导致结果不一致或不确定. 当任何节点发生故障时,其他节点必须能够无缝接管发生故障的节点的计算任务. 恢复故障节点后,它应该能够自动无缝加入群集,而无需管理员手动配置系统.
MapReduce并行计算软件框架使用了多种有效的错误检测和恢复机制,例如自动节点重启技术,从而使集群和计算框架具有处理节点故障的鲁棒性,并可以有效地处理检测和检测故障节点数. 恢复.
3. 将处理迁移到数据
传统的高性能计算系统通常具有许多连接到某些外部存储节点的处理器节点,例如通过存储区域网络连接的磁盘阵列. 因此,当进行数据处理时,外部文件数据的I / O访问将成为限制系统性能的瓶颈.
为了减少数据并行计算系统中的数据通信开销,不应将数据传输到处理节点,而应考虑使其更接近数据并进行迁移. MapReduce采用数据/代码相互定位的技术方法. 计算节点将首先尝试计算本地存储的数据,以利用数据本地化功能. 仅当节点无法处理本地数据时,才使用最近的原理来查找其他可用数据. 计算节点并将数据传输到可用的计算节点.
4. 顺序处理数据以避免随机访问数据

数据处理的特征决定了大量数据记录很难全部存储在内存中,并且通常只能在外部存储中进行处理. 由于顺序访问磁盘比随机访问要快得多,因此MapReduce主要用于顺序访问数据的磁盘访问处理.
为了实现高吞吐量的并行处理,MapReduce可以使用集群中的大量数据存储节点来同时访问数据,从而使用分布式集群中的大量节点上的磁盘收集来提供高带宽数据访问和传输.
5. 隐藏应用程序分发者的系统层详细信息
程序员难以编写程序的原因是,程序员需要记住太多的编程细节,这是大脑记忆的巨大认知负担,需要高度专注,而并行程序编写则更加困难
例如,您需要考虑复杂而繁琐的细节,例如多线程中的同步. 由于并发执行的不可预测性,调试和调试程序也非常困难,程序员需要考虑许多细节,例如数据分发和存储管理,数据分发,数据通信和同步以及在大型应用程序期间收集计算结果. 规模数据处理.
MapReduce提供了一种抽象机制,可将程序员与系统层的细节隔离开. 程序员只需要描述需要计算的内容,并将特定的计算方法移交给系统的执行框架hadoop运行mapreduce作业的工作原理,以便程序员可以从系统层的细节中解放出来,并致力于算法设计及其应用计算问题.
6. 平滑无缝的可扩展性
此处指示的可伸缩性主要包括两层可伸缩性: 数据可伸缩性和系统可伸缩性.
理想的软件算法应能够随着数据规模的扩展而显示出连续的有效性,并且性能下降的程度应与数据规模扩展的倍数相当. 在集群规模上,该算法的计算性能应能够达到. 节点数的增加保持接近线性增长.
绝大多数现有的独立算法都不能满足上述理想要求. 从内存到大型基于集群的并行计算,从根本上需要完全不同的算法设计,因此在大型数据处理期间,将中间结果数据保存在内存中的独立算法将很快失败.
但是,MapReduce在许多情况下都可以实现上述理想的可伸缩性. 对于许多计算问题,基于MapReduce的计算性能可以随着节点数量的增加而保持近似线性增长.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-194248-1.html
-

-
李浩
奥巴马这是在转移视线
-
小悟
美国这艘驱逐舰的综合战斗力
 如何在单词中设置数字的千位分隔符?两种轻松完成的方式
 如何编写图书管理系统 河北宏润钢木家具
 SpringBoot AOP(方面注释方法)的详细说明
 为什么有人写计算机病毒
有实战意义