数据结构回顾7: 搜索搜索算法的树形表
电脑杂谈 发布时间:2020-04-25 17:23:36 来源:网络整理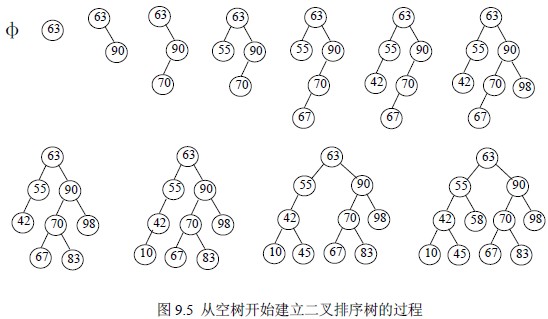
也称为二叉树搜索树,它是一种特殊的二叉树,对排序和搜索都非常有用.
二进制排序树是具有以下属性的空树或二进制树:
(1)如果其左子树不为空,则左子树上所有节点的值均小于其根节点的值;
(2)如果右子树不为空,则右子树上所有节点的值都大于其根节点的值;
(3)它的左和右子树也是二进制排序树.
二进制排序树是递归定义的. 根据定义,可以得到二进制排序树的重要属性: 以中间顺序遍历二进制排序树时,可以获得节点值增加的有序序列.
以下是二进制排序树的二进制链接列表的存储表示形式:
typedef struct{
    KeyType key;        //关键字项
    InfoType otherinfo; //其他数据项
}ElemType;
typedef struct BSTNode{
    ElemType data;      //每个结点的数据域包括关键字项和其他数据项
    struct BSTNode *lchild,*rchild; //左右孩子指针
}BSTNode,*BSTree;
(1)如果树为空,则搜索失败并返回空指针;
(2)如果树不为空二叉排序树时间复杂度,则将给定值键与根节点的关键字T-> data.key进行比较:
>如果key等于T-> data.key,则搜索成功并返回根节点地址;
>如果key小于T-> data.key,则递归搜索左子树;
>如果key大于T-> data.key,则递归搜索右子树.
BSTree SearchBST(BSTree T,KeyType key){
    if((!T)||key==T->data.key) return T;
    else if(key<T->data.key) return SearchBST(T->lchild,key);
    else return SearchBST(T->rchild,key);
}
根据搜索过程,我们可以知道,在二进制排序树上查找等于给定值的键的过程恰好是从根节点到节点的过程,这与二进制搜索类似,但是不同之处在于,相同的数据可能会构建不同种类的二进制排序树. 最好的情况是构建的二进制排序树与二进制搜索的决策树相同. 最坏的情况是二进制排序树是: 当构建单个树时,平均而言,可以考虑
二进制排序树上的搜索与二进制搜索没有太大区别,但是在维护表的顺序方面,二进制排序树更有效,插入和删除操作更方便.
二进制排序树的插入操作基于搜索. 将具有键作为键的节点插入树中. 您需要从根节点向下搜索. 没有节点的键等于书中的键. 仅在插入时. 新插入的节点必须是新添加的叶节点,并且是搜索失败时在搜索路径上访问的最后一个节点的左或右子节点.

(1)如果二进制排序树为空,则将插入的节点* S作为根节点插入到空树中.
(2)如果二进制排序树不为空,则将密钥与根节点的密钥T-> data.key进行比较
>如果key小于T-> data.key,则在左子树中插入* S;
>如果key大于T-> data.key,则在右边的子树中插入* S;
void InsertBST(BSTree &T,ElemType e){
    if(!T){
        S=new BSTNode;
        S->data=e;
        s->lchild=S->rchild=NULL;
        T=S;
    }
    else if(e.key<T->data.key) InsertBST(T->lchild,e);
    else if(e.key>T->data.key) InsertBST(T->rchild,e);
}
基本过程是搜索,时间复杂度也相同,为O(log2n).
二进制排序树的创建从受控的二进制排序树开始. 输入每个节点,并在执行搜索操作后,将该节点插入当前二进制排序树的适当位置.
(1)将二进制排序树T初始化为空树;
(2)读入一个关键字为key的节点;
(3)如果所读取的关键字键不是输入结束标记,则循环执行以下操作:
>将此节点插入二进制排序树T;
>读入一个键为key的节点.
void CreatBST(BSTree &T){
    T=NULL;
    cin>>e;
    while(e.key!=ENDFLAG){    //ENDFLAG为自定义的输入结束标志
        InsertBST(T,e);    //将此结点插入二叉排序树中
        cin>>e;
    }
}
插入节点的算法的时间复杂度为O(log2n),插入n个节点的时间复杂度为O(nlog2n).
首先从树的根节点开始查找要删除的节点. 如果树中不存在该节点,则不执行任何操作;否则,请执行任何操作. 否则,假设已删除的节点为* p,其父节点为* f,PL和PR分别表示其左和右子树,令* p为* f的左子节点(右子节点的情况为类似). 它可以分为以下三种情况:
(1)* p节点是叶节点,只需直接将其删除: f-> lchild = NULL;
(2)* p节点仅具有左子树PL或右子树PR. 在这种情况下,将PL或PR直接称为* f的左子树: f-> lchild = p-> lchild(或者f-> lchild = p-> rchild);
(3)* p节点周围的子树不为空. 有两种处理方法:

1>从* p节点的左子节点开始,一直到右侧,末尾的节点是* s,令* p的左子树为* f的左子树,而* p的右子树为* p是* s的右子树: f-> lchild = p-> lchild; s-> rchild = p-> rchild;
2>让* p的直接前任(或直接后继)替换* p,然后从二进制排序树中删除其直接前任(或直接后继). 当用直接前驱* s替换* p时,由于* s仅具有左子树SL(或可能没有),因此在删除* s后,只需将SL成为* s父* *的右子树即可: >数据; q-> rchild = s-> rchild;
由于前一种处理方法可能会增加树的深度,因此以下代码使用第二种方法.
void DeleteBST(BSTree &T,KeyType key){
    p=T;
    f=NULL;
    while(p){   //查找关键字等于key的结点*p
        if(p->data.key==key)break;
        f=p;
        if(p->data.key==key>key) p=p->lchild;
        else p=p->rchild;
    }
    if(!p)  return; //找不到被删结点返回
    q=p;
    if((p->lchild)&&(p->rchild)){   //被删结点左右子树均不为空
        s=p->lchild;
        while(s->rchild){
            q=s;
            s=s->rchild;    //向右到尽头
        }
        p->data=s->data;
        if(q!=p) q->rchild=s->lchild;   //s是p的左孩子向右走到尽头
        else q->lchild=s->lchild;       //s恰好是p的左孩子
        delete s;
        return;
    }
    else if(!p->rchild){
        p=p->lchild;
    }
    else if(!p->lchild){
        p=p->rchild;
    }
    if(!f) T=p;
    else if(q==f->lchild) f->lchild=p;
    else f->rchild=p;
    delete q;
}
删除过程也是一个搜索,时间复杂度也是O(log2n).
平衡二叉树是一种特殊的二叉排序树,定义如下:
平衡的二叉树或空树,或具有以下特征的二叉排序树:
(1)左右子树的深度之差的绝对值不超过1;
(2)左右子树也是平衡二叉树.
平衡因子: 节点左右子树的深度之差.
在创建平衡二叉树的开始,就创建了二叉树. 如果在插入节点后破坏平衡二叉树的特性,则需要调整平衡二叉树.
调整方法是: 找到最靠近插入节点的祖先节点,并且平衡因子的绝对值超过1,将以此节点为根的子树称为最小不平衡子树,可以将重新平衡的范围限制为这个子树.
通常,失衡后的调整规则可以概括为以下四个,以的形式给出:


关键是要始终记住节点之间的大小关系,以便您可以了解如何连接旋转的树.
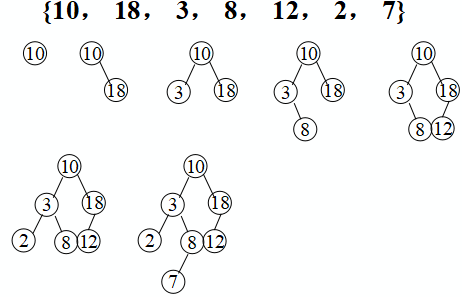
实际上,找到最靠近插入节点的祖先节点,并且平衡因子的绝对值超过1.
以前的线性表搜索,二进制排序树,二进制平衡树搜索和其他搜索方法适用于存储在计算机内存中的较小文件,统称为内部搜索方法. 内部搜索方法以节点为单位进行搜索,因此需要反复交换内部和外部存储,这非常耗时. 磁盘管理系统中的大多数目录管理和系统中的索引组织都使用B树,B树是适合外部搜索的平衡多分支树.
满足以下特征的m级B树,空树或m元树:
(1)树中的每个节点最多具有m个子树;
(2)如果根节点不是叶节点,则至少有两个子树;
(3)除根以外的所有非终端节点都至少具有m / 2个子树;
(4)所有叶节点都出现在没有信息的同一级别上,通常称为故障节点. (故障节点不存在,指向这些节点的指针为空. 引入故障节点是为了便于对B树的搜索性能进行分析);
(5)所有非终端节点最多具有m-1个关键字,其结构如下所示:
B树节点结构
其中ki是关键字,ki B树具有平衡,有序和多渠道的特征 搜索过程类似于二进制排序树,从根开始,根据大小关系,确定要找到的记录所在的节点,然后在目标节点上执行顺序搜索. 如果找到叶节点,则手册中没有记录,搜索失败. 假定节点类型定义如下:
#define m 3         //B-树的阶,暂设为3
typedef struct BTNode{
    int keynum;             //结点中关键字的个数,即结点的大小
    struct BTNode *parent;  //指向双亲结点
    KeyType k[m+1];         //关键字向量,0号单元未用
    strcut BTNode *ptr[m+1];//子树指针向量
    Record *recptr[m+1];    //记录指针向量,0号单元未用
}BTNode,*BTree;
typedef struct{
    BTNode *pt;             //指向找到的结点
    int i;                  //1..m,在结点中的关键字序号
    int tag;                //1:查找成功,0:查找失败
}Result;                    //B-树的查找结果类型
将给定值键与根节点的每个关键字进行比较. 由于关键字序列是有序的,因此搜索时可以使用顺序搜索或半查找. 搜索时:
(1)如果key = ki,则搜索成功;
(2)如果键为 (3)如果ki (4)如果key> kj(1 <= j <= m-1)二叉排序树时间复杂度,继续向下搜索指针pj指向的子树. 如果在自上而下的搜索过程中找到了设置为关键字的关键字,则搜索成功;否则,搜索成功. 如果找不到叶节点,则搜索失败. (1)在B树中找到给定关键字的记录. 如果搜索成功,则插入操作失败;否则,插入操作将失败. 否则,将新记录作为空指针ap插入到失败搜索的叶节点上方的节点(由q指向); (2)如果在插入新记录和空指针之后,q所指向的节点的关键字数目不超过m-1,则说明插入操作成功,否则执行步骤(3); (3)节点的m / 2(向上舍入)关键字k(m / 2)是分割点,节点分为3部分: k(m / 2)左部分,k(m / 2),k的右半部分(m / 2). k(m / 2)的左部分保留在原始节点中; k(m / 2)的右部分存储在新创建的节点(由ap指向)中;关键字值为k(m / 2)的记录将指针ap插入q的父节点. 由于将新记录添加到q的父节点,因此必须对q的父节点重复(2)和(3)的操作,依此类推,直到q指向的节点是根节点为止. (4); (4)由于根节点没有父节点,因此拆分产生的两个节点的指针ap和q和具有键k(m / 2)的记录构成一个新的根节点. 此时,B-的高度增加了1. (代码中描述的q和i源自搜索功能SearchBTree返回的信息)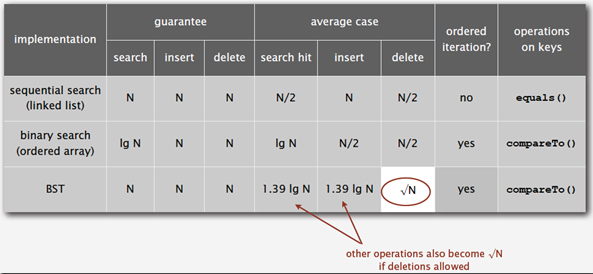
Result SearchBTree(BTree T,KeyType key){
    p=T;
    q=NULL;
    found=false;
    i=0;
    while(p&&!found){
        i=Search(p,key);    //在p->k[1..keynum]中查找i,使得:p->k[i]<=key<p->[i+1]
        if(i>0&&p->k[i]==key) found=true;
        else {
            q=p;
            p=p->ptr[i];
        }
        if(found)return(p,i,1);
        else return(q,i,0); //查找失败,返回key的插入位置信息
    }
}
Status InsertBTree(BTree &T,KeyType key,BTree q,int i){
    x=key;
    ap=NULl;
    finished=false;
    while(q&&!finished){
        Insert(q,i,x,ap)    //将x和ap分别插入到q->key[i+1]和q->ptr[i+1]
        if(q->keynum<m) finished=true;  //插入完成
        else{               //分裂结点*q
            s=ceil((m+1)/2);    //取上界
            split(q,s,ap)   //分裂成s左,s,s右三个部分,将q->k[s+1..m],q->ptr[s..m]和q->recptr[s+1..m]移入新结点*ap
            x=q->k[s];
            q=q->parent;
            if(q) i=Search(q,x);    //在双亲结点中查找x的插入位置
        }
    }
    if(!finished)       //T是空树,或者根结点已分裂为结点*q和*ap
        newRoot(T,q,x,ap);      //生成含信息(T,x,ap)的新的根结点*T,原T和ap为子树指针
}
B +树是B树变形树,更适合于文件索引系统.
m级B +树和m级B树之间的区别是:
(1)具有n个子树的节点包含n个关键字;
(2)所有叶节点都包含所有关键字的信息以及指向包含这些关键字的记录的指针,并且叶节点本身根据关键字的大小从小到大依次链接;
(3)所有非终端节点都可以视为索引部分,并且该节点的子树(根节点)中仅包含最大(或最小)关键字.
B +树上通常有两个头指针,一个指向根节点,另一个指向带有最小关键字的叶节点.

B +树底部的叶节点是真实数据,其他祖先节点的数据可以用作数据范围的参考.
注意: 本文中的所有内容均来自“数据结构(C语言第二版)”(严为民先生)
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-188583-1.html

 如何在单词中设置数字的千位分隔符?两种轻松完成的方式
 如何编写图书管理系统 河北宏润钢木家具
 SpringBoot AOP(方面注释方法)的详细说明
 为什么有人写计算机病毒
现在打我们是鱼