机器学习和机器视觉训练实验平台
电脑杂谈 发布时间:2020-04-24 12:03:00 来源:网络整理
(1)独立的LAN操作和培训机器学习模型和测试.
支持同时登录和实验,最多48位用户
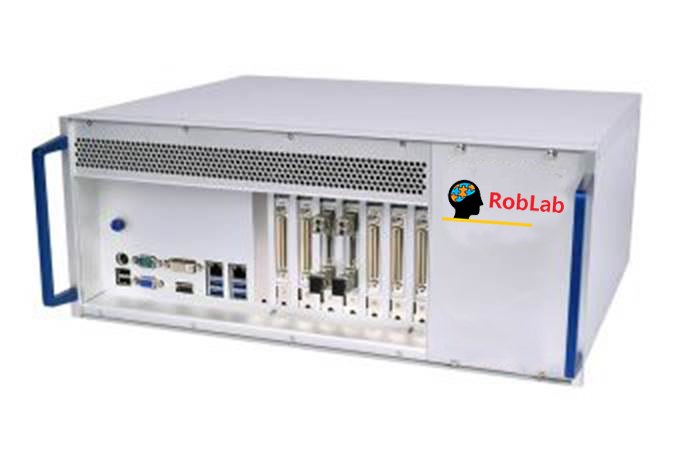
(1)提供GPU平台
GPU强大的并行计算功能缓解了深度学习算法的训练瓶颈,从而释放了人工智能的新潜力
GPU并行计算架构正好满足深度学习的需求. 经过几年的研发和积累,GPU已成为超级计算机的重要支撑,极大地提高了机器学习的计算能力. 过去,人工智能的并行算法可能需要一两年的时间才能看到结果. 在GPU强大的计算能力的支持下,深度学习算法得到了突破,可以在短时间内有效获取数据结果

(2)提供支持GPU的Cuda驱动程序软件.
CUDA™是NVIDIA推出的通用并行计算架构,它使GPU能够解决复杂的计算问题. 它包含CUDA指令集体系结构(ISA)和GPU内的并行计算引擎. 开发人员现在可以使用C编写CUDA™架构的程序. C是使用最广泛的高级编程语言. 编写的程序可以在支持CUDA™的处理器上以超高性能运行.
CPU和GPU一起使用的“协同处理”
每个重要的消费类视频应用都已由CUDA加速机器视觉实验平台,或即将由CUDA加速,包括Elemental Technologies机器视觉实验平台,MotionDSP和LoiLo的产品.


GPU架构
在科研界,CUDA一直很受欢迎. 例如,CUDA现在可以加速AMBER. AMBER是一种分子动力学模拟程序,全世界学术界和制药公司的60,000多名研究人员使用该程序来加速新药的开发.
在金融市场上,Numerix和CompatibL已发布CUDA支持,用于全新的交易对手风险应用程序,并将速度提高了18倍. Numerix已被近400家金融机构广泛使用.
(3)提供cuDNN的深度神经网络加速库cuDNN
NVIDIA cuDNN是用于深度神经网络的GPU加速库. 它强调性能,易用性和低内存开销. NVIDIA cuDNN可以集成到更高级别的机器学习框架中,例如Google的Tensorflow和加州大学伯克利分校的流行caffe软件. 简单的插件设计使开发人员可以专注于设计和实现神经网络模型,而不仅仅是调整性能,同时还可以在GPU上实现高性能的现代并行计算.

主要功能
·特别针对NVIDIA GPU进行了调整,用于向前和向后进行卷积神经网络的卷积程序.
·针对最新的NVIDIA GPU架构进行了优化
·对于4个纬度张量的任何维度排序,步幅和子区域都可以轻松集成到任何神经网络的执行中
·对于许多其他常见的布局类型(ReLU,Sigmoid,Tanh,缓冲池,softmax),前进和后退路径
·可以轻松实现多线程的基于上下文的API

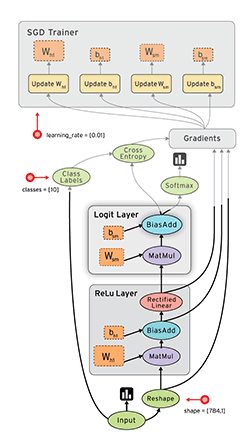
(3)TensorFlow神经网络算法
关于TensorFlow
TensorFlow是一个开源软件库,使用数据流图进行数值计算.
节点表示图中的数学运算,而图中的边缘表示在节点(即张量)之间互连的多维数据阵列. 其灵活的体系结构使您可以在多个平台上扩展计算,例如台式机,服务器,移动设备等中的一个或多个CPU(或GPU).
TensorFlow最初是由Google Brain团队(属于Google机器智能研究所的一部分)的研究人员和工程师开发的,用于机器学习和深度神经网络研究,但是该系统的性使其广泛可用. 计算字段.
核心概念: 数据流程图
数据流图使用“节点”和“边缘”的有向图来描述数学计算.
“节点”通常用于指示所应用的数学运算,但也可以指示数据输入(馈入)/输出(推出)终点的起点,或读/写持久变量(持久变量)结束.
“行”指示“节点”之间的输入/输出关系. 这些数据“行”可以承载“大小可以动态调整”的多维数据数组,即“张量”(张量).
张量流过图片的直观图像是该工具被命名为“ Tensorflow”的原因. 输入上的所有张量都准备好后,节点将被分配到各种计算设备,以并行和异步地完成操作.


(4)教育数据集:
经典MNIST数据集:
CIFAR10数据集:
UCI住房数据集:
斯坦福车辆识别数据集:
猫狗战役数据集:
MovieLens百万数据集:
百度实体注释数据集:
街景门牌号(SVHN):
数百万首歌曲数据集(子集):
中文语音数据集(Hill Shell版):
鲍鱼年龄预测:
面部关键点识别:
IMDB情绪分析数据集:
Biwi头部姿势数据集:
斯坦福狗数据集:
布菲人体姿势数据集:
91幅图像的超分辨率重建:
(5)提供实验测试用例:
手势识别机器学习案例.
MINIST手写识别案例
人脸识别示例
参数数据:
机器学习和机器视觉训练实验平台
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-187110-1.html
-

-
刘官悦
升級當天用了20來分鐘
 weixin_30480583
 计算机OCR字符识别技术的原理和未来发展趋势
 semaphore java.util.concurrent常用类(Cou
 C语言中的Static和内联函数
因为真货里本来就有质检合格证嘛~对不对