干货|机器学习感知机
电脑杂谈 发布时间:2020-04-24 00:04:30 来源:网络整理
什么是感知器

在机器学习中,感知器是二进制分类的线性分类模型,属于监督学习算法. 输入是实例的特征向量,输出是实例的类别(取+1和-1). 感知器对应于输入空间中的单独超平面,这些超平面将实例分为两类. 感知器旨在找到超平面. 为了获得超平面,引入了基于错误分类的损失函数,并且使用梯度下降法来优化损失函数(优化). 感知器的学习算法具有简单易实现的优点,分为原始形式和对偶形式. 感知器预测使用学习的感知器模型来预测新实例,因此它属于判别模型. 感知器由Rosenblatt于1957年提出,是神经网络和支持向量机的基础.
定义

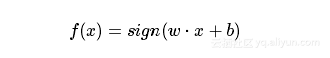
称为感知器. 其中,参数w称为权重向量weight,b称为偏差. w⋅x代表w和x的点积
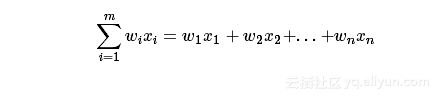
sign是一个符号函数,即
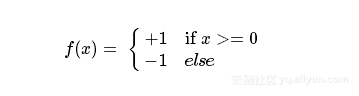
在二进制分类问题中,使用f(x)的值(+1或-1)对x是正样本(+1)还是负样本(-1)进行分类. Perceptron是线性分类模型,属于判别模型. 我们需要做的是找到满足w⋅x+ b = 0的w和b的最优值,即分离超平面. 如下所示,线性可分离感知器模型
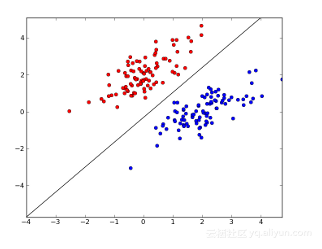
中间的直线是w⋅x+ b =0. 线性分类器的几何表示是: 直线,平面和超平面.

学习策略
核心: 最小化损失函数.
如果训练集是可分离的,则感知器的学习目标是找到可以完全分离训练集的正例点和负例点的分离超平面. 为了找到这样的平面(或超平面),即确定感知器模型参数w和b,我们使用损失函数并使损失函数最小化.
对于损失函数的选择,我们使用了从错误分类的点到超平面的距离(您可以自己计算,这里使用几何距离,即从点到直线的距离):
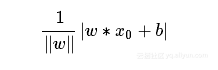
其中|| w ||是L2规范.
对于错误分类的点(xi,yi):
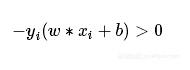
从错误分类的点到超平面的距离是:

然后,所有点到超平面的总距离为:
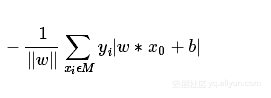
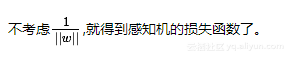

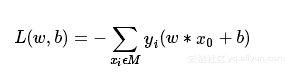
其中M是分类错误的集合. 这种损失函数是感知器学习的经验风险函数.
可以看出,函数L(w,b)在任何时候都是非负的. 如果没有错误分类的点,则损失函数的值为0,错误分类的点越少,错误分类的点越靠近超平面,损失函数的值越小. 同时,损失函数L(w,b)是一个连续可微的函数.
学习算法
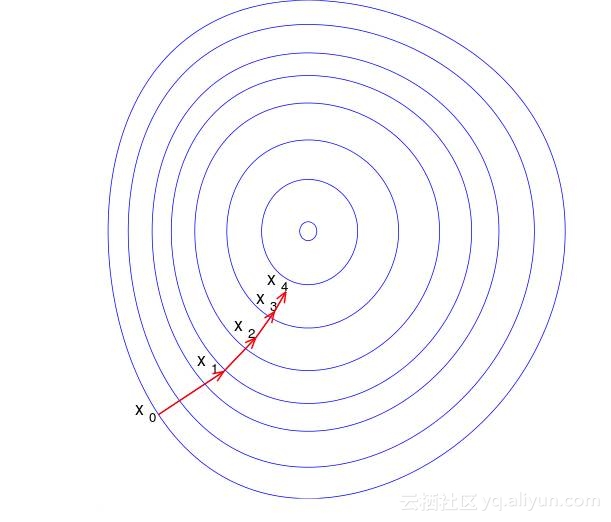
感知器学习被转化为求解损失函数L(w,b)的优化问题. 最优化的方法是随机梯度下降法,这是此处使用的方法. 有关梯度下降的详细信息,请参阅Wikipedia梯度下降. 这是梯度下降的简单可视化:
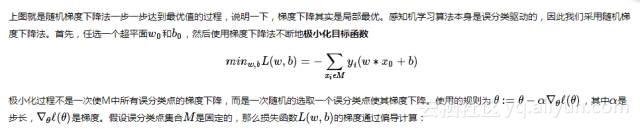

其中,η是步长,大于0且小于1,在统计学习中称为学习率. 这样,可以期望损失函数L(w,b)通过迭代不断减小直至为0.
以下是感知器学习的图形,比较了图像:
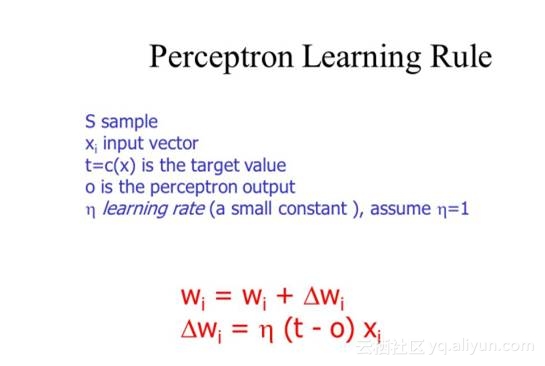
由于上图中的损失函数不同,权重变化公式有所不同,但思路是相同的.
算法描述如下:

算法: 感知器学习算法的原始形式
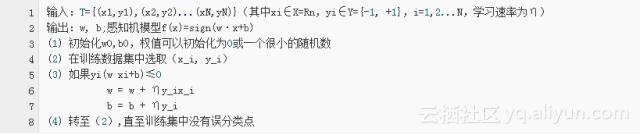
说明: 当实例点被错误分类时,调整w,b将分离超平面移到错误分类点的侧面,以减小错误分类点与超平面之间的距离感知机和支持向量机,直到超过正确分类为止. 伪代码说明:
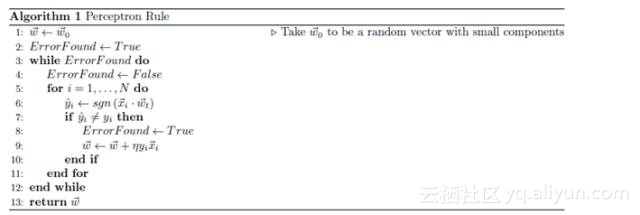
对于每个w⋅x实际上都是这样的(假设x代表七个维度):
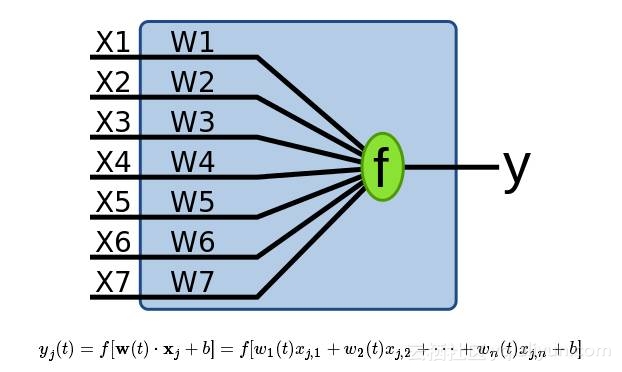
为输入的每个特征添加权重,然后将和相加以获得求和函数f,最后该函数的输出为输出y值.
示例
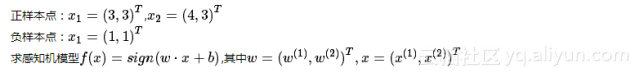
答案: 根据上面的解释,写入初始化权重w和偏移量b,然后逐步更新权重,直到所有点都正确为止.
解决方案: (1)令w0 = 0,b0 = 0
(2)随机取一个点感知机和支持向量机,例如x1,计算y1(w0⋅x1+ b0),结果为0,表明其分类不正确,请根据以下公式更新w,b(在此例如,我们将学习率η设置为1):
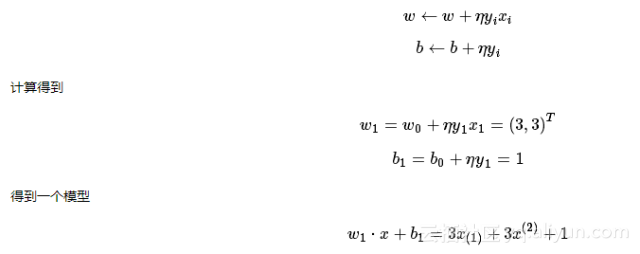

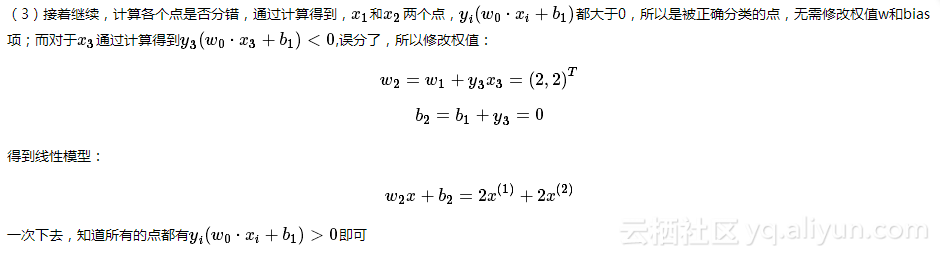
最终获得
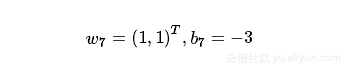
因此感知器模型为:
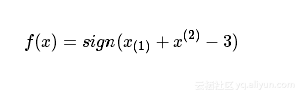
是我们正在寻找的感知器模型.
摘要
感知器是机器学习中非常重要的基础. 了解感知器对于后面的SVM和神经网络非常有帮助. 实际上,感知器学习是损失函数优化的问题. 在此,使用随机梯度下降法进行优化.
好吧,关于感知器的介绍,请停在这里!在审阅过程中,请注意记录,搜索信息并进行整理,这也是对您的解释. 希望本文能对大家有所帮助.
参考
[1]统计学习方法,李航
[2] Wikiwand的感知器
[3]维基百科
原始链接:
相关文章链接:
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-186508-1.html

 新手加载系统|| U盘win7 |百度文库
 MATLAB小笔记_图像格式转换
 最方便的UltraISO引导U盘并安装系统盘,以及如何设置BIOS从U盘引导
 病毒和细菌是生物吗 新版出炉了?网上流传视频:称刚从银行取了50元和100
让人匪夷所思