58在同一城市中基于Flink的1000亿级实时计算平台架构的实践
电脑杂谈 发布时间:2020-04-23 15:14:17 来源:网络整理
作者简介
冯海涛/万世康,负责在同一城市中构建58个实时计算平台.
58作为覆盖生活各个领域的服务平台,同一城市的业务涵盖招聘,房地产,汽车,金融,二手和本地服务的所有方面. 丰富的业务线和大量的用户每天都会生成大量的用户数据,这需要实时计算和分析. 实时计算平台的定位是为集团的海量数据提供高效,稳定和分布式的实时计算基础服务. 本文主要介绍Wstream,这是由58 City建立的基于Flink的一站式实时计算平台.
实时计算方案
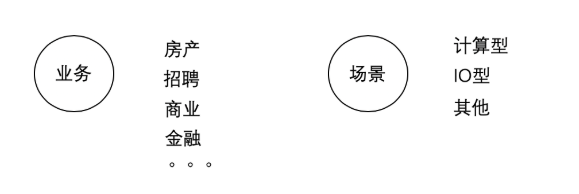
像许多互联网公司一样,实时计算在58岁时具有丰富的场景要求,主要包括以下类别:
平台进化

在构建实时计算平台的过程中,主要是跟进开源社区的发展和实际业务需求. 该计算框架经历了Storm to Spark Streaming到Flink的发展,同时建立了一个一站式实时计算平台,旨在改善用户实时计算需求,开发管理和监控效率,并优化平台管理.
实时计算引擎的早期阶段基于Storm和Spark Streaming. 在许多情况下,它不能很好地满足业务需求. 例如,商业部门基于Spark Streaming构建的特性平台希望将计算延迟从几分钟减少到几秒钟,并改善用户. 经验表明,运维监控平台是基于Storm分析公司的完整nginx日志来监控服务的,要求延迟几秒钟甚至几毫秒,Storm的吞吐能力已成为瓶颈.
同时,随着实时性要求的提高,场景更加丰富. 在追求高吞吐量和低任务延迟的基础上,对计算过程的中间状态管理,灵活的窗口支持以及精确的一次语义保证提出了越来越多的要求. Apache Flink开源之后,它支持高吞吐量和低延迟的体系结构设计以及高可用性稳定性. 同时,它在实时计算场景中具有一系列功能并支持实时Sql模型,这使我们决定将Flink用作新一代实时计算平台的计算引擎.
平台规模

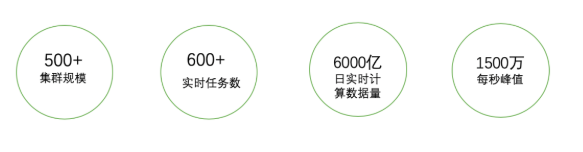
当前的实时计算平台主要基于Storm / Spark Streaming / Flink. 该集群共有500多台机器,每天处理6000亿+数据. 其中,Flink经过近一年的建设已达到50%.
闪烁稳定性
作为实时计算集群,Flink与离线计算集群相比具有更高的可用性要求. 为了确保群集的可用性,该平台主要使用任务隔离和高可用性群集体系结构来确保稳定性.
任务隔离
在应用程序级别,计算机隔离和队列资源分配管理主要基于业务线和方案,以避免集群抖动对全局的影响.
集群架构
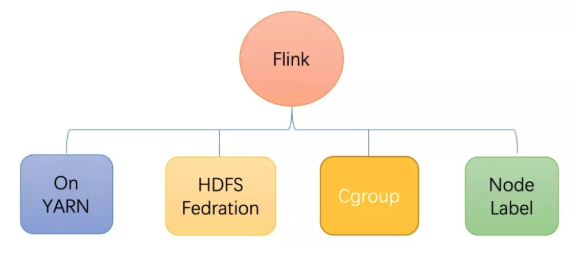
Flink群集采用ON YARN模式进行独立部署. 为了减少群集的维护工作量,底层HDFS使用该公司的统一HDFS联合身份验证体系结构来建立独立的名称空间,以减少Flink任务. 在检查点方案中,将hdfs / rocksdb用作状态存储后端方案,由于hdfs抖动而导致频繁的异常故障.
在资源隔离级别,引入了“节点标签”机制以认识到重要任务在独立的机器上运行运维体系 实时计算平台,而不同计算性质的任务在合适的机器上运行运维体系 实时计算平台,以最大程度地利用机器资源. 同时,在YARN资源隔离的基础上添加Cgroup进行物理CPU隔离,减少了任务间抢占的影响,确保了任务运行的稳定性.
平台管理
Wstream是基于Apache Flink构建的一站式高性能实时大数据处理平台. 提供基于SQL的流数据分析功能,大大降低了实时数据分析的门槛,通过DDL支持源/和维表,并支持UDF / UDAF / UDTF为用户提供更强大的实时数据处理能力. 支持多种样式的应用程序构建方法FlinkJar / Stream SQL / Flink-Storm,以满足不同用户的开发需求,同时通过调试,监视,诊断和探索结果等辅助手段来改善任务生命周期管理.
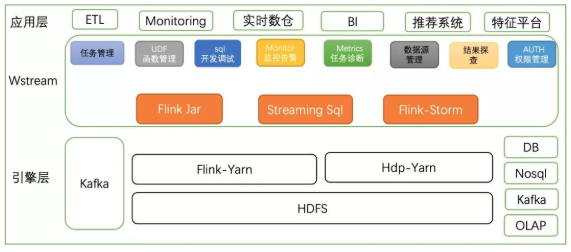
流式SQL能力建设
Stream SQL是构建基于SQL的实时计算功能并降低实时计算开发门槛的平台. 基于开源Flink,基础SQL模块被扩展以实现以下功能:
在支持大数据开源组件的同时,它还开放了公司的主流实时存储平台. 同时,它为用户提供基于Sql客户端的cli方法,并集成了对Wstream中实时sql功能的支持,为用户提供了用于开发和调试sql任务的编辑器,并支持代码突出显示,智能提示,语法验证和运行时校准. 为了避免用户提交给集群的任务异常.
此外,还为用户提供了基于向导的配置方法,以解决用户需要了解复杂的参数设置才能定义表的问题. 用户只需要关心业务逻辑处理,就可以使用SQL来开发实时任务,例如开发离线Hive.

风暴任务迁移Flink
在改善Flink平台的构建的同时,我们还启动了Storm任务迁移Flink程序,该程序旨在提高实时计算平台的整体效率并降低机器成本以及运营和维护成本. Flink-Storm作为正式的Flink兼容Storm程序,为我们提供了无缝迁移的可能性,但作为Beta版,在实际使用过程中有很多情况无法满足实际情况,因此我们进行了很多改进,主要包括对纱线执行Storm任务,迁移后至少执行一次语义保证任务,与Storm的壁虱元组机制兼容等.
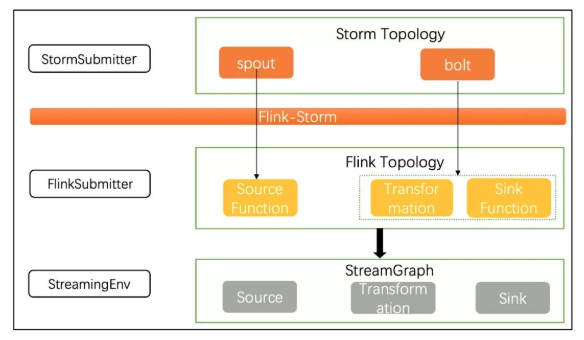

通过Fink-Storm的优化,我们成功完成了多个Storm版本的集群任务迁移和集群离线,而无需修改用户代码,这可以在确保实时性和吞吐量的基础上节省计算资源. 更多占比超过40%,对实时计算平台进行纱线统一管理,无需维护多个Storm集群,从而提高了平台资源的整体利用率,减少了平台运维工作量.
任务诊断指示器监视
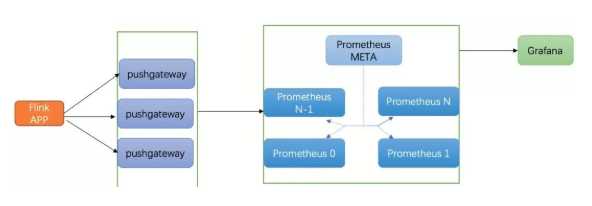
Flink webUI为用户提供了很多运行时信息,以供他们了解任务的当前运行状态,但是存在一个问题,即无法获取历史指标,从而使用户无法了解任务的历史运行状态,因此我们使用Flink本身支持的Prometheus来收集实时指标和存储.
Prometheus是一个开源的监视和警报系统. 通过pushgateway方法实时报告指标. Prometheus集群采用联合身份验证部署模式. 元节点会定期获取所有子节点指示器以进行汇总,这便于统一数据源为可视化和警报配置提供Grafana.
任务延迟
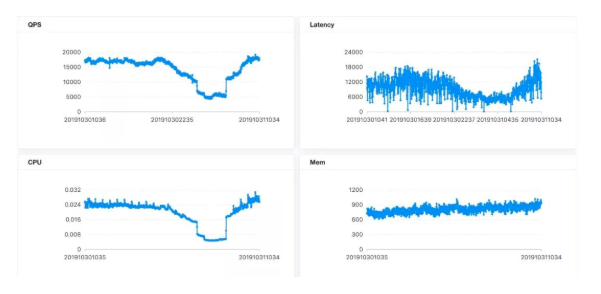
吞吐量和延迟是衡量实时任务性能的最重要指标. 我们经常需要使用这两个指标来调整任务并发性和资源分配. FlinkMetrics提供了latencyTrackingInterval参数来启用任务延迟跟踪. 打开将严重影响群集和任务的性能. 官方强烈建议仅在调试时使用.
在实际情况中,Flink任务数据源基本上是Kafka,因此我们使用主题消耗累积作为衡量任务延迟的指标,监控模块通过Flink rest实时获取任务消耗的主题的偏移量,并通过Kafka JMX获得相应的内容. 主题的logsize使用logsize-offset作为主题的累积.
日志检索
Flink作为分布式计算引擎,所有任务将由YARN统一调度到任何计算节点,因此任务运行日志将分布在不同的计算机上,并且用户很难找到日志. 通过调整log4j日志框架的默认机制,我们将任务日志按天划分,并定期清理过期的日志,以避免出现异常任务频繁填满磁盘并导致计算节点不可用的情况. 同时,我们在所有计算节点上部署代理,以实时收集日志,并通过日志分发平台实时聚合通过Kafka将数据分发到ES的ES数据,方便用户记录日志和查找问题.

链接优化
在实际使用过程中,我们还针对业务场景进行了一些优化和扩展,主要包括:
1)Storm任务要求Storm引擎提供ack机制,以确保至少一次语义传递消息. 迁移到Flink不能使用ack机制. 我们自定义KafakSpout以实现与检查点相关的接口,并自定义Flink检查点机制以实现消息传输而不会丢失. 另外,默认情况下,Flink-Storm仅支持独立提交方法. 通过实现与纱线客户端相关的接口,我们增加了对纱线支持的关注.
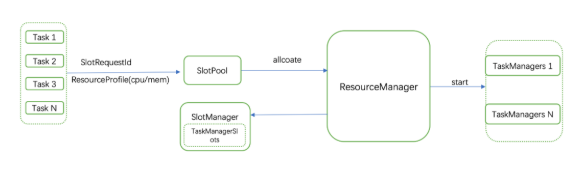
2)Flink 1.6建议使用与插槽相对应的TaskManager. 申请资源时,请根据最大并发次数申请相应数量的TaskManger. 这就导致了问题,任务集任务槽之后需要应用的资源大于实际资源.
当ResoureManager请求资源管理器SlotManager时,我们添加TaskManagerSlot相关信息,该信息用于维护TaskManager和要分配的插槽,然后对于SlotRequests请求,我们不直接申请TaskManager,而是首先申请足够的插槽从SlotManager. 新的TaskManger在完成之前不会启动,因此资源的应用等于资源的实际消耗,从而在资源充足时阻止任务启动.
3)修改了Kafak连接器,增加了自动换行支持. 另外,不能为08source设置client.id. 通过将client.id生成机制优化为更具识别性的id,可以方便地进行Kafka级别控制.
4)Flink提交任务无法支持第三方依赖的jar包和配置文件供TaskManager使用. 我们修改了flink启动脚本以添加相关参数以支持外部传输文件. 然后,在任务启动过程中,将相应的jar包和File添加到类路径中,并使用yarn的文件管理机制来实现spark的类似使用模式,方便用户使用.
5)在业务场景中存在大量的实时写入hdfs要求. 默认情况下,BucketingSink附带的Flink仅支持字符串和avro格式. 在此基础上,我们同时支持LZO和Parquet格式写入,从而大大提高了数据写入性能.
后续计划
实时计算平台目前正在将Storm任务迁移到Flink集群,该集群已基本完成,大大提高了平台的资源利用率和计算效率. 后续活动将继续研究和改进Flink的相关功能,并促进Flink在更多实时场景中的应用,包括实时规则引擎和实时机器学习.
作者丨冯海涛/万世康来源丨58技术(ID: iteblog_hadoop)dbaplus社区欢迎技术人员的投稿,投稿电子邮件为editor@dbaplus.cn >>>>
活动推荐
2020年4月17日,Gdevops全球敏捷运营峰会将于北京开幕!我们将专注于,智能运营和维护以及金融科技金融技术领域,与阿里,腾讯,蚂蚁金服,中国银行,平安银行,中国邮政消费金融,中国农业银行,中国民生银行,中国联通大数据,浙江移动,巨聚等新技术代表都期待着云时代的发展趋势,解决运维转型的困境.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-186083-1.html

 weixin_30480583
 计算机OCR字符识别技术的原理和未来发展趋势
 semaphore java.util.concurrent常用类(Cou
 C语言中的Static和内联函数
南方黑芝麻糊虽然垄断性地位