网络爬虫的基本原理
电脑杂谈 发布时间:2020-04-16 20:24:01 来源:网络整理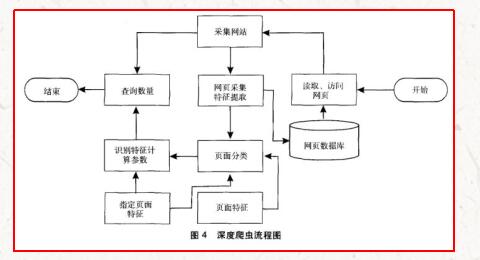
网络搜寻器是搜索引擎搜寻系统的重要组成部分. 搜寻器的主要目的是在Internet上下载网页,以形成一个或网络内容的镜像备份. 该博客主要简要介绍了搜寻器和搜寻系统. 1. Web爬网程序的基本结构和工作流程图中显示了Web爬网程序的一般框架: Web爬网程序的基本工作流程如下: 1.首先选择一部分精心选择的URL; 2.将这些URL捕获到URL队列中; 3.从要获取的URL队列中获取要获取的URL,解析DNS,获取主机的IP,下载该URL对应的网页,并将其存储在下载的网页库中. 另外,将这些URL放入爬网URL队列中. 4.分析爬网的URL队列中的URL,分析其中的其他URL,然后将该URL放入要爬网的URL队列,以进入下一个周期. 其次,从爬虫的角度来看,Internet可以分为五个部分: 1.下载未过期的网页2.下载已过期的网页: 爬行的网页实际上是Internet内容作为Internet的镜像和备份网络爬虫 工作原理,Internet会动态变化,并且Internet上的部分内容已更改. 目前,此部分捕获的网页已过期. 3.要下载的网页: 即要抓取的URL队列中的那些页面4.知道该网页: 尚未抓取,也没有要抓取的URL队列中的那些页面,但是您可以传递已抓取的页面或将要被抓取的页面通过分析URL的相应页面获得的URL被视为已知网页.
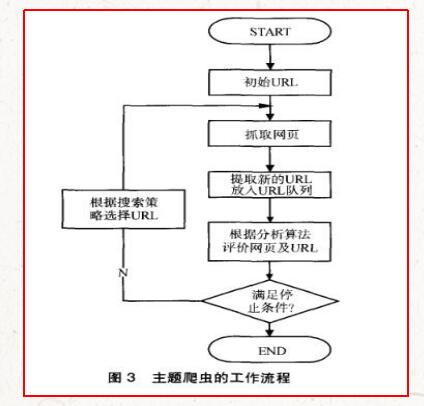
5. 仍然存在某些网页,爬网程序无法直接爬网和下载. 被称为不可知的网页. 3.爬网策略在爬网器系统中,要爬网的URL队列是非常重要的部分. URL队列中URL的爬行顺序也是一个非常重要的问题,因为它涉及先爬行该页面,然后再爬行哪个页面. 确定这些URL的顺序的方法称为爬网策略. 以下重点介绍几种常见的爬网策略: 1.深度优先遍历策略深度优先遍历策略是指Web爬网程序将在处理此行之后从起始页开始,并跟随一个链接,然后转到在下一个“开始”页面上,继续点击链接. 让我们以下图为例: 遍历的路径: AFG EHI BCD 2.宽度优先遍历策略宽度优先遍历策略的基本思想是将新下载的网页中找到的链接直接插入到要抓取的网址队列的末尾. 换句话说,Web爬网程序将首先对在起始页面中链接的所有页面进行爬网,然后选择链接的页面之一以继续对在此页面中链接的所有页面进行爬网. 以上面的图片为例: 遍历路径: A-B-C-D-E-F G H I 3.反向链接计数策略反向链接数是指其他网页链接指向的网页数. 反向链接的数量表示其他人推荐网页内容的程度. 因此,很多时候搜索引擎的爬网系统都会使用此指标来评估网页的重要性,从而确定不同网页的爬网顺序.
在真实的网络环境中,由于存在广告链接和欺诈链接,因此反向链接的数量不能完全等于他和我的重要性. 因此,搜索引擎通常会考虑一些可靠的反向链接. 4. Partial PageRank策略Partial PageRank算法借鉴了PageRank算法的思想: 对于下载的网页,以及要抓取的URL队列中的URL,形成了一个网页集合,以及PageRank值每页的计算. URL队列中的URL根据PageRank值进行排列,并且按此顺序对页面进行爬网. 如果每次爬网页面,都会重新计算PageRank值. 一个折衷方案是,每抓取K个页面一次,就会重新计算pageRank值. 但是,在这种情况下会出.

下载特定页面P后,将P的分配给从P分析的所有链接,然后清空P的. URL队列中要爬网的所有页面均根据量进行排序. 6.大站点优先级策略对于要爬网的URL队列中的所有页面,将根据它们所属的网站对它们进行分类. 对于要下载大量页面的网站,优先考虑下载. 因此,此策略称为“大站点优先级策略”. 参考文献: 1.《这是搜索引擎的核心技术详解》,张俊林电子工业出版社. 2.《基本搜索引擎技术》,刘益群等清华大学出版社.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-177989-1.html

 可以将驾照用作
 僵尸网络|HackerNews
 jsp文件 Java实现文件上传与下载
 java多线程死锁_线程 死锁_c++ 线程死锁
官网买啊