正则表达式,让我理解
电脑杂谈 发布时间:2020-04-14 19:02:29 来源:网络整理
世界上有两种类型的人,一种懂正则表达式,另一种不懂正则表达式.
无论您使用哪种语言学习Java,iOS,Android,都需要使用正则表达式,并且由于正则表达式是通用的(每种语言几乎相同),因此您可以学习任何语言的正则语言,使用在其他语言中,我将以python为例.
文章末尾有一些常见的正则表达式
1. 流行的理解: 根据某些规则,从某个字符串中匹配所需的数据. 此规则是一个正则表达式.
2. 标准答案: 正则表达式/ 1700215? fr =阿拉丁
匹配一个字符串:
text = 'hello'
ret = re.match('he',text)
print(ret.group())
# he
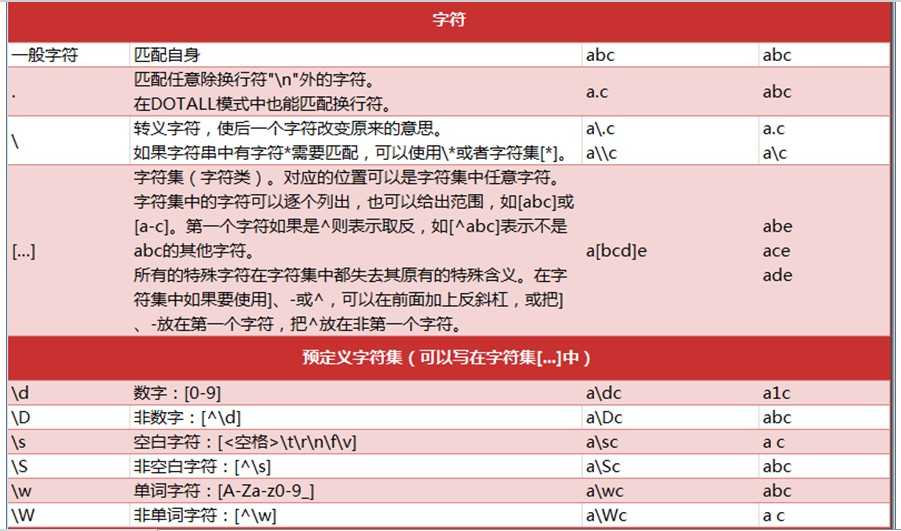
点(. )可以匹配任何字符
text = '+hello'
ret = re.match('.',text) # 只匹配一个任意字符,但不可以匹配换行(\n)符号
print(ret.group())
> +
\ d匹配任何数字:
text = "8"
ret = re.match('\d', text)
print(ret.group())
# 8
\ D匹配任何非数字:
text = "-"
ret = re.match('\D', text)
print(ret.group())
# -

\ s匹配空格字符(包括: \ n,\ t,\ r和空格):
text = "\t"
ret = re.match('\s',text)
print(ret.group())
text = "b"
ret = re.match('\w',text)
print(ret.group())
# b
\ W匹配\ w的反义词:
text = "+"
ret = re.match('\W',text)
print(ret.group())
# +
[]组合方法正则表达式,text,只要满足方括号中的一项,则认为匹配成功:
text = 'b'
ret = re.match('[a1b]',text)
print(ret.group())
# b
前面提到的几个匹配规则可以用方括号代替:
*: 可以匹配0个或更多字符
text = "3a1bcd"
ret = re.match("\d*", text)
print(ret.group())
# 3
+: 可以匹配1个或多个字符
text = "13ab6cd"
ret = re.match("\d+", text)
print(ret.group())
# 13
?: 匹配一或零,不匹配或仅匹配

text = "234"
ret = re.match("\w?", text)
print(ret.group())
# 2
{m}: 匹配m个字符
text = "234ab"
ret = re.match("\d{2}", text)
print(ret.group())
# 23
{m,n}: 匹配m-n个字符. 中间的字符可以匹配
text = "2d34absds124"
ret = re.match("\w{1,4}", text)
print(ret.group())
# 2d34
搜索功能
text = "adX"
ret = re.search("d",text)
print(ret.group())
# d
^(关闭字体): 开头,在macth函数中可以省略,效果相同,在搜索功能中不能省略
text = "adX"
ret = re.match("^a",text)
print(ret.group())
$: 表示以:
结尾
text = "xxx@163.com"
ret = re.match("\w+@163.com$",text)
print(ret.group())
搜索: 查找符合字符串条件的字符. 如果找到,请返回. 坦率地说,它只会找到第一个符合条件的人.

text = 'apple price $99 orange price $88'
ret = re.search('\d+',text)
print(ret.group())
# 99
text = "adX"
ret = re.search("d",text)
print(ret.group())
# d
$表示以
结尾
text = "xxx@163.com"
ret = re.match("\w+@163.com$",text)
print(ret.group())
# xxx@163.com
|: 匹配多个表达式或字符串:
text = "hello|world|love"
ret = re.search('love',text)
print(ret.group())
# love
贪婪模式
text = "0123456"
ret = re.match('\d+',text)
print(ret.group())
# 0123456
可以更改为非贪婪模式,则只能匹配0
text = "0123456"
ret = re.match('\d+?',text)
print(ret.group())
# 0
匹配0-100之间的数字:
text = '99'
ret = re.match('[1-9]?\d$|100$',text)  # 记得有个 $ 结尾
print(ret.group())
# 99
转义字符和本机字符串:
1. 如果不使用本机字符串,则需要4 \,因为Python中的“ \ n” = \ n正则表达式,text,正则表达式中的“ \ n” = \ n,因此“ \\ m” => \ n
 text = "apple \c"
 ret = re.search('\\\\c',text)
 print(ret.group())
# \c
2. 本地字符串r = raw = native
text = "apple \c"
ret = re.search(r'\\c',text)  # 相当于这层pyhton不会将字符进行转义,只有正则表达式的转义,所以 =》 \c
print(ret.group())
# \c
1. 验证手机号码: 手机号码规则以1开头,第二位数字可以是34587,接下来的9位数字可以是随机
text = "18820898963"
ret = re.match("1[34578]\d{9}", text)
print(ret.group())
2. 验证邮箱: 邮箱的规则是邮箱名称由数字,数字,下划线,然后是@符号,后跟域名组成
text = "dwyane@163.com"
ret = re.match("\w+@[a-z0-9]+\.[a-z]+",text)
print(ret.group())
3. 验证URL: URL的规则为http或https或ftp,然后在其后会出现一个冒号,斜杠和任何非空白字符.
text = "https://www.jianshu.com/u/bb2db3428fff"
ret = re.match("(http|https|ftp)://[^\s]+",text)   # [^\s] 非空白符
print(ret.group())
4. 验证: 的规则是一共有18位数字,前17位是数字,后一位可以是数字,小写x或大写X
text = "44010319900307883X"
ret = re.match("\d{17}[\dxX]",text)
print(ret.group())
5. 验证用户名(用户名长度在6到20位之间,大写和小写字母或数字)
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-175648-1.html
-

-
张帅帅
我的北京美丽
-
王战
质检总局还说他们对真假不负责任
 2015年氪估值排行榜top500_2015游戏钱排行榜_中国公司估值排行榜
 FPS低的原因是什么
 在N个元素中查找第k大的元素,有什么方法最快?
 这篇文章完美解决Win7声卡驱动安装失败的问题!
楼上丢脸