AI芯片: Google TPU1结构分析
电脑杂谈 发布时间:2020-04-14 02:28:59 来源:网络整理
最近,我一直在研究人工智能芯片的体系结构,并反复分析了Google发布的TPU专利. 我已经获得了一些见识并记录了下来,以供以后查看,这对大多数朋友也很方便. 感谢Google的分享.
事实上,2006年人工智能的出现走上了再次崛起的道路. 如果说举办IMGNET是为了快速促进深度学习的发展,那么让深度学习在图像识别领域非常受欢迎. 好吧,alphaGO的出现正式将深度学习带入了数百万普通人的家中.
深度学习模型使用人工神经元来形成多层神经网络结构. 经过大量数据训练和迭代后,形成具有一定识别功能的模型.
由于需要大量的训练数据和大量的迭代,因此需要大量的计算能力. 可以将这种计算能力大致视为每单位时间可以执行多少个浮点乘法加法运算.
当前的处理器,例如CPU和GPU,已经能够满足大多数常规应用. 但是,深度学习的出现使原本看似功能强大的CPU得以扩展,仅剩下GPU. 但是,GPU目前几乎完全由NVIDIA独占,价格昂贵,GPU并不是专门为深度学习设计的ASIC(专用集成电路),其能效仍有很大的提升空间.
因此,设计用于深度学习的ASIC成为必然.
Google拥有世界上最大的搜索引擎,并积累了大量数据. 据估计,它是世界上最早处理大量业务的公司之一. 而且Google拥有世界领先的深度学习团队DEEPMIND(alphaGO的发明者),自然可以更早地预测当前的计算能力.
因此,开创性的Google开始开发自己的深度学习ASIC芯片: TPU(张量处理单元或张量处理单元).
由于它是ASIC,因此有必要首先了解目标问题的需求.
几乎所有当前的深度学习模型都基于多层神经网络,包括输入层,隐藏层和输出层. 隐藏层可以分为卷积层,池化层,完全连接层和其他不同结构,或多种不同结构的组合.
最广泛使用的深度学习是图像识别,而实现图像识别最重要的是卷积层. 卷积计算是一系列数据的相乘和累加. 诸如合并层和完全连接层之类的其他层可以实现为乘加运算. 因此,如果可以有效地执行大量的乘法累加计算,则可以大大加快深度学习的速度.
Google的TPU是为了有效地计算大量的乘法累加运算.
根据学习参考TPU信息的态度,然后在相关文档/博客中,我了解了Google TPU发布的多项专利.
例如:
(1)神经网络处理器
(2)使用神经网络处理器计算卷积
(3)神经网络处理器中的分批处理
(4)预加权神经网络处理器中使用的重量
(5)神经网络处理器中的矢量计算单元
第一个专利(NEURAL NETWORK PROCESSOR)是核心,其余四个专利是用于介绍特定细节的专利技术.
以下对TPU的结构设计的分析是指上述五项专利. 有兴趣的朋友可以在Google学术搜索或百度学术搜索中下载并查看. 如果还有其他专利,请让朋友知道以共同学习和进步.
1. TPU的总体结构
首先,根据Google发表的TPU文章(张量处理单元的数据中心内性能分析),全面了解TPU的结构和功能.
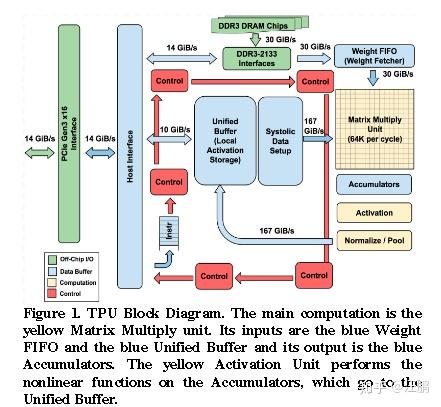

上图是文章(张量处理单元的数据中心内性能分析)中提供的TPU的框图.
整个TPU的核心是由乘法器和加法器的组合形成的256×256运算符阵列: 乘法矩阵(该模块在图中右侧用正方形表示).
你为什么这么说?
因为TPU中的其他模块围绕乘法矩阵工作,或者向乘法矩阵提供输入数据(例如,要处理的像素数据和滤波器权重),或者接收乘法矩阵的输出.
目前,未显示乘法矩阵的具体功能. 首先让我们了解TPU内的其他模块.
在乘法矩阵的上,下和左三个方向上的浅蓝色模块具有不同的功能: 乘法矩阵上方是用作过滤器权重输入的fifo,乘法矩阵左侧是输入像素数据的缓冲区和乘法数组下面是累加器,用于接收输出的乘法加法结果. 存储过滤器权重的fifo从DDR3_DRAM接口(图片上方的绿色模块,绿色模块代表片外芯片)接收权重数据. 累加器累加多个通道的像素的相乘和相乘结果,以获得当前正在执行计算的神经网络层的输出像素点. 激活函数处理后,然后根据模型的需要,选择是否执行合并/标准化等操作,然后将处理后的数据存储在乘法矩阵左侧的输入像素缓冲区中.
此外,神经网络第一层的输入像素数据是来自外部世界的原始图像,因此TPU使用PCIE总线(图左侧的绿色矩形)将数据传输到缓冲区.
当然,TPU中的这么多模块可以正常工作,自然需要一套完整的控制系统,如图中红色模块所示.
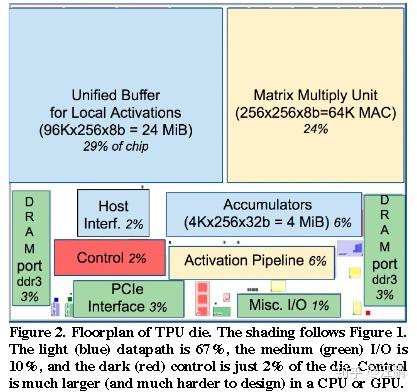
上图是文章(张量处理单元的数据中心性能分析)中提供的TPU芯片的模块图,该图反映了每个模块所占用的芯片面积. 可以看出,TPU具有大量的片上存储器,用于存储乘法矩阵的输入像素数据,占据面积的29%. 另外,乘法矩阵也占很大的面积,达到24%.
TPU的整体结构也包含在专利中.
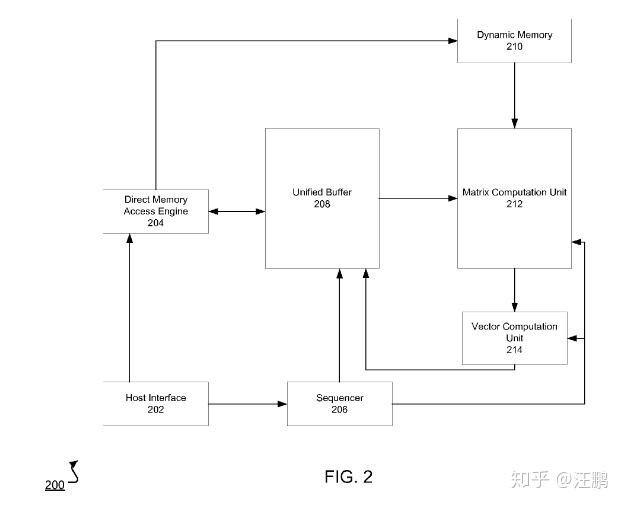
上面的图片是专利(NEURAL NETWORK PROCESSOR)中TPU的整体结构. 实际上,它与上一篇文章的非常相似,因此不会花费太多.
2. TPU的核心结构: 乘法矩阵
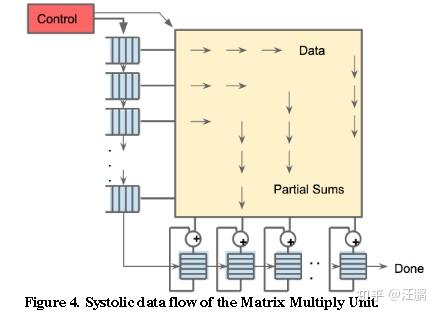
上图是文章(张量处理单元的数据中心内性能分析)中提供的乘法矩阵的概念图.
尽管很粗糙,您仍然可以监视一两个. 可以看出,输入像素数据从乘法矩阵的左侧进入并从左向右传播. 输入像素数据被重用,并且由乘法加法单元形成的部分和沿着从顶部到底部的方向被传输. 部分和被输出到矩阵下方,然后通过累加器累加以形成最终结果.
Google使用的乘法矩阵结构实质上是一个脉动数组(blog.csdn.net/anntang18/article/details/77718531?locationNum=7&fps=1).
脉动矩阵的概念已经提出了很多年. 由于需要将其应用于更规则的场景,因此没有特别突出的实际应用. 现在,深度学习的激烈性引入了大量规则的乘加运算,尤其适合于将脉动矩阵用于神经网络算法中的有效乘积运算,计算卷积或全连接运算.
文章中乘法矩阵的是粗糙的,但在专利中更为具体.
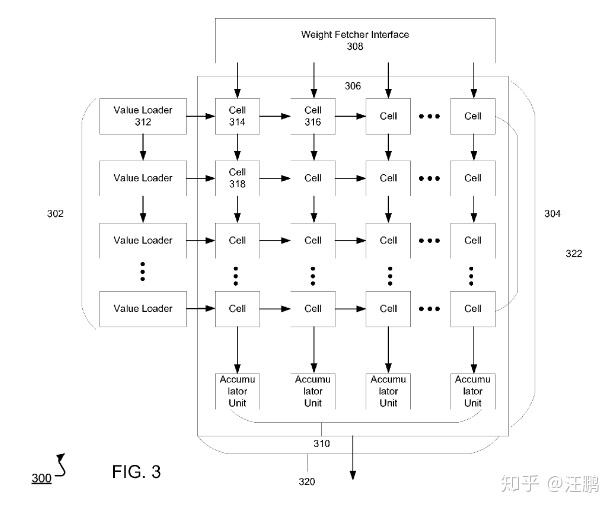

上图是专利(神经网络处理器)中提供的乘法矩阵的.
可以清楚地看到,乘法矩阵使用了脉动矩阵. 图中的每个单元都是一个乘加单元. 乘法矩阵左侧的每一行的像素输入将在行的方向上从左向右传播. 由加法单元形成的部分将沿着列方向从顶部传播到底部. 每列乘法器的最终输出提供给累加器.

上图是专利(神经网络处理器中的电池处理)中的单元: 每个单元都包含一个乘法器和一个加法器,以及一些寄存器.
每个单元执行功能A×B +C. 其中,A代表从左输入的像素数据,B代表从上一个单元获得的滤波器权重,C代表从上一个单元获得的输出部分和.
可以清楚地看到,来自左侧的像素输入数据将传递到右侧的相邻单元. 过滤器的重量将传递到下面的单元格中. 从上层单元获得的部分和用作当前单元的加数C. 当前单元输出的部分和将作为加数C传递到下面的相邻单元.
3. TPU乘法矩阵的工作原理
让我们看看这个脉动矩阵是如何工作的.
深度学习用于图像识别. 原始输入数据是图像. 如果是黑白图像,则数据只有一个通道. 如果是彩色RGB图像,则图像由三个通道组成,每个通道代表红色. ,绿色(绿色),蓝色(蓝色). 实际上,黑白图像是彩色RGB图像的特例. 当三个彩色RGB通道的数据完全相同时,它将变成黑白图像.

上图显示了RGB的三个通道的数据. 假设层602的所有“ 1”代表红色通道的图像数据. 类似地,层604的所有“ 2”代表绿色通道的图像数据. 所有“ 3”代表蓝色通道的图像数据.
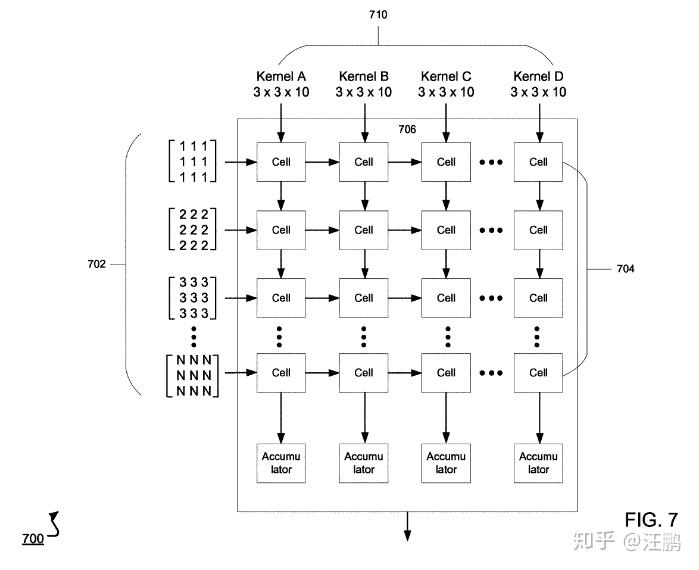
如上所述谷歌搜索引擎权值原理,如何将多个通道的图像数据和多个滤波器的权重准确地馈送到脉动矩阵.
在左侧查看702,即同一通道的图像数据,将二维图像数据转换为一位矢量(垂直),然后每个元素从脉冲的左侧进入同一单元矩阵依次. 并传递到右侧的相邻单元格. 脉动矩阵所有行的左侧是同一图像的不同通道的数据. 输入尽可能多的行. 如果通道数少于矩阵中的行数,则矩阵其余行的输入数据将填充为零.
在顶部710看到相同过滤器的权重,将二维权重转换为一维向量(向量),然后每个元素又从脉动矩阵的顶部进入同一单元. 输入与过滤器一样多的列. 如果过滤器的数量小于矩阵中的列数,则空矩阵列无所谓. 在接收下面的累加器的输出时,您不需要接收空闲的冗余列的输出.
输入数据有多少个通道,相应的过滤器有多少个通道.
因此,滤波器的每个通道的权重将乘以输入图像的相应通道元素,然后所有通道的结果将相乘,最后底部的累加器将累加以获得卷积结果.
**注: 只能乘以通道,不能乘以不对应的通道. **
以下是示例:
例如,图像具有三个通道: R,G和B;假设只有一个过滤器A,则过滤器A也具有三个通道: X,Y和Z.
然后,卷积的结果是:
总和= R×X + G×Y + B×Z(正确)
代替:
总和= R×X + R×Y + R×Z + G×X + G×Y + G×Z + B×X + B×Y + B×Z(错误)
注意: 这里B×Z代表相应通道的相应元素被相乘然后累加.
4. TPU乘法矩阵中的棘手问题
阅读上一节中乘法矩阵的结构分析后,熟悉脉动矩阵的原理,并结合专利中明确规定的输入数据和输出数据,您是否觉得内部计算方法TPU乘法矩阵的定义已经很清楚了,不禁产生了这样的TPU但如此鄙视? ?
如果您是这样认为的话,是丹尼尔(Daniel)看到TPU乘法矩阵中令人讨厌的外观,或者是凡人,并被Google的专利完全欺骗.
不幸的是,我也是凡人. las ...
接下来,使用仿真来实际计算卷积过程,然后探索Google TPU的乘法矩阵.
在上一节中,已经分析了乘法矩阵的每一行输入像素,每一列输入滤波器权重.
像素值将从当前单元格传递到相邻的右单元格.
过滤器的重量从当前单元格传递到下面的单元格.
通过将当前单元格相乘得到的部分和传递到下面的单元格中.
但是,请记住脉动矩阵的知识.
在脉动矩阵中执行A×B + C的乘法加法运算单元只能在ABC中传递两个数字,而另一个数字必须是固定的. 假设A代表输入像素,B代表滤波器权重,C代表上方相邻单元传递的部分和. 可以肯定的是,输入像素A必须沿着行方向从左到右通过,而部分C则必须沿着列方向从上到下通过.
但是,从专利的角度来看,过滤器重量B似乎也可以沿列方向从上到下传输.
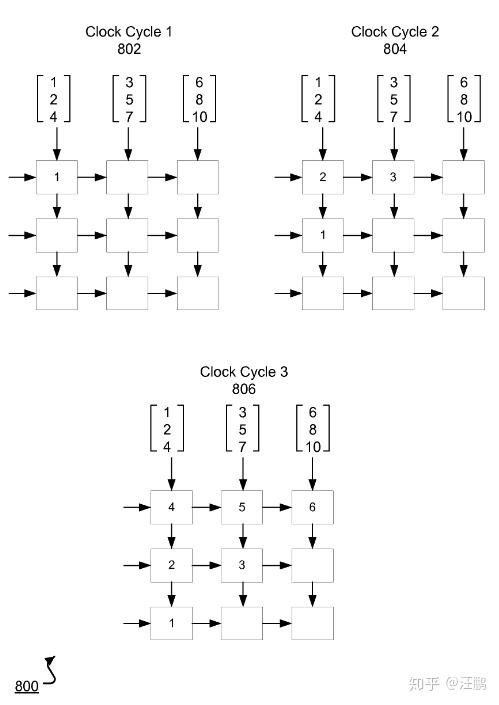
上图是专利中介绍的过滤器重量转移过程.
确定输入图像数据向左传送谷歌搜索引擎权值原理,并且确定由单元产生的中间结果向下传送. 然后,为了正确计算卷积,必须固定权重. 因为,脉动矩阵的原理是输入图像数据,权重和中间结果只能固定为三个中的一个,而其他两个则沿矩阵的两个方向(行和列)传输.
那么,如何解释上图中的重量传递?
此外,同一通道的图像数据只能进入同一行中的单元格,因此相应单元格中的权重也需要更改. 因此,不可能解释简单地使用传统脉动矩阵的固定滤波器权重的方法.
坑.
Google如何做到?
最直接的想法之一是,每个循环从一列的最上方单元格获得一个以上的权重值,但获得对应周期内该列所有行中的单元格所需的相应权重值一个时间. 每行一次使用一个权重值,其余行继续向下传递,将最后一个权重值引导到最后一行中的单元格.
可能有点圆,这是一个例子.

Google TPU的脉动矩阵中的单元格大小为256×256,这意味着每行有256个单元格,总共256行.
以第一列为例,解释上述有关权重值传递的猜测.
假设只有一列单元格.
第一个单元在第0周期获得256个权重值(来自滤波器的256个通道). 每个权重值是对应于0到255个通道的过滤器的第一个位置的值,假定位置为0.
通道0的第一列使用通道[0]的权重值. 剩余的255个权重值将在下一个周期传递到列第二行的单元格中,然后通道[1的权重值]由周期1的第二列中的单元使用,其余254个权重值将在下一个周期中使用...依此类推.
这个想法很简单,但是缺点也很明显,这将占用大量带宽并浪费大量资源. 显然不够聪明.
聪明的Google不会选择这种简单粗暴的方法.
那么,您认为哪里错了?
再次验证您的想法.
首先,从脉动矩阵的左侧输入像素数据,并沿脉动矩阵的行方向从左向右传输像素数据,并且将每个周期传输至相邻的右单元. 这是肯定的. 如果不是这种情况,那么就没有办法谈论如何重用输入数据并减少带宽.
第二,由乘法器加法器累加的结果清楚地从脉动矩阵下侧的单元输出. 也就是说,通过乘法加法单元的操作获得的结果(部分和)必须沿着脉动矩阵的列的方向从上到下传输. 如果不是这种情况,则无法从中间单元获得乘法和加法结果.
对于一个单元格,乘数加法器中用于乘法的权重值将随着输入的变化采用相应的权重值. 换句话说,权重值也会改变.
随着采样窗口的移动,输入确实会不断变化,但是相应的过滤器权重值仅需要一组即可连续重复.
您找到了什么吗?
哈哈!
5. 左输入模块在TPU乘法矩阵之外
乘法矩阵左侧的输入模块,主要功能是为乘法矩阵提供相应的输入数据. 需要收集和放置不同的渠道数据.
并且您需要完成数据的预处理,例如计算到神经网络的中间层,上一层的输出将用作下一层的输入,但是需要用零. 这样的操作也必须在左侧. 输入模块中的控件.
通常在此处添加Fifo作为输入数据接口,以便于控制.
6. 在TPU乘法矩阵之外降低激活/合并模块
在深度学习算法的乘法和累加计算完成之后,在乘法矩阵的下侧,链接有累加/激活/合并等功能模块.
累加,假设滤波器的大小为rxr,当输入通道较大时,例如超过256达到512,则TPU的乘法矩阵不能一次计算,则总共需要N计算(N等于: 512除以256,然后四舍五入)次,此时,乘法矩阵以下的输出需要连续累加N xrxr个输出结果. 幸运的是,在此位置,每列每个周期仅输出一个结果,因此只需直接添加累加器即可,从而节省了硬件资源.
激活,当前常用的relu激活. 有经典的sigmod,tanh等. Relu被激活,只需要检测数据的符号位,如果为正,则保留原始值,如果为负,则直接取零. 实际上,这实际上是两者之间的选择. sigmod / tanh,这是常规的算术运算,需要使用计算资源进行实际计算.
池化,常见的最大池化. 有平均池等. 其中,最大的合并最好是通过连续比较两个数字,保持较大的数字,然后再继续比较下一个数字来实现的. 最后剩下的是所需的最大值. 平均值池比较麻烦,它会累加所有需要计算的数字,然后除以r x r.
这些功能的实现技术相对成熟和普遍.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-174846-1.html
-

-
汪柱
详见我昨天文章
-
慕容宝
 360浏览器批量下载并保存图片
 网络嗅探器(视频侦探)正式版
 W764位旗舰版和纯版本系统下载
 图书销售系统参考
卧槽amber变帅好多