Mr_Lowbee
电脑杂谈 发布时间:2020-04-12 18:02:44 来源:网络整理
5)将预测值与测试样品的真实标签进行比较. 如果它们匹配,则预测成功.
6)i = i + 1,重复步骤1)直到i = 208,得出k最近邻算法的分类精度.
分别从1到50取K,以获得具有不同k值的最近邻方法的精度knn算法测试数据集,并绘制k与精度之间的关系
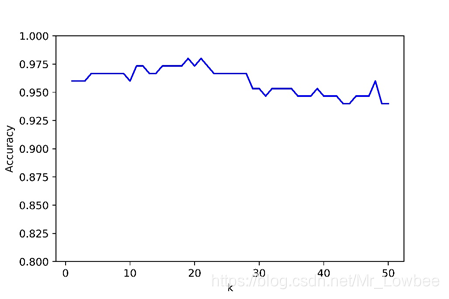
如您所见,当k为20时,准确率最高,但总体准确率仍可以达到95%以上,并且分类效果更好.
当k设置为1时,k最近邻居变成1最近邻居,即,最近邻居的分类精度约为0.96,并且代码部分位于末尾.

分别从1到100取K,以获得具有不同k值的最近邻方法的精度,并绘制k的图像和精度
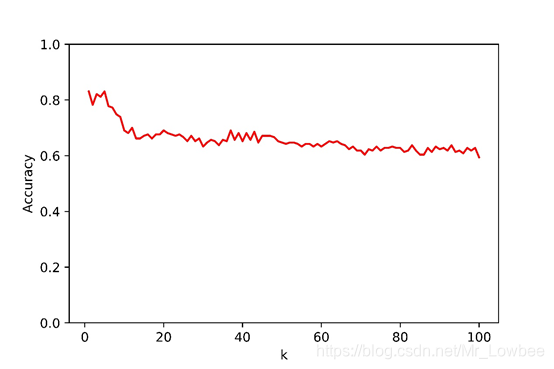
从图中可以看出,当k取0到10时,最近邻居识别方法的准确率最高,可以达到80%以上. 随着k的增加,准确率稳定在70%左右
K设置为1,最近邻居的识别精度约为0.83,并且代码部分放在末尾.
USPS手写数据集具有从0到9的10个类别. 在数据处理过程中,原始图像的16 * 16像素已转换为256个灰度值,也就是说,USPS中的每个样本共有256个灰度值. 维度特征数据集分为7291个训练样本和2007年测试样本,训练标签和测试标签.
分别从1到20取K,以获取k在不同值处的最近邻法的精度,并绘制k和精度的图

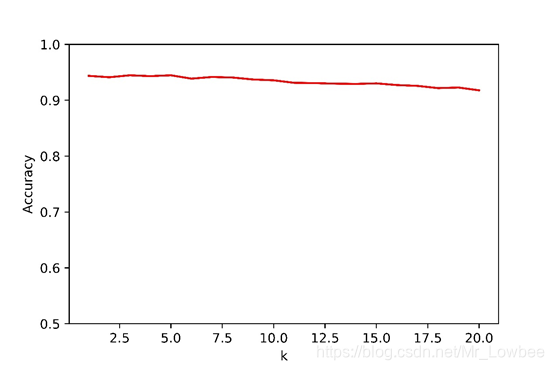
可以看出,当k取0到20时,k最近邻分类的准确性基本上保持在93%左右
K为1,最近邻的识别精度约为94%
比较Sonar数据集的Fisher和k最近邻分类算法的准确性
在先前的博客中,我们采用了声纳数据集的1至60维特征进行线性判别,并在获得最佳投影方向W *(d维列向量)后使用了分类阈值W0和决策). 规则g(x)可以获得分类精度.
Fisher的准确率如下:

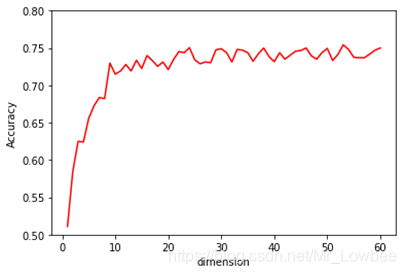
从图中可以看出,当选择的特征尺寸较小时,费舍尔的线性判别精度仅为50%至60%,而当选择的特征尺寸较大时,分类准确率可以达到70%至75 %
k最近邻居的准确率如下:
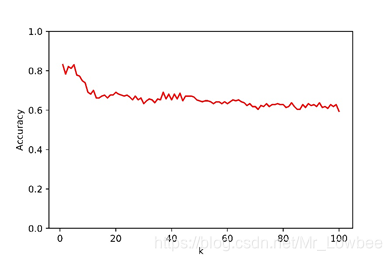
从k近邻图像可以看出,准确率显示出与Fisher相反的趋势. 当k较小时knn算法测试数据集,准确率可以超过80%. 甚至最近邻方法的分类准确率也可以达到83%. 但是,当k取较大值时,准确率会下降,保持在70%左右.
1. 使用最近邻法可以获得最高的精度,其效果优于费舍尔线性判别的结果. 当增加k时,k最近邻法不如Fisher判别法那么精确. 一般来说,k最近邻判别方法应该更稳定.

2. k最近邻法的思想简单,算法过程清晰,但计算过程非常繁琐. 因为对于每个测试样本,有必要从每个训练样本中找到欧几里得距离,然后对其进行排序,并且排序算法需要大量时间,然后采用前k个小的欧几里德距离类别标签来获得预测标签. 这样,对于诸如USPS手写这样的具有高维数和大量样本的数据集,k最近邻方法显然不是节省时间的方法.
3. Fisher线性判别算法虽然算法过程稍微复杂一些,但涉及矩阵求逆,矩阵正交和其他计算,具有很高的时空复杂度. 但是只要训练过程完成,我们就可以获得最优的投影方向W *. 对于所有测试样本,无需一一计算,并且可以直接使用决策函数进行确定. 也就是说,k近邻法根本没有训练过程,每次判别都必须重复计算,而Fisher线性判别只需要训练过程,大大节省了测试过程的计算时间. . 因此,对于训练集中有很多样本的情况,Fisher线性判别法是一种更好的方法.
4. 在多个分类的情况下,k最近邻可以完全忽略数据集中的类别数,因为k最近邻使用从所有样本到测试集的所有欧几里得距离来确定测试类别,而与数据类别中,k -nn仅采用前k个最近的欧几里得距离投票的结果,并且该结果将仅具有一个标签,即,k最近邻居方法完全不需要降维. 对于费舍尔线性判别,教科书仅提及两种分类的情况. 对于多分类问题,Fisher线性判别需要将多维特征简化为能够进行线性判别的维,并且还需要重新定义决策规则,从而大大增加了计算量. 复杂性. 因此,在数据集类别很多的情况下,k近邻判别法具有明显的优势.
实验环境Python3.6
GitHub地址如下
模式识别/ KNN
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-173208-1.html
-

-
张中远
犯军规也要打掉它
 360浏览器批量下载并保存图片
 网络嗅探器(视频侦探)正式版
 W764位旗舰版和纯版本系统下载
 图书销售系统参考
你很成功但你讲的话不全是对的