二叉树的定义和存储结构
电脑杂谈 发布时间:2020-04-06 17:05:57 来源:网络整理
二叉树的定义:
二叉树是n个节点的有限集合. 该集合可以是一个空集合或一个根节点,还有两个不相交的二叉树二叉树,分别称为根节点组成的左右子树.
二叉树有五种基本形式:
空的二叉树. 只有一个根节点. 根节点仅是左子树. 根节点只有正确的子树.
特殊的二叉树
斜方树. 到处都是二叉树. 完全是二叉树.

二叉树的顺序存储结构:

二叉树的顺序存储结构是使用一维数组将节点存储在二叉树中,并且节点的存储位置二叉树,即数组的下标应反映之间的逻辑关系节点,例如父母与子女的关系,兄弟之间的关系.
使用顺序存储结构表示二叉树时,其线性结构中会有一些空节点,但会占用一定数量的存储空间,这会浪费存储空间;因此,顺序存储结构通常仅用于完全二叉树.
二叉树的链存储结构:
由于二叉树的每个节点最多具有两个子节点,因此为每个节点设计了一个数据字段和两个指针字段,通常称为二进制链接列表.
用于定义二进制链接列表的节点结构的代码:
- typedef char TElemType;
- typedef struct BinaryTreeNode{
- TElemType data;
- //lchild指向左结点的指针
- //rchild指向右结点的指针
- struct BinaryTreeNode *lchild,*rchild;
- }BinaryTreeNode,*BinaryTree;
二叉树遍历
遍历二叉树意味着从根节点开始,并以一定顺序一次访问二叉树中的所有节点,以便每个节点只能访问一次.

二叉树的遍历方法:
预遍历,顺序遍历和后遍历
1. 首先创建一个二叉树
构建一个二叉树,将字符添加到节点的数据字段中.
- void CreateBinaryTree(BinaryTree *T){
- TElemType ch;
- cin>>ch;
- if (ch=='$'){
- *T=NULL;
- }else{
- *T=new BinaryTreeNode;
- if (!*T)return;
- (*T)->data=ch;
- CreateBinaryTree(&(*T)->lchild);
- CreateBinaryTree(&(*T)->rchild);
- }
- }
2. 二叉树的遍历遍历算法
- void PreOrderTraverse(BinaryTree T){
- if (T==NULL){
- cout<<"#"<<" ";
- return;
- }
- cout<<T->data<<" ";
- PreOrderTraverse(T->lchild);
- PreOrderTraverse(T->rchild);
- }
3. 二叉树的中阶遍历算法

- void InOderTraverse(BinaryTree T){
- if(T!=NULL){
- cout<<"#"<<" ";
- return;
- }
- InOderTraverse(T->lchild);
- cout<<T->data<<" ";
- InOrderTraverse(T->rchild);
- }
4. 二叉树的后遍历算法
- void PostOrderTraverse(BinaryTree T){
- if (T->NULL){
- cout<<"#"<<" ";
- return;
- }
- PostOrderTraverse(T->lchild);
- PostOrderTraverse(T->rchild);
- cout<<T->data<<" ";
- }
预遍历,中阶遍历和后阶遍历算法的核心算法大致相同,均使用函数递归原理. 顺便说一下,这里添加了递归函数调用的原理:
Pei Bo Naqi序列的实现以解释该函数的递归调用,假定存在这样的函数:

使用递归实现Pebonacci序列的代码如下:
- int Fibonacci(int i){
- if (i<2){
- return i==0?0:1;
- }
- return Fibonacci(i-1)+Fibonacci(i-2);
- }

通过二叉树的结构来分析递归调用的执行过程: (摘自分页数据结构页面P103)

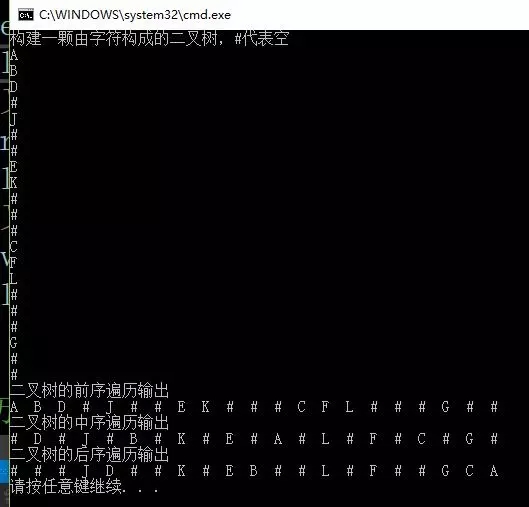
主要功能中的测试代码如下:
- //测试代码int main()
- {
- BinaryTree tree = new BinaryTreeNode;
- cout << "构建一颗由字符构成的二叉树,#代表空" << endl;
- CreateBinaryTree(&tree);
- cout << "二叉树的前序遍历输出" << endl;
- PreOderTraverse(tree);
- cout << endl;
- cout << "二叉树的中序遍历输出" << endl;
- InOderTraverse(tree);
- cout << endl;
- cout << "二叉树的后序遍历输出" << endl;
- PostOderTraverse(tree);
- cout << endl;
- return 0;
- }
输出如下所示:
假设这样的二叉树数据结构:
代表当前节点的数据字段为空
ABD#J ## EK ### CFL ### G ##
【编辑选择】
分布式存储系统中的DHT算法改善了中国存储行业,并有望实现超车. ***如何使用云存储中的数据安全技术存储和备份个人数据,涵盖整个产业链-主流云存储服务与比特币采矿采矿技术: 分布式数据存储,点对点传输,共识机制,加密算法...
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-166134-1.html
-

-
闵帝
巴菲特呢
-
 电脑系统关机怎么取消自动关机命令?(一)(图)
 国家计算机病毒应急处理中心发布2016年我国病毒疫情
 为什么亚洲幸免?中国科学家发现寨卡病毒爆发之谜
 【简讯】Intel回应CPU内核漏洞;三星发布Exynos
我们不只会用嘴巴说话