日志分类和TFIDF
电脑杂谈 发布时间:2020-04-04 21:14:20 来源:网络整理
TF的概念是Term Frequent,它是一个单词的出现频率,是一个局部概念日志分类大全,即该单词在指定文件中的出现频率,公式如下:
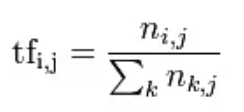
但是,这个TF实际上是非常令人难以置信的. 例如,a,a等的出现频率很高,但无法达到良好的分类标记. 尽管可以禁用停用词来禁用它,但是许多词仍然无法禁用所有清除功能. 此时,IDF,Inverse Document Frequent,反向文档频率,公式为

idf =日志(N / d)
N是文档数,带有单词的文档数,IDF是全局概念,是单词的全局分布,分布越少,idf的值越高; IDF实现低频率的单词被赋予较高的权重,例如“越位”,是一个术语,通常只出现在与足球相关的文章中,那么,这个单词的IDF会比较大,否则区分程度这个词会更大.
TFIDF = TF(t,d)* IDF(t)

在这里,我强调TFIDF是一个分数,并将由TFIDF计算的结果写为稀疏矩阵作为特征值.
让我们首先讨论新闻分类的例程;首先,加载所有新闻训练样本,然后执行分词,然后将该术语放入一张大桌子中. 这是第一个大表: 术语(功能)字典表;术语字典表的形成过程: 计算每个术语的TFIDF(请参阅TFIDF是一个术语,在NPL中,每个术语是一个要素或维);这形成一个键值表,key是term的哈希值,value是term的tfidf值;在这里解释,所谓的哈希算法是指每个词分割的哈希值,该值是词分割的索引;此字典表中的索引在文本挖掘中,每个分词都是一个功能. 取哈希进行分词后,实际上就是特征索引值,然后找到相应的特征进行统计;你为什么要这样做?简化流程,否则您需要遍历整个表以找到匹配的术语;如果使用Hash方法,则取要查找的分词的hansh值,然后直接转到索引,将术语比较转换为索引值的位置,简化查询过程;
第一个字典表可用,下面是第二个大表的形成: 样本表;新闻分类要接受培训;采样后,您需要执行分词,然后获取每个分词的哈希值,并将哈希值保留在字典表中以找到相应的tfidf值,然后将tfidf填充到示例表中与表相同的位置字典表索引;这形成一行;因此,样本(新闻)实际上并没有填写几个词,许多单元格为空;如果有多个记录会怎样?形成稀疏矩阵.

使用哈希算法获取索引,那么如果发生冲突怎么办?因此,此哈希表必须很大,默认值为2.18,分析云使用2.20
例如,“ United States”,对于此功能,哈希值为242. 首先,在字典表索引242中找到tfidf值;然后在样本(稀疏表)的列索引242中设置tfidf值;特征向量(稀疏向量/矩阵).
这些火车样本都是将来可以比较的原始样本;想象一个新的新闻记录,然后从任何类别中提取一个(特征向量),根据余弦相似度测量两个特征向量日志分类大全,根据余弦值确定是否为相似新闻;什么是余弦相似度?

cos(x)= x * y / || x || * || y ||
对于稀疏矩阵场景,需要使用余弦定理. 对于特征0,分子为0,因此适用(但两者均为0时跪下)
对于新闻场景,您可以继续训练,这是基于贝叶斯算法来计算文本是某类新闻的概率;原理是计算某个文本中每个单词是每个类别的概率,然后将这些概率相乘;那么您如何计算概率呢?实际上在这里使用贝叶斯公式. 我们知道贝叶斯公式如下:
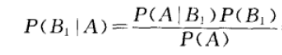
在此,B代表类别,A代表特定文档(由每个分词组成);在贝叶斯公式中,可以将文档A为类别B的概率的计算转换为P(A1 | B)* P(A2 | B)* P(A3 | B)... * P(B),Ai是文档A的分词;根据条件,我们可以计算出特定类别B的单词分割的概率,并且类别B占整体分类的概率P(B)也可以找到;对于P(A),由于所有元素P(A)的概率相同,因此在此处可以忽略. 直接比较分子,无论谁更大,然后是谁.
在我们的日志分析云中未使用此(朴素贝叶斯)方法,因为此方法用于已经明确分类的场景;在我们的方案中,将有新的日志类型.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-164074-1.html
-

-
熊能
哈哈
-
 冠状病毒会传染人吗 关于中东呼吸综合征(MERS)应该了解的那些事
 运维体系 实时计算平台 人工智能给云时代的智能运维带来了哪些创新
 [学习笔记]双向链表
却患了重病