大数据OLAP框架的比较
电脑杂谈 发布时间:2020-03-21 06:02:25 来源:网络整理
以上是大数据处理中常用的四个技术原理. 上述处理数据的方法极大地提高了单位时间的数据处理能力,但仍没有摆脱数据量与查询时间之间的线性关系. . 因此olap数据源,我们还有另一种OLAP处理方法:
当前,没有可以满足各种方案的查询需求的OLAP系统. 根本原因是,没有一个系统可以同时在数据量,性能和灵活性这三个方面做到完美,并且每个系统在设计时都需要在这三个方面之间做出选择. 这有点像我们的CAP理论~~~
image.png

基于预先计算的和MOLAP MPP之间的差异以及预先计算的方法: MPP非常灵活,其数据基于数据表分析. 它支持实时数据导入和实时分析,并且您可以查询任何要查询的数据. 但是,它的缺点也很明显. 内存资源需求很大. MPP的OLAP通常基于内存,因此它需要大量的机器内存. 对于太多数据,它将极大地影响性能. 基于预计算的方法,它有点不灵活,无法在预计算之外查询数据,但是其优点是相对稳定,数据量的增加不会对查询速度产生很大的影响,而要求存储空间不会随数据量而变化. 增加并膨胀.
image.png
前两个主要用于评估基于MPP的OLAP框架,

HAWQ,Presto,ClickHouse在大多数情况下,HAWQ性能低于Presto和ClickHouse. Presto的速度取决于网络,因为它没有存储数据的功能. ClickHouse是目前最快的MPP引擎. 但是,它在多表查询上的性能不好. Hive Hawq,Presto,Impala,Sparksql,Clickhouse,Greenplum
image.png
麒麟·普雷斯托·德鲁伊这是美团16日初的报道. 它相对较旧,没有太多参考意义,但它也表明麒麟和德鲁伊的反应速度更快. Kylin提供了更完整的功能和SQL支持,而Druid提供了实时数据提取. 两者基本上是查询性能的一个数量级.

image.png
MPP似乎是一个更好的选择,但是由于它是基于内存计算的,因此它相对不稳定,例如遇到由于内存倾斜或数据大小以及查询语句导致的数据损坏. 该差异可能导致查询时间的波动. 速度可能很快,但是在某些情况下可能无法长时间生成数据.
预计算相对地放弃了灵活的查询,但是节省了大量的内存计算成本,并且由于它属于预计算类别,因此它不支持不支持的数据,但是对于支持的查询,您可以实现相对稳定的查询速度,
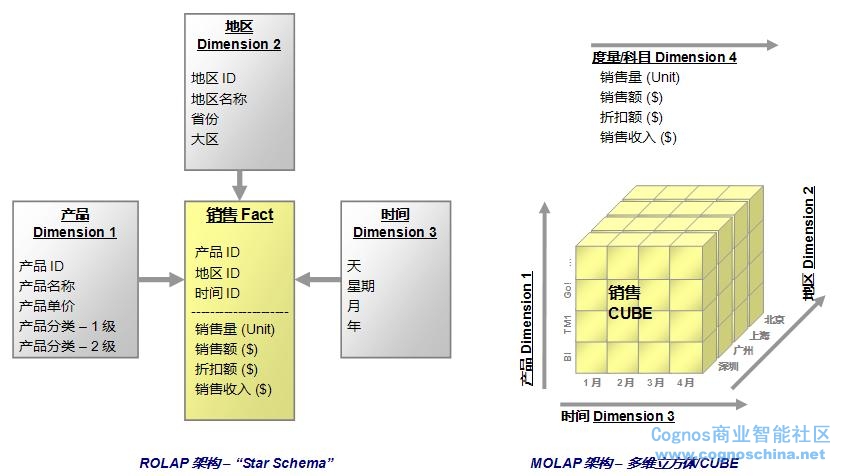
对于稳定的日常任务,我们可以使用预先计算方法. 对于某些偶尔的临时任务,我们可以通过MPP导出它们. 不需要为某些特殊需求而增加机器资源. 开销.
在基于预计算的框架中,我倾向于kylin,因为他可以更好地管理数据olap数据源,具有更好的SQL支持,并且他的社区在中国更活跃,然后有中文文档~~~~~
另一点是,许多培训机构已经在课程中设置了麒麟…….
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-146830-1.html
-

-
李从善
一定支持
-
-
王淑一
因为这一次到南海
 weixin_30480583
 计算机OCR字符识别技术的原理和未来发展趋势
 semaphore java.util.concurrent常用类(Cou
 C语言中的Static和内联函数
这么多水军