Hadoop分布式计算2-MapReduce计算框架架构原理
电脑杂谈 发布时间:2020-01-24 16:02:03 来源:网络整理
前面看到MapReduce编程模型将大数据计算过程切分为map和reduce两个阶段,在map阶段为每位数据块分配一个map计算任务,然后将所有map输出的key进行合并,相同的key以及对应的value发送给同一个reduce任务去处理。
这个过程有两个关键问题需要处理
如何为每位数据块分配一个map计算任务,代码是如何发送数据块所在服务器的,发送过去是怎样启动的,启动之后既如何了解自己应该计算的数据在文件什么位置(数据块id是哪个)。处于不同服务器的map输出的<key , value> ,如何把同样的key聚合在一起发送给reduce任务。
这两个关键问题正好对应上面文章中“MapReduce计算过程”一图中两处“MapReduce框架处理”。
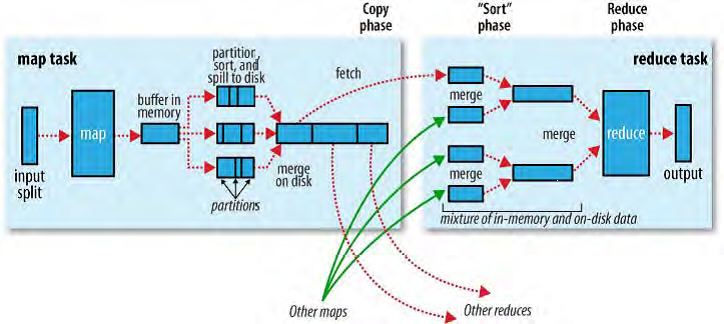
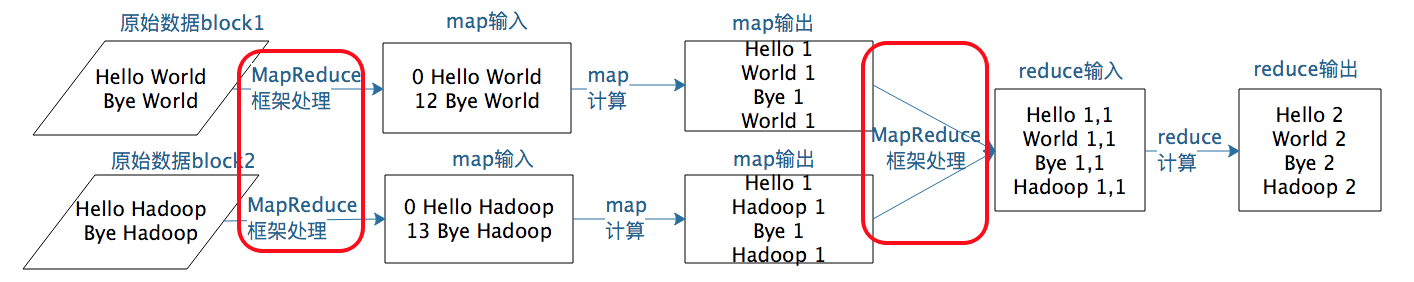
MapReduce计算过程中两处MapReduce框架处理
我们先看下MapReduce是怎样启动处理一个大数据计算应用作业的。
我们以Hadoop1为例,MapReduce运行过程涉及下列几类关键进程:
大数据应用进程:启动用户MapReduce程序的主入口,主要指定Map和Reduce类、输入输出文件模式等,并提交作业帮Hadoop集群。JobTracker进程:根据应处理的输入数据量启动相应数目的map和reduce进程任务,并管控整个作业生命周期的任务调度跟监控。JobTracker进程在整个Hadoop集群全局唯一。TaskTracker进程:负责开展和管控map进程或者reduce进程。因为必须每个数据块都有对应的map函数,TaskTracker进程一般跟HDFS的DataNode进程推进在同一个服务器,也就是说,Hadoop集群中绝大多数服务器同时运行DataNode进程和TaskTacker进程。
如下图图示。

MapReduce作业推进和运行模式
具体作业推进和计算过程如下:
应用进程将用户作业jar包传输在HDFS中,将来这种jar包会分发给Hadoop集群中的服务器执行MapReduce计算。应用程序提交job作业帮JobTracker。JobTacker根据作业调度策略创建JobInProcess树,每个作业就会有一个自己的JobInProcess树。JobInProcess根据输入数据分片数量(通常状况就是数据块的数量)和修改的reduce数目创建相应人数的TaskInProcess。TaskTracker进程跟JobTracker进程进行定时通信。如果TaskTracker有空闲的计算资源(空闲CPU核),JobTracker就会帮他分配任务。分配任务的之后会按照TaskTracker的服务器名字匹配在同一台机器上的数据块计算任务给它,使推进的计算任务正好处理本机上的数据,以推动我们一开始就看到的“移动计算比移动数据最便宜”。TaskRunner收到任务后按照任务类别(map还是reduce),任务参数(作业jar包路径,输入数据文件模式,要处理的数据在文件中的起始位置和偏移量,数据块多个备份的DataNode主机名等)启动相应的map或者reduce进程。map或者reduce程序开启后,检查本地是否有应执行任务的jar包文件,如果没有,就去HDFS上下载,然后读取map或者reduce代码开始执行。如果是map进程,从HDFS读取数据(通常要写入的数据块正好存储在本机)。如果是reduce进程,将结果数据写出到HDFS。

通过以上过程,MapReduce可以将大数据作业计算任务分布在整个Hadoop集群中运行,每个map计算任务应处理的数据一般都可从本地磁盘上抓取到。而用户应做的只是是编写一个map函数跟一个reduce函数就可以了,根本不用关心这两个函数是怎样被分布启动至集群上的,数据块又是怎样分配给计算任务的。这一切都由MapReduce计算框架完成。
在WordCount例子中,要统计同样单词在所有输入数据中发生的数量,而一个map只能处理一部分数据,一个热门词汇几乎会出现在所有的map中,这些词汇应当应合并到一起进行统计就能受到正确的结果。
事实上,几乎所有的大数据计算场景都必须处理数据关联的弊端,简单如WordCount只要对key进行合并就可以了,复杂如的join操作,需要对两种类别(或者更多种类)的数据按照key进行连接。
MapReduce计算框架处理数据合并与联结的操作就在map输出与reduce输入之间,这个过程有个专门的词组来表述,叫做shuffle。

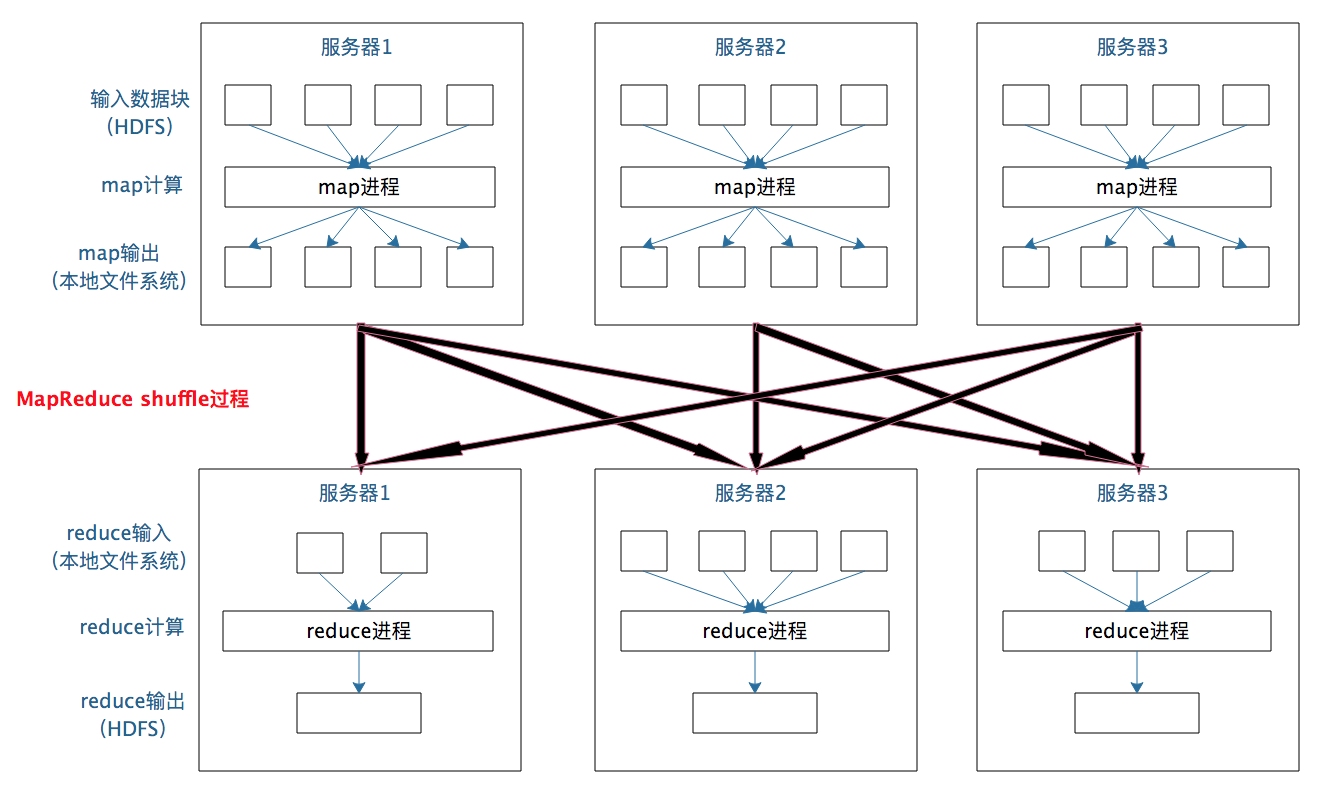
MapReduce shuffle过程
每个map任务的计算结果就会读取到本地文件系统,等map任务快要计算完成的之后,MapReduce计算框架会开启shuffle过程,在map端调用一个Partitioner接口,对map产生的每个<key , value>进行reduce分区选择,然后借助http通信发送给对应的reduce进程。这样不管map位于哪个服务器节点,相同的key一定会被发送给同样的reduce进程。reduce端对收到的<key , value>进行顺序和合并,相同的key放在一起hadoop mapreduce 原理,组成一个<key , value集合>传递给reduce执行。
MapReduce框架缺省的Partitioner用key的哈希值对reduce任务数目取模,相同的key一定会落在同样的reduce任务id上,实现上,这样的Partitioner代码只应该一行,如下所示。
 /** Use {@link Object#hashCode()} to partition. */
public int getPartition(K2 key, V2 value, int numReduceTasks) {
    return (key.hashCode() & Integer.MAX_VALUE) % numReduceTasks;
}shuffle是大数据计算过程中出现奇迹的地方,不管是MapReduce还是Sparkhadoop mapreduce 原理,只要是大数据批处理计算,一定会有shuffle过程,让数据关联起来,数据的内在关系跟价值能够展现出来。不理解shuffle,就会在map和reduce编程中产生问题,不知道该怎么正确设计map的输出跟reduce的输入。shuffle也是整个MapReduce过程中更难最消耗性能的地方,在MapReduce早期代码中,一半代码都是关于shuffle处理的。
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-138048-1.html

 JavaScript 数据类型
 恒智天成资料软件官方版下载【工程建筑】
 中国号码验证
 分布式文件系统GFS .... ppt的云计算原理免费全文阅读
唯一赚到钱的是豆瓣