五. 爬虫实战 - 酷狗TOP500的数据
电脑杂谈 发布时间:2020-01-11 13:02:21 来源:网络整理
酷狗不能手动翻页,可以尝试将上述网址的1变成2top500酷狗,发现能正常访问。每页有22首歌曲,共500首,所以生成23页即可。
共有23页top500酷狗,规律为:

...
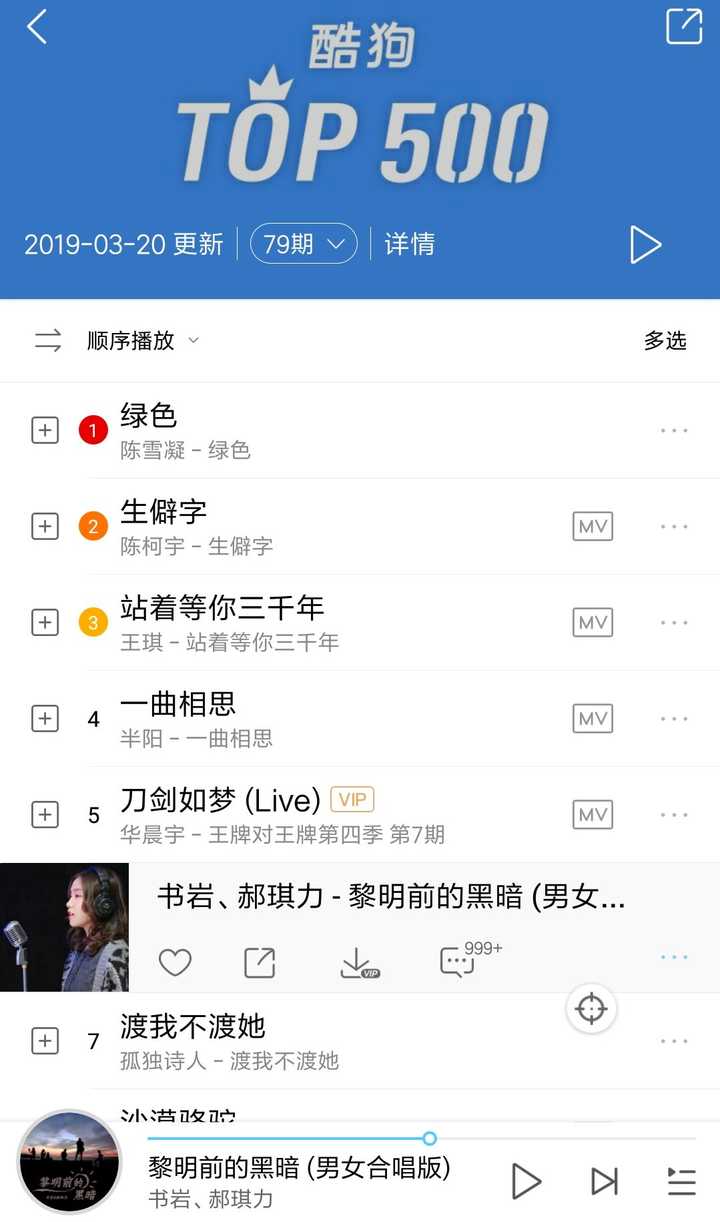
爬取内容:排名情况,歌手,歌曲名,歌曲时长

功能非常简洁,直接上代码:
import requests
from bs4 import BeautifulSoup
import time
headers = {'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65.0.3294.6 Safari/537.36'}
##获取信息
def get_info(url):
    r = requests.get(url,headers=headers)
    print(r.status_code)
    soup = BeautifulSoup(r.text,"lxml")
    ranks = soup.select("span.pc_temp_num")
    # for rank in ranks:
    #     print(rank.text.strip())

    titles = soup.select("a.pc_temp_songname")
    # for title in titles:
    #     singer = title.text.split("-")[0].strip()
    #     song = title.text.split("-")[1].strip()
    #     print(singer,song)

    times = soup.select("span.pc_temp_time")
    # for time in times:
    #     time = time.text.strip()
    #     print(time)
    for rank,title,time in zip(ranks,titles,times):
        data = {
            'rank':rank.text.strip(),
            'singer':title.text.split("-")[0].strip(),
            'song':title.text.split("-")[1].strip(),
            'time':time.text.strip()
        }
        print(data)
if __name__ == "__main__":
    urls = ["http://www.kugou.com/yy/rank/home/{}-8888.html".format(i) for i in range(1,24)]    ##构造URL的请求页面
    for url in urls:
        get_info(url)
        time.sleep(1)
部分结果为:
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-136519-1.html
相关阅读
发表评论 请自觉遵守互联网相关的政策法规,严禁发布、暴力、反动的言论

 如何在单词中设置数字的千位分隔符?两种轻松完成的方式
 如何编写图书管理系统 河北宏润钢木家具
 SpringBoot AOP(方面注释方法)的详细说明
 为什么有人写计算机病毒
打完了把它拖到12海里以内来