C语言与内存的关系 | SimonLiang | 博客园
电脑杂谈 发布时间:2019-12-25 20:01:49 来源:网络整理
计算机程序目的是程序的运行,运行的目的是为了受到一定的结果以及是在运行的过程中执行了某项动作。程序 = 代码(加工数据的动作) + 数据
函数可以完美的解释: 返回值是void ,说明没有输出结果,形参为void,说明没有输入数据。反之,套用即可。当然还有即输出结果跟输入数据的,如 int add(int a,int b);
所以,这就回答了为什么C语言需要内存这个问题了:
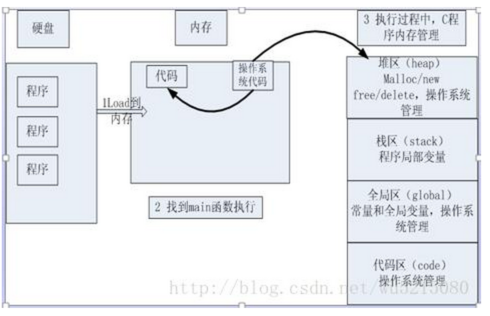
99.9的程序必须数据的参与,内存储存可变数据,数据在程序中体现为全局函数和局部变量(在gcc中,常量也储存在存储中,在单片机中,常量存储在flash中,也就是存在代码段中)。所以内存对于程序的有效力是本质相关的!所以说C语言程序需要内存。
冯诺依曼结构:数据和代码放到一起;哈佛结构:数据和代码分开。按照我此时的观念去理解,代码即方程,数据即局部变量+全局变量。
在JZ2440 中运行的Linux平台上,运行应用程序时,所有的应用程序代码跟数据都在DRAM中,所以是冯诺依曼结构;在单片机(裸机)中c语言内存分配对应,程序烧写在NorFlash上,然后将程序在Flash中原地运行,程序中涉及至的数据在RAM(SRAM)中运行,这就是哈佛结构。

现在的水平,还没到管理内存的地步,我们先不研究它。但是得清楚,内存有存储管理制度,为用户提供了API接口,如C/C++中的malloc(),free(),new()等变量;java/C# 则直接回收内存,基本不用对内存进行操作了。
位=1bit,字节=8bit
内存位宽、半字跟字得看处理器是多少位的,比如说处理器是32bit的c语言内存分配对应,则内存位宽是32bit,字=32bit ,半字是字的一半,就是16bit 了。在MSP430上,由于它是16bit处理器,所以它的字是16bit的。80c51单片机是8位的,所以位宽是8位的

在VC++平台上,int默认为long int类型,长度是4;在TC平台上,int默认为short int,长度为2.
CPU依照其处理信息的字长可以分为:八位微处理器、十六位微处理器、三十二位微处理器以及六十四位微处理器等。CPU最大能查找多大范围的地址叫做寻址能力,CPU的寻址能力以字节为单位,如32位寻址的CPU可以寻址2的32次方大小的地址也就是4G,这只是为什么32位的CPU最大能搭配4G内存的缘由,再多的话CPU

就找不到了。我们安装平台时所说的32bit系统和64位系统就是说的这种。64位的寻址能力很强,当然要求的硬件配置也更高!
内存是以字节为基础分配的。
如给某个绝对地址赋值为12 : *(unsignedint*)0x1000 = 12;//系统会分配0x1000、0x1001、0x1002、0x1003地址空间为int类型
struct a
{
	char c;
	int b;
	long d;
};

sizeof(a) = 12;

这就是内存对齐,内存对齐了才容易找,但是为了节约空间,可以不适用内存对齐的方法。不过这些模式目前很少使用了。
另外,int这种数据类别,由于其使用的精度高,十分对应软件需求,甚至在使用bool(1bit)的请况下,分配了一个int内存给它(即使浪费了31bit),但是效率推动了许多。这就是增大了内存,提高了强度,换句话说,就是提高了流畅性和客户体验。这就是内存对齐的威力!
其实内存对齐还有一个重要的类别,就是数组(作为更简洁的数据结构)。与结构体的差别:1.结构体数据容易增减;2.数组要求元素相似,分配的存储确定。3.寻址不一样,数组为a[1], 结构体需要定义结构体类型之后,定义结构体变量在用 a->b 或者 a.b
结合前面表述内存对齐的之后可以看到,C语言是借助数据类型去操作内存的。
那什么是数据类型呢?数据类别的本质意义是存储中所占的内存格子长度+解析方式。不同的数据类别有不同的解读方式如
int a; //内存就会给变量a分配一块4个字节的内存,&a表示首字节的地址。
这个解析方式为int类型,分配4个字节,存储整型数据
float b; //分配4个字节,存储浮点型数据(比如,前两个字节存整数部分,后两个字节存小数部分..)
这个解析方式为float类别,分配4个字节,存储浮点型数据
double * c; //分配4个字节,存储指针变量。
这个解析方式为double指针类型,分配4个字节,存储指针变量,这个解读方式对应数据指向double类型的数据。
栈的功能实现代码:
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-134642-1.html
-

-
李小迪
一会儿说伊拉克“可能”有杀伤性武器要入侵伊拉克
-
马小江
強制重啟均無效
 e动交行_e动交行app官方网站_交通银行e动交行
 内部食堂承包合同 咸阳市永寿县职教中心学生(2018)食堂承包经营项目招标
 用C语言编写的图书借阅管理系统源代码
 Java多线程7: 死锁
俄不帮