mapreduce数据去重原理_mapreduce 原理_mapreduce原理和执行过程
电脑杂谈 发布时间:2019-09-25 15:03:03 来源:网络整理
一、实验目的
数据去重这个例子主要是为了让读者把握并运用并行化思想对数据进行有意义的筛选。统计大数据集上的数据类型个数、从网站日志中计算访问地等很多虽然匮乏的任务就会涉及数据去重。
二、实例描述
对数据文件中的数据进行去重mapreduce数据去重原理,数据文件中的每行都是一个数据。
样本输入:
file1: file2:

样本输出:
2006-6-10b
2006-6-10a
2006-6-11c
2006-6-11b
2006-6-12d
2006-6-13a
2006-6-14b
2006-6-14c
2006-6-15c
2006-6-15d
2006-6-9a
2006-6-9b
三、设计模式
数据去重实例的最后目的是让原始数据中发生数量达到一次的数据在输出文件中只发生一次。我们自然而然会想到将同一个数据的所有记录都留给一台Reduce机器,无论这个数据发生多少次,只要在最后的结果中输出一次就行了。具体就是Reduce的输入需要以数据成为Key,而对value-list则没有要求。当Reduce接收到一个<key,value-list>时就直接将Key复制输出的Key中,并将value设定成空值。
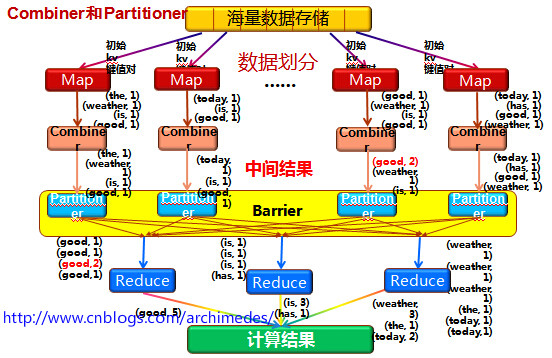
在MapReduce流程中,Map的输出<Key,value>经过shuffle过程聚集成<key,value-list>后会被交给Reduce。所以从设计好的Reduce输入可以反推出Map的输出的Key应为数据,而value为任意值。继续反推,Map输出的Key为数据。而在这个例子中每个数据代表输入文件中的一行内容,所以Map阶段要完成的任务就是在运用Haodoop默认的作业输入方法以后,将value设定成Key,并直接输出(输出中的value任意)。Map中的结果经过shuffle过程以后被留给reduce。在Reduce阶段不管每个Key有多少个value,都直接将输入的Key复制为输出的Keymapreduce数据去重原理,并输出就可以了(输出中的value被修改成空)。
四、程序代码
package HadoopShiZhang2;
import java.io.IOException;
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.Mapper;
import org.apache.hadoop.mapreduce.Reducer;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;
import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;
public class Dedup {
static final String INPUT_PATH = "hdfs://chaoren:9000/file";
static final String OUT_PATH = "hdfs://chaoren:9000/out";
//map将输入中的value复制到输出数据的key上,并直接输出
public static class Map extends Mapper<Object, Text, Text, Text>{
private static Text line = new Text();
public void map(Object key, Text value, Context context) throws IOException, InterruptedException {
line = value;
context.write(line, new Text(""));
}
}
//reduce将输入中的key复制到输出数据的key上,并直接输出
public static class Reduce extends Reducer<Text,Text,Text,Text> {
public void reduce(Text key, Iterable<Text> values, Context context ) throws IOException, InterruptedException {
context.write(key, new Text(""));

}
}
public static void main(String[] args) throws Exception {
final Job job = new Job(new Configuration(), Dedup.class.getSimpleName());
//打JAR包
job.setJarByClass(Dedup.class);
//1.1 指定输入文件模式
FileInputFormat.setInputPaths(job, INPUT_PATH);
//指定哪个类用来格式化输入文件
job.setInputFormatClass(TextInputFormat.class);
//1.2指定自定义的Mapper类
job.setMapperClass(Map.class);
//指定输出<k2,v2>的类型
job.setMapOutputKeyClass(Text.class);
job.setMapOutputValueClass(Text.class);
//1.3 指定分区类
//1.4 TODO 排序、分区

//1.5 TODO (可选)合并
job.setCombinerClass(Reduce.class);
//2.2 指定自定义的reduce类
job.setReducerClass(Reduce.class);
//指定输出<k3,v3>的类型
job.setOutputKeyClass(Text.class);
job.setOutputValueClass(Text.class);
//2.3 指定输出到哪里
FileOutputFormat.setOutputPath(job, new Path(OUT_PATH));
//设定输出文件的格式化类
job.setOutputFormatClass(TextOutputFormat.class);
//把代码提交给JobTracker执行
job.waitForCompletion(true);
}
}
五、实验过程与结果


本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-124114-1.html

 什么是邮件服务器?
 无锅天线_无锅卫星天线是真的吗
 Flying Fire动态壁纸(动态壁纸计算机桌面)v1.1.8.8正式版
 单人(单人模式)
太爱你了