mapreduce 函数原理_kmeans mapreduce 原理_hive mapreduce原理
电脑杂谈 发布时间:2019-09-09 19:05:33 来源:网络整理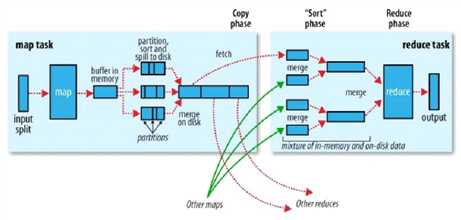
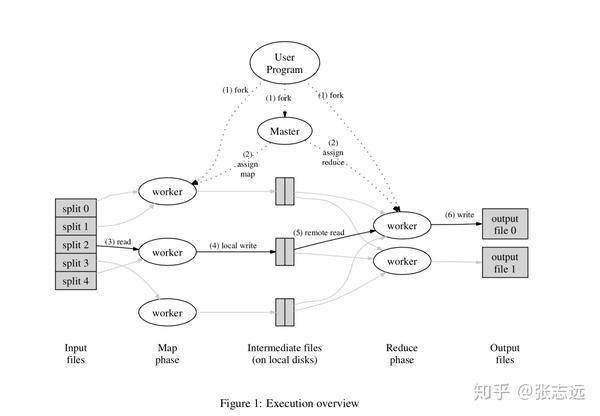
一切都是从最上面的user program开始的,user program链接了MapReduce库,实现了最基本的Map函数和Reduce函数。图中执行的次序都用数字标记了。
MapReduce库先把userprogram的输入文件划分为M份(M为用户定义),如图左方所示分成了split0~4;然后使用fork将用户进程拷贝到集群内其他机器上。user program的副本中有一个称为master,其余称为worker,master是负责调度的,为空闲worker分配作业(Map作业以及Reduce作业),worker的数量也有
可以由用户选定的。被分配了Map作业的worker,开始加载对应分片的输入数据mapreduce 函数原理,Map作业总量是由M决定的,和split一一对应;Map作业从输入数据中抽取出字段对,每一个键值对
都作为参数传递给map函数,map变量造成的后面键值对被缓存在硬盘中。
缓存的后面键值对会被定期写入本地磁盘,而且被分为R个区,R的大小是由用户定义的,将来每个区会对应一个Reduce作业;这些后面键值对的位置会被通报
给master,master负责将信息转发给Reduce worker。
master通知分配了Reduce作业的worker它负责的分区在哪个位置(肯定不止一个地方,每个Map作业造成的后面键值对都或许映射到所有R个不同分区),当
Reduce worker把所有它负责的后面键值对都读回来后,先对他们进行顺序,使得同样键的键值对聚集在一起。因为不同的键可能会映射到同一个分区也就是
同一个Reduce作业(谁让分区少呢),所以排序是需要的。
reduce worker遍历顺序后的后面键值对,对于每个唯一的键,都将键与关联的值释放给reduce函数,reduce函数造成的输出会添加到这个分区的输出文件中。
当所有的Map和Reduce作业都完成了,master唤醒正版的user program,MapReduce函数调用返回user program的代码。

所有执行完毕后,MapReduce输出放到了R个分区的输出文件中(分别对应一个Reduce作业)。用户一般并不需要合并这R个文件,而是将其成为输入交给另一
个MapReduce程序处理。整个过程中,输入数据是来自底层分布式文件系统(GFS)的,中间数据是放到本地文件系统的,最终输出数据是读取底层分布式文件系统(GFFS)的。而且我们要切记Map/Reduce作业和map/reduce函数的差别:Map作业处理一个输入数据的分片,可能还要读取多次map函数来处理每个输入数组对;Reduce作业处理一个分区的后面键值对,期间要对每位不同的键调用一次reduce函数,Reduce作业最后也对应一个输出文件。
MapReduce中Shuffle过程
Shuffle的过程:描述数据从map task输出到reduce task输入的这段过程。
我们对Shuffle过程的希望是:
★ 完整地从map task端拉取数据到reduce task端
★ 跨界点拉取数据时,尽量避免对带宽的不必要消耗
★ 减小磁盘IO对task执行的影响
先看map端:
详细流程:

maptask收集我们的map()方法输出的kv对,放到存储缓冲区中从硬盘缓冲区不断溢出本地磁盘文件,可能会溢出多个文件多个溢出文件会被合并成大的溢出文件在溢出过程中,及合并的过程中,都要调用partitoner进行分组和对于key进行顺序
再看reduce端:
详细流程:
reducetask根据自己的分区号,去各个maptask机器上取相应的结果分区数据reducetask会取到同一个分区的来自不同maptask的结果文件,reducetask会将这种文件再进行合并(归并排序)合并成大文件后,shuffle的过程也就结束了,后面开启reducetask的逻辑运算过程(从文件中取出一个一个的字段对group,调用用户自定义的reduce()方法)
Shuffle中的缓冲区大小会妨碍到mapreduce程序的执行效率,原则上说,缓冲区越大,磁盘io的数量越少,执行速度就越快
缓冲区的大小可以借助参数微调, 参数:io.sort.mb 默认100M
mapreduce 其实是分治算法的一种现,所谓分治算法就是“就是分而治之 ,将大的弊端分解为相似类型的子问题(最好具有同样的规模),对子问题进行求解,然后合并成大难题的解。
mapreduce就是分治法的一种,将输入进行分片,然后交给不同的task进行处理,然后合并成最后的解。 mapreduce实际的处理过程可以理解为Input->Map->Sort->Combine->Partition->Reduce->Output。
Input阶段
数据以一定的格式传递给Mapper,有TextInputFormat,DBInputFormat,SequenceFileFormat等可以使用,在Job.setInputFormat可以修改,也可以自定义分片函数。map阶段
对输入的(key,value)进行处理,即map(k1,v1)->list(k2,v2),使用Job.setMapperClass进行修改。Sort阶段
对于Mapper的输出进行顺序,使用Job.setOutputKeyComparatorClass进行修改,然后定义顺序规则。Combine阶段
这个阶段针对Sort之后又同样key的结果进行合并,使用Job.setCombinerClass进行修改,也可以自定义Combine Class类。Partition阶段
将Mapper的后面结果根据key的范围界定为R份(Reduce作业的个数),默认使用HashPartioner(key.hashCode()&Integer.MAX_VALUE%numPartitions)mapreduce 函数原理,也可以自定义划分的变量。使用Job.setPartitionClass设置。Reduce阶段
对于Mapper阶段的结果进行进一步处理,Job.setReducerClass进行修改自定义的Reduce类。Output阶段
Reducer输出数据的格式。
Yarn是一个资源调度系统,负责为运算程序提供服务器运算资源,相当于一个分布式的操作系统平台,而mapreduce等运算程序则相当于运行于操作系统之上的应用程序。
MapReduce运行在Yarn之上,其架构:
ResourceManager
RM是一个全局的资源管理器,负责整个平台的资源管控与分配,主要包含两个组件:调度器Scheduler和应用程序管理器Applications Manager。
调度器接收来自ApplicationMaster的应用程序资源请求,把集群中的资源以“容器”的方式分配给强调申请的应用程序,容器的选用一般考虑应用程序所要处理的数据的位置,就近选择,实现“计算向数据靠拢”。
Container容器

动态资源分配的单位,每个容器中都封装一定数目的CPU、内存、磁盘等资源,从而限制每个应用程序可以使用的资源量。
ApplicationsManager应用程序管理器
负责平台中所有应用程序的管控工作,主要包含应用程序提交,与调度器协商资源以开展、监控、重启ApplicationMaster。
ResourceManager接收用户提交的作业(记住,hadoop中处理的客户程序都是以作业的方式来处理的,只是我们计算的之后把作业成为了一个个的map/reduce任务),按照作业的上下文信息及从NodeManager收集来的容器状态信息,启动调度过程,在NodeManager中开启一个容器为ApplicationMaster(applicationMaster的运行也占用资源,它是由resourceManager在nodeManager中开启的一个container)。
其作用是:
为应用程序申请资源,并分配给外部任务。
负责这个任务的调度、监控与容错(任务成功时表态资源,重启任务)。
NodeManager
单个节点上的资源管控,每个节点上就有一个, 监控节点上容器的资源使用状况。
跟踪节点健康状况。
以“心跳”方式与ResourceManager保持通信。
接收来自ResourceManager和ApplicationMaster的各类请求。
YARN:资源(linux资源隔离模式:运算资源---运算程序jar/配置文件/CPU/内存/IO--从linux中开辟出比如硬盘、处理器的container虚拟容器类似docker、openstack)调度平台,负责管理资源调度和任务分配
用户提交程序,包括ApplicationMaster程序,启动AM的命令和用户程序。YARN中的ResourceManager负责接收和处理来自客户端的程序,选择NodeManager中的一个容器,启动MR App Mst(ApplicationMaster)。MR App Mst创建后会先向 ResourceManager注册。MR App Mst轮询向ResourceManager申请资源。ResourceManager以容器的形式向强调申请的AM分配资源,NodeManager接收后建立容器容器Container。在容器中开启任务,先执行MapTask,容错:如果有一个mapTask执行成功,请再次申请一个容器container。任务备份:一个mapTask执行慢,将再次递交container执行备份任务,取较快者。MapTask执行完成后,appmaster想RM申请指定次数的容器,运行reduceTask程序。各个任务向Am报告状况与进度。应用程序结束后,AM向RM注销并关闭自己。
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-122304-1.html
-

-
刘斌
希望能有所帮助
-
黄茹
那是替我们大陆人秀的
-
 什么是邮件服务器?
 无锅天线_无锅卫星天线是真的吗
 Flying Fire动态壁纸(动态壁纸计算机桌面)v1.1.8.8正式版
 单人(单人模式)
美狗再不收敛