02硬盘故障检测模型的构建
电脑杂谈 发布时间:2020-09-16 17:03:54 来源:网络整理
01平台环境:创建模型培训服务
(对iMaster NAIE培训平台有简单的了解,熟悉工作界面和实验环境。)
工作流程
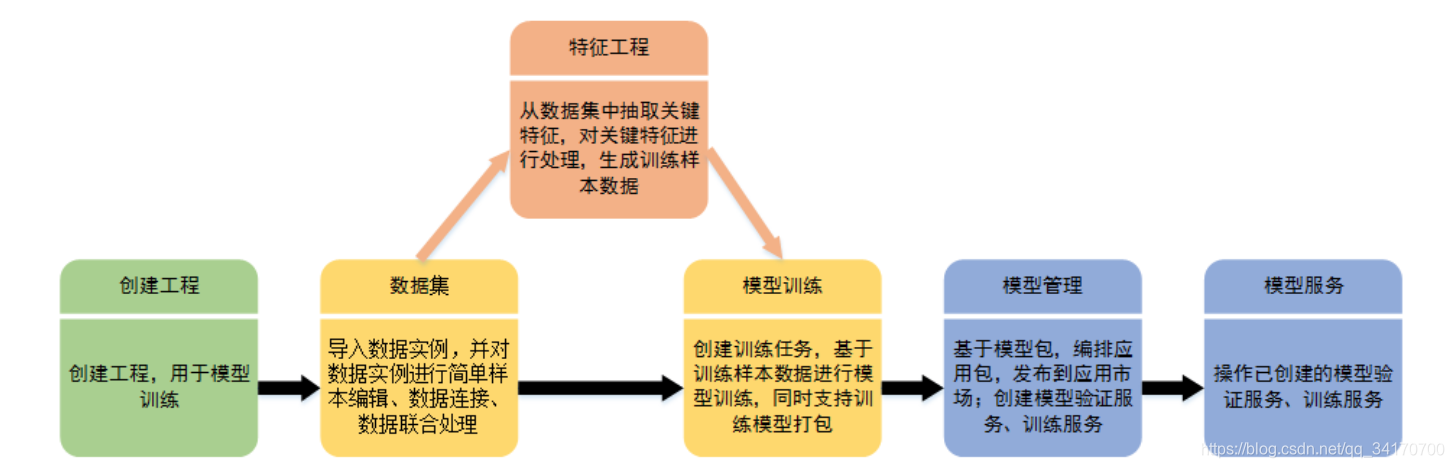
使用iMaster NAIE培训平台进行数据建模分为6个主要步骤:
创建项目:
数据集:

特征工程:
模型训练:
模型管理:
模型服务:
硬盘故障检测过程
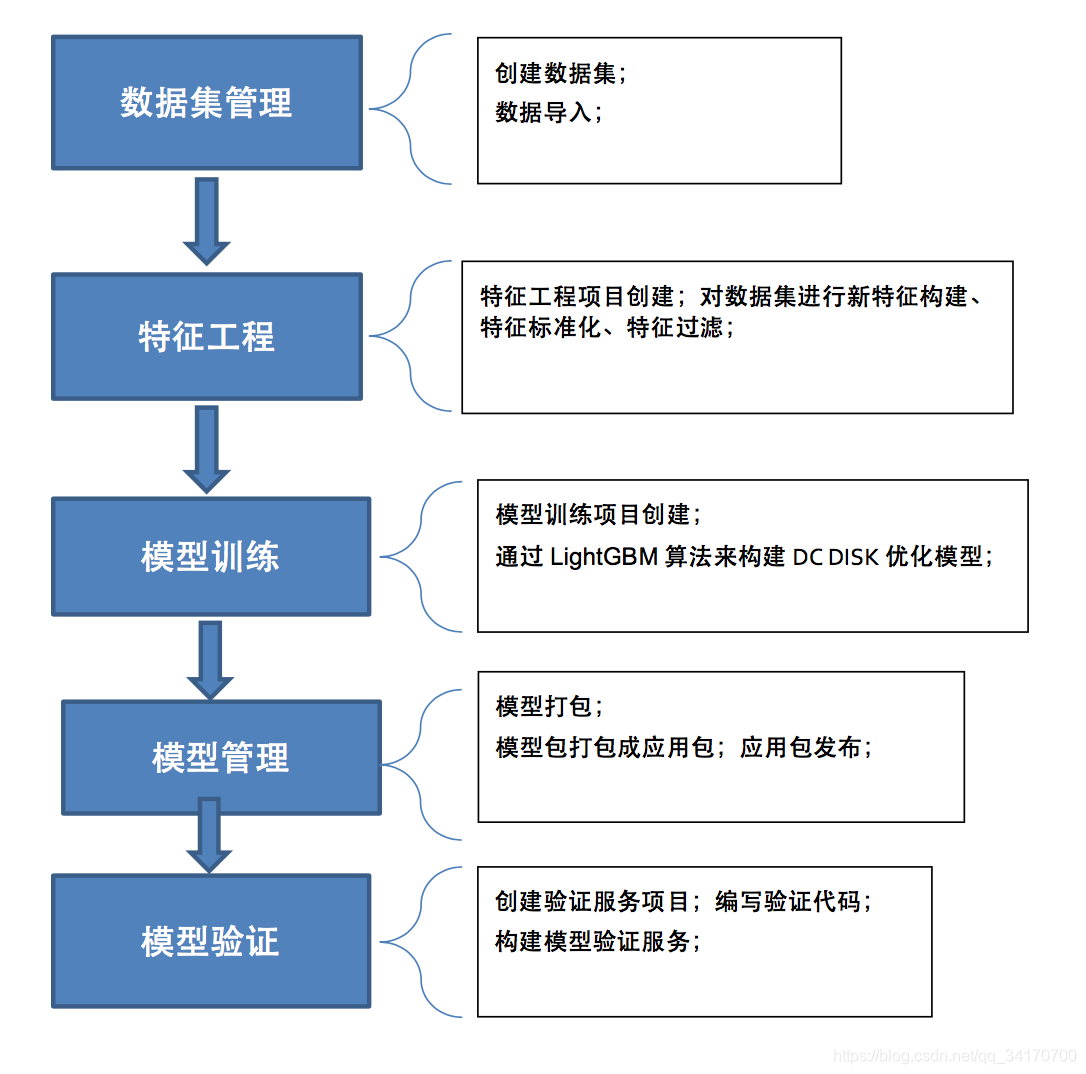

02硬盘故障检测模型构建的场景描述|业务目标数据中心的硬件故障中有48%是硬盘故障,只有在故障发生后才能检测到,这极大地影响了效率和运维成本;缺乏有效的预测方法,无法提前进行有硬件迁移的计划,并且硬盘长时间处于亚健康状态,这会影响业务绩效。
基于硬盘的SMART特性,机器学习用于提前预测硬盘故障的时间,估计数据修复窗口,根据负载制定修复计划并预先执行修复操作。
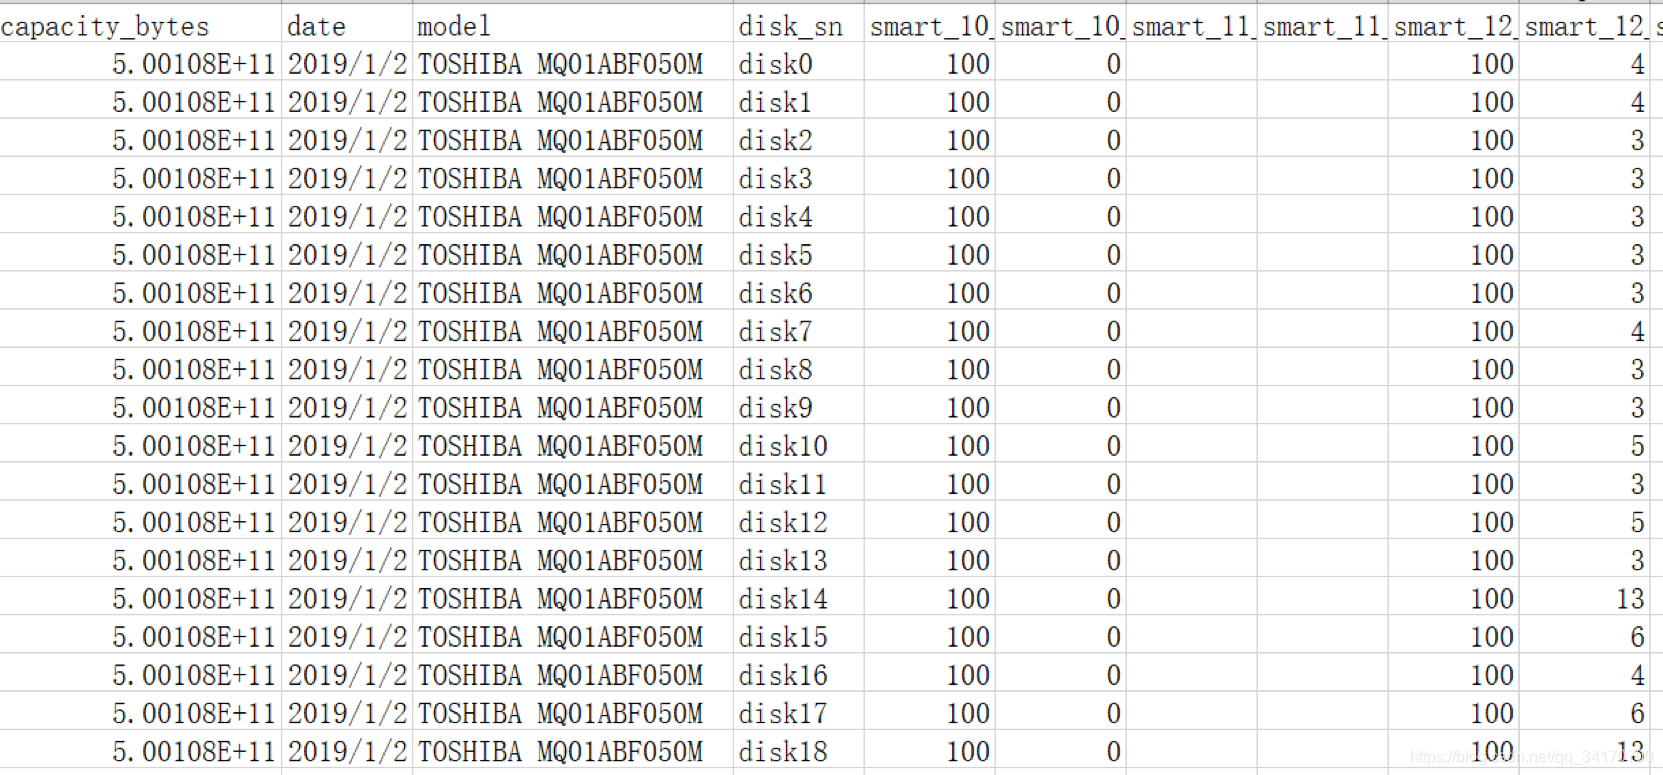
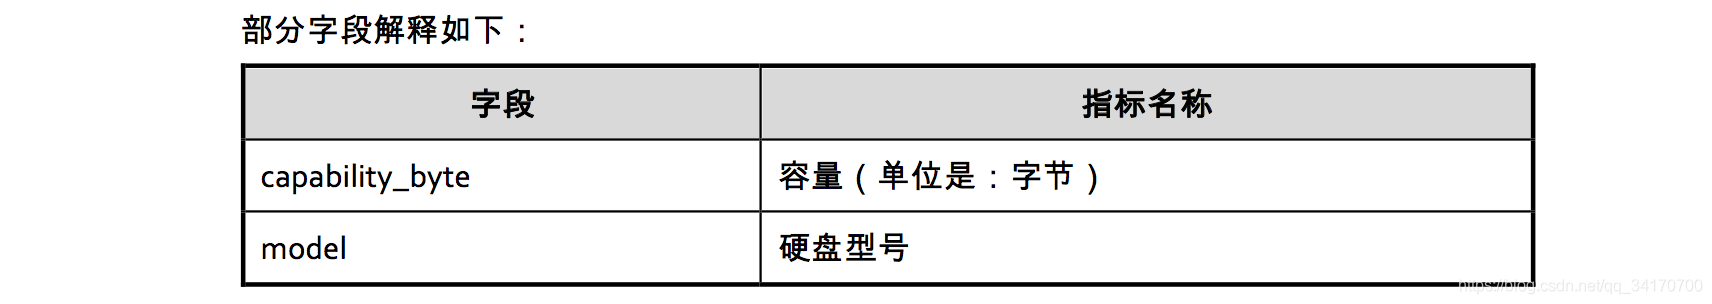
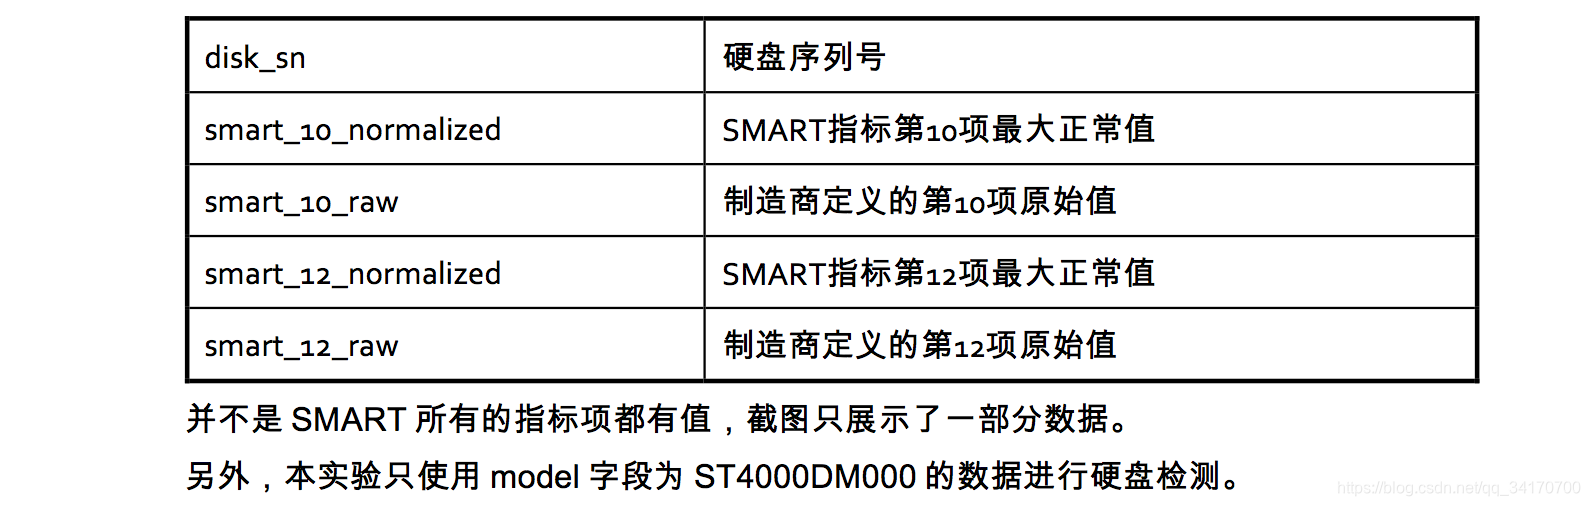
实验数据:
算法介绍

此方案的目标是检测哪些硬盘出现故障,哪个属于检测硬盘故障。从机器学习的角度来看,它属于分类算法。本实验使用lightGBM算法对硬盘进行分类和检测。 LightGBM(光梯度增强机)是基于决策树算法的分布式梯度增强框架。该算法快速有效。设计思路主要有两点:
1、减少数据对内存的使用,以确保一台机器在不牺牲速度的情况下使用尽可能多的数据;
2、降低了通信成本,提高了多台机器的并行效率,并在计算中实现了线性加速。可以看出,LightGBM的初衷是提供一种快速,高效,内存使用量少,准确性高,支持并行和数据处理的数据科学工具。
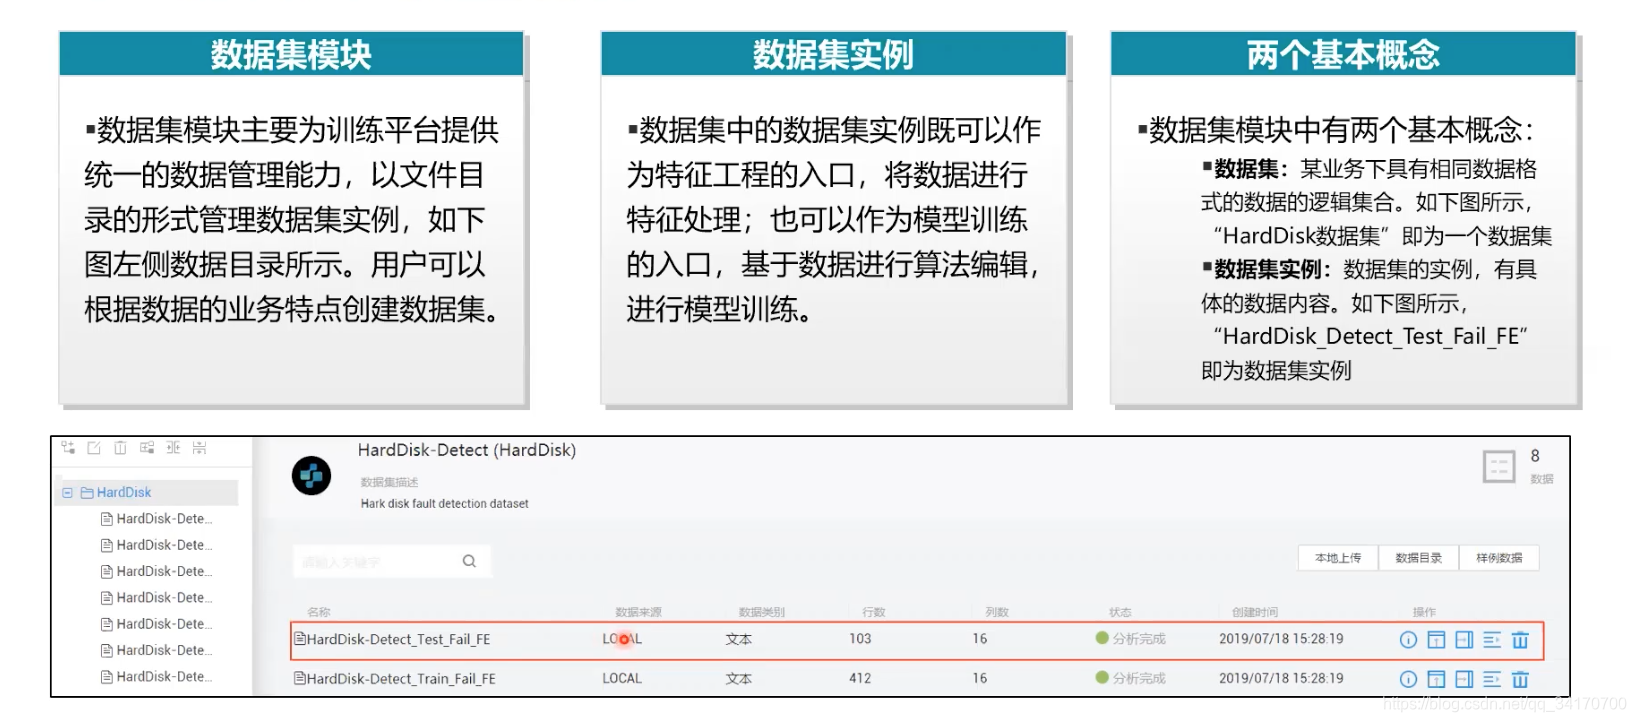
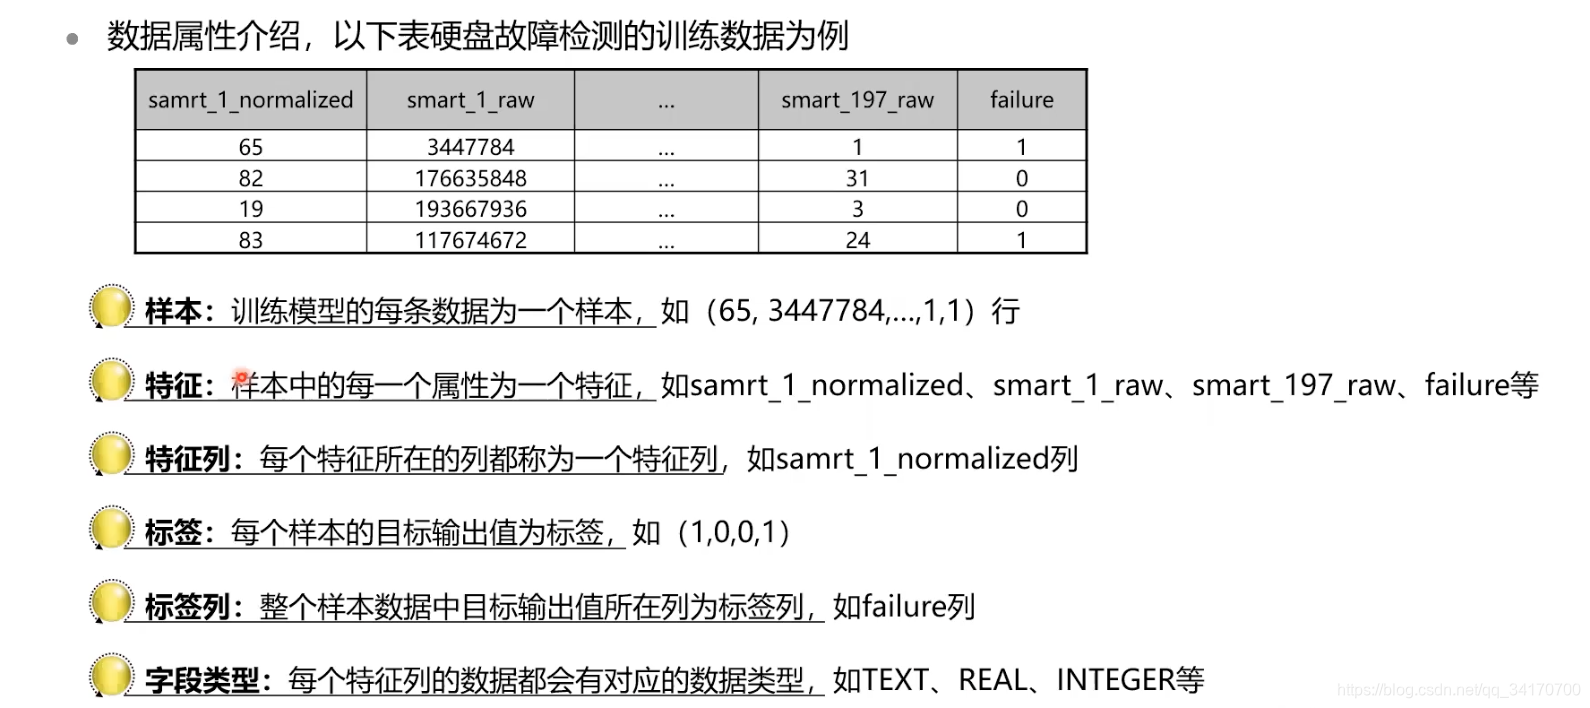
03数据集(数据管理)
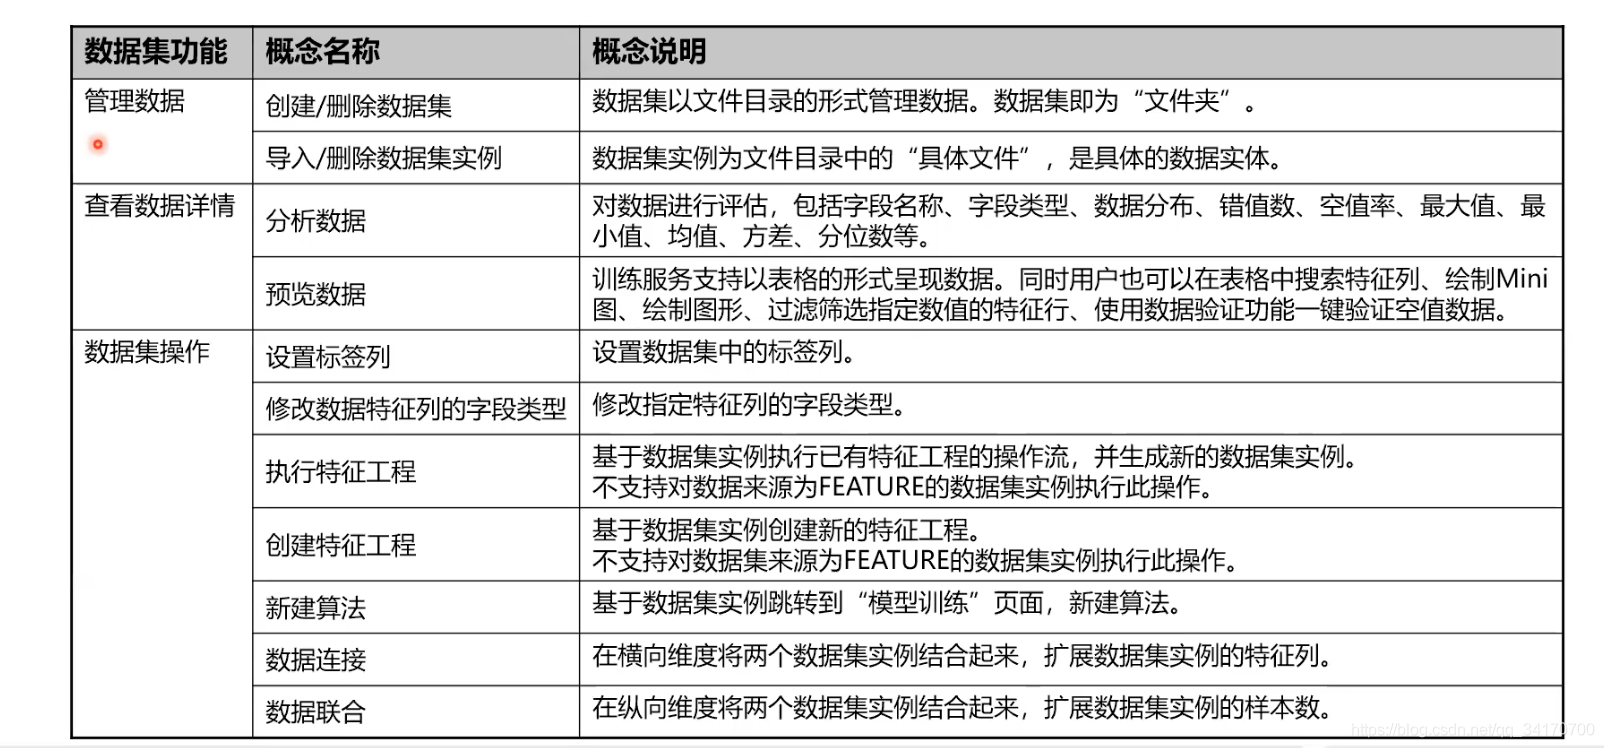

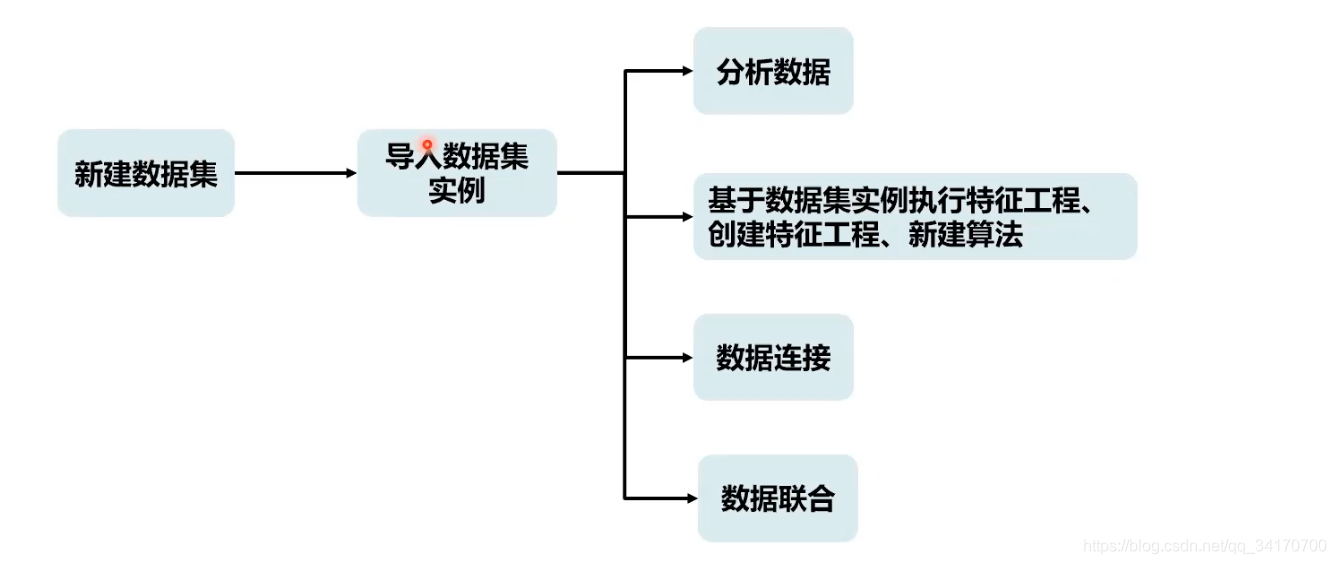
04特征工程(数据预处理)
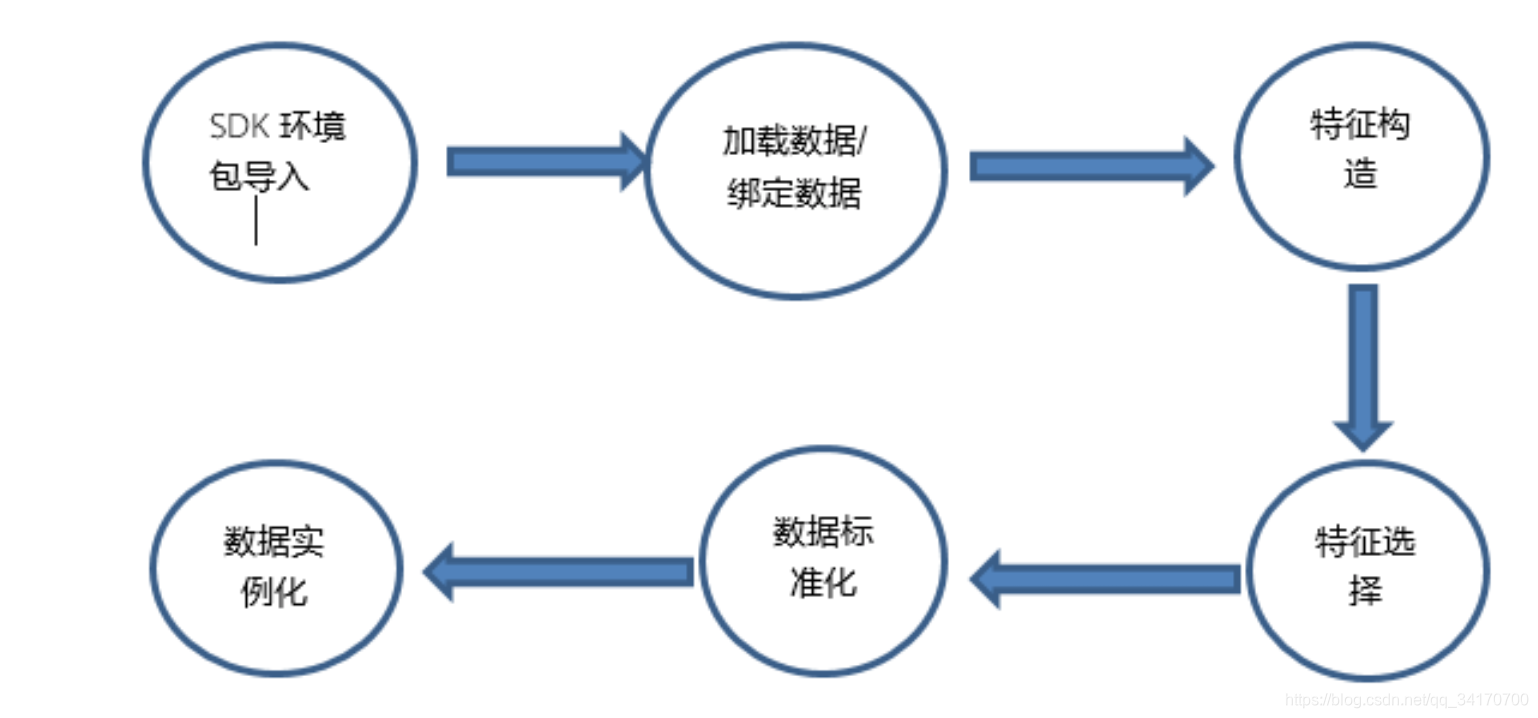
特征结构
import os
os.chdir("/home/ma-user/work/DISK-DETECT-handle")
from naie import _context as context
from naie.datasets import data_reference
from naie.feature_processing import data_flow
from naie.feature_analysis import data_analysis
from naie.feature_processing.expression import col, cols, cond, f_and, f_not, f_or
from naie.common.data.typedefinition import StepType, ColumnRelationship, JoinType, ColumnSelector,DynamicColumnsSelectorDetails, StaticColumnsSelectorDetails, ColumnsSelectorDetails, DataProcessMode
import pandas as pd
data = dataflow.to_pandas_dataframe()
# Your code here
#去掉列名
data = data.loc[1:]
data.sort_values([disk_sn], inplace=True)
# 只包含一个值的列,无用
cols_only_one_value = data.nunique().to_frame( name=num).query(num==1).index.tolist() # 保留的列
cols_keep = [i for i in data if i not in cols_only_one_value]
# 硬盘 smart 特征列
cols_smart = [i for i in cols_keep if i.startswith(smart)]
#特征选择
colums = cols_smart+[capacity_bytes,failure,disk_sn]
processed_data = data[colums]
dataflow = data_flow.create_dataflow_from_df(processed_data)
#@return {"type":"dataflow","attrs":{"source":"dataframe"}}
05模型训练
# -*- coding: utf-8 -*-
from __future__ import print_function
from sklearn.model_selection import cross_val_score, train_test_split
from sklearn.metrics import confusion_matrix, accuracy_score, roc_curve
from naie.metrics import report
from naie.datasets import get_data_reference
from naie.context import Context
import warnings
warnings.filterwarnings(ignore)
import pandas as pd
import numpy as np
import lightgbm as lgb
import os
import pickle
# naie sdk主要用于文件、路径、日志等操作,详见训练平台又上角问号处帮助中心内sdk文档说明
def load_dataset(dataset, dataset_entity):

    从数据集中加载数据为DataFrame

    data_reference = get_data_reference(
        dataset=dataset, dataset_entity=dataset_entity)
    df = data_reference.to_pandas_dataframe()
    return df
def model_fn():
    model = lgb.LGBMClassifier(random_state=1)
    return model
def train(x_train, y_train, model):
    model.fit(x_train, y_train, categorical_feature=cate_cols)
def save_model(model):
    """
    模型存储的固定路径,生成的pkl文件要与推理代码predict.py中的路径对应
    """
    model_path = os.path.join(Context.get_model_path(), model.pkl)
    with open(model_path, wb) as ff:
        pickle.dump(model, ff)
def save_features(features):
    """
    模型存储的固定路径,生成的pkl文件要与推理代码predict.py中的路径对应
    """
    features_path = os.path.join(Context.get_model_path(), features.pkl)
    with open(features_path, wb) as ff:
        pickle.dump(features, ff)
def score_model(x_validation, y_validation, model):
    """
    返回验证得分并通过logs保存在训练任务中
    """
    score = accuracy_score(y_validation, model.predict(x_validation))
    with report(True) as logs:
        logs.log_property("score", score)
    return score
def main():
    # dataset dataset_entity需要修改为项目数据集对应的参数
    data = load_dataset(dataset="DATASET", dataset_entity="processed_disk_data")

    features = data.columns.tolist()[:-2]

    #因为硬盘容量的数值较大,可以先转化成类别特征的数据
    data[capacity_bytes] = data[capacity_bytes].astype(category)
    # 按照硬盘划分训练集和测试集
    train_disks, test_disks = train_test_split(
        data[disk_sn].unique(), shuffle=True, random_state=2019, test_size=0.2)
    train_data = data[data[disk_sn].isin(train_disks)]
    test_data = data[data[disk_sn].isin(test_disks)]
   #创建模型
    model = lgb.LGBMClassifier(random_state=1,objective = binary,num_leaves = 64,n_estimators = 1000,is_unbalance=True)
    # 交叉验证
    cv_score = cross_val_score(
        model, train_data[features], train_data.failure, cv=5, scoring=accuracy, fit_params={categorical_feature: [capacity_bytes]})
    print(fCV accuracy score: {cv_score})
    model.fit(train_data[features], train_data.failure,categorical_feature=[capacity_bytes])  # lightgbm处理分类变量
    # 评分时是对每个盘进行预测,根据历史数据预测这个盘会不会坏
    test_y = test_data.groupby(disk_sn).failure.nth(-1)
    test_X = test_data.groupby(disk_sn).nth(-1)[features]
    print(test set confusion matrix:)
    conf_matrix=confusion_matrix(test_y, model.predict(test_X))
    print(conf_matrix)

    # 输出误报率FAR,即一块硬盘实际为好盘,而模型预测为坏盘的概率,业务目标 <= 0.1%
    print(fFAR : {conf_matrix[0][1]/sum(conf_matrix[0])})
    #输出查全率FDR,即一块硬盘实际为坏盘,而模型预测为坏盘的概率,业务目标 > 80%
    print(fFDR : {conf_matrix[1][1]/sum(conf_matrix[1])})
    score = score_model(test_X, test_y, model)
    print(ftest accuracy score: {score})
    #保留特征
    save_features(features)

    #保存模型
    save_model(model)
    # return the score for hyperparameter tuning
    return score
if __name__ == "__main__":
    main()
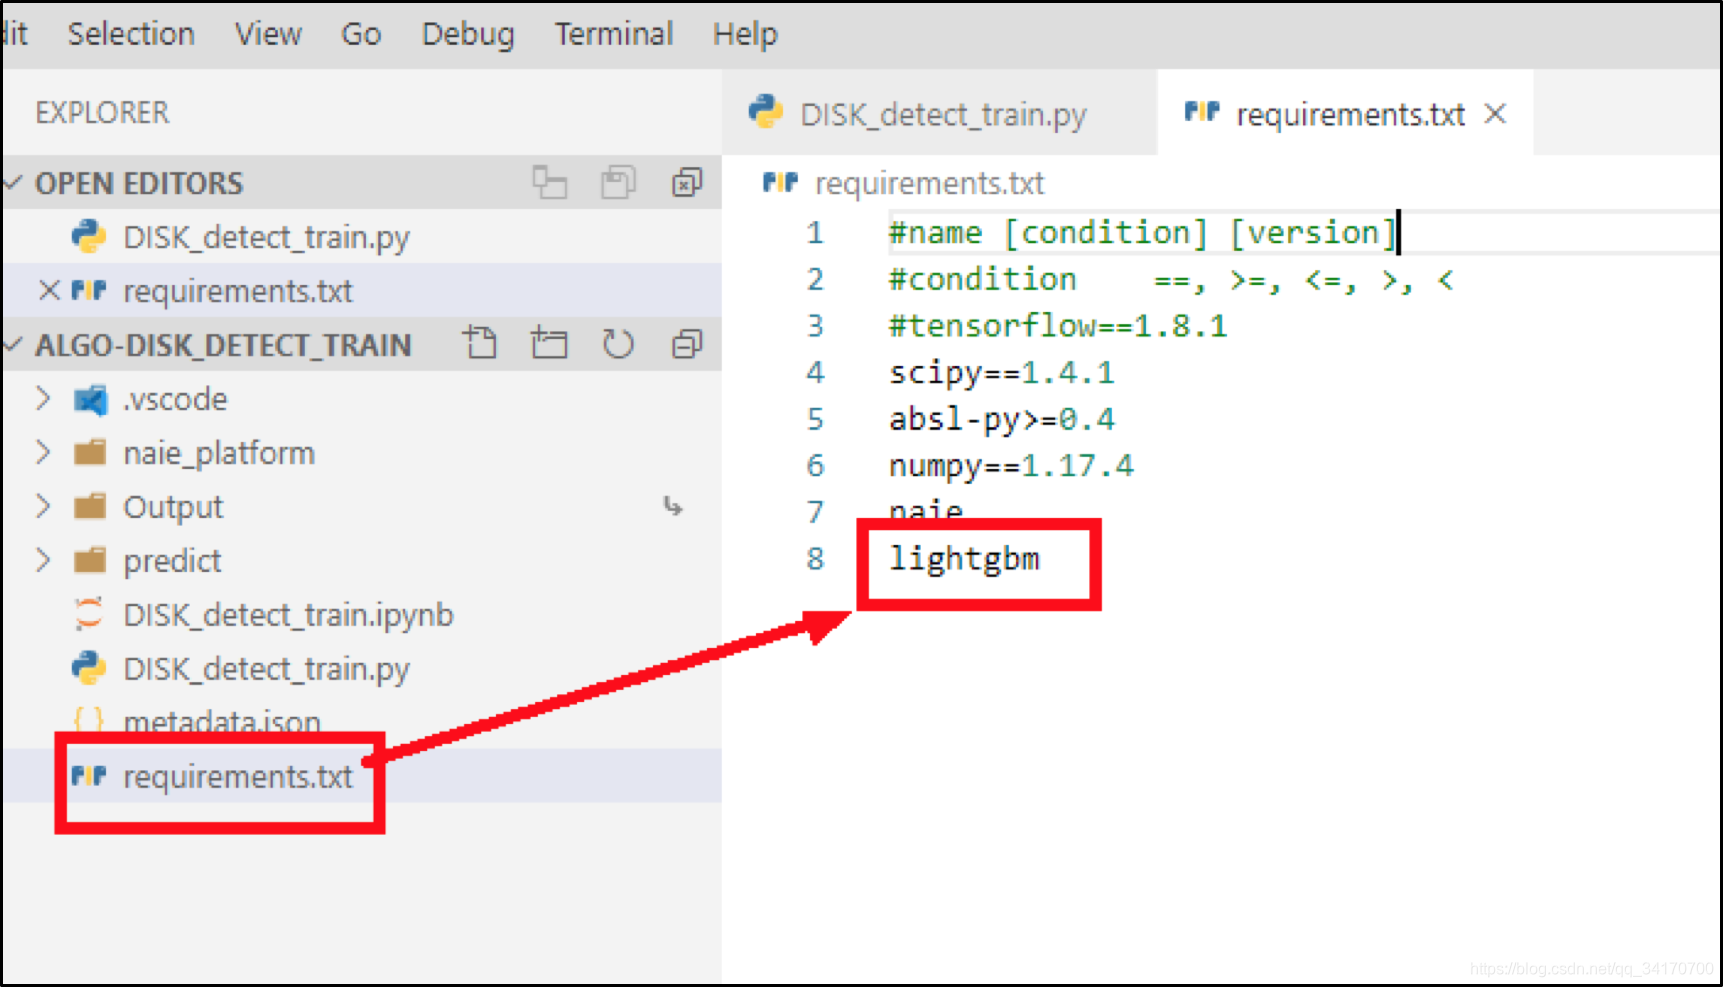
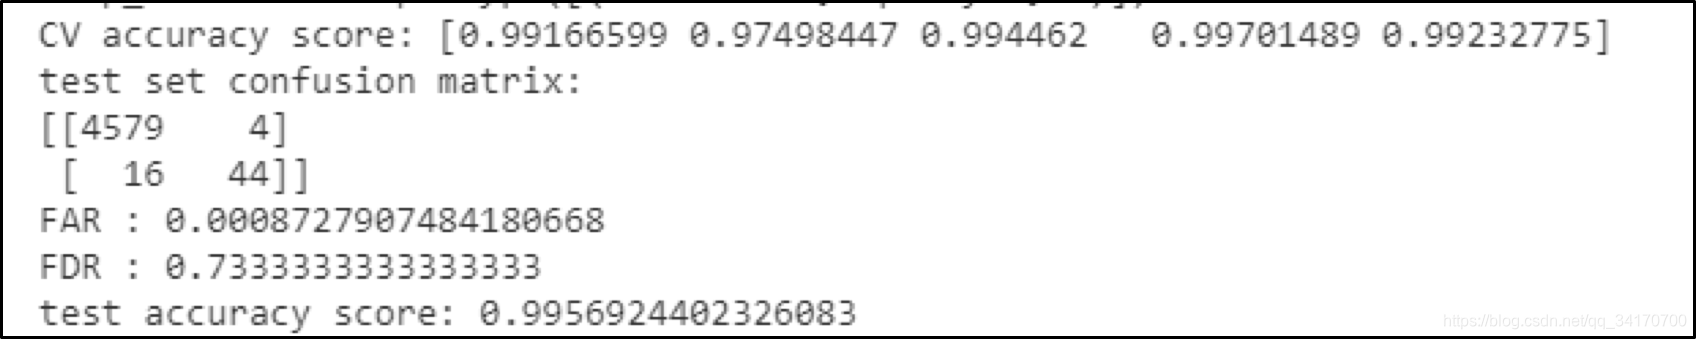
从输出结果中,FAR =0.087%
06模型管理
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/dianqi/article-319734-1.html
相关阅读
发表评论 请自觉遵守互联网相关的政策法规,严禁发布、暴力、反动的言论
-

-
徐欣欣
好好笑
-
 通用方法:开源磁盘分区工具GParted
 恒温游泳池系统,使用恒星热泵将加热效率提高500%
 联想T430安装具有msata接口的SSD固态驱动器
 超薄无边框+4K超高清,夏普新电视真的好?听听设计师怎么说
中国岛礁现在可以军事化了