raid5磁盘阵列真的不安全吗?
电脑杂谈 发布时间:2020-09-09 01:13:19 来源:网络整理
本文主要组织论坛内容。 (论坛地址:)
许遇到服务器RAID5崩溃。通常,放置一个磁盘后,第二个磁盘也会立即崩溃。
报价:RAID 5还使用数据的校验位来确保数据的安全性,但是它不会将数据的校验位存储在单独的硬盘上,而是交替存储数据段的校验位在每个硬盘上。这样,如果任何硬盘损坏,则可以基于其他硬盘上的奇偶校验位来重建损坏的数据。硬盘的利用率为n-1。如果挂了两个磁盘,数据就结束了。
从理论上讲,两个硬盘同时发生故障的可能性很小,但是为什么会这样呢?
报价:从数学角度来看,每个磁盘的平均故障间隔时间(MTBF)约为500,000至150万小时(即,硬盘损坏每50至150年发生一次)。实际上,这种理想情况常常无法实现。在大多数散热和机械条件下,硬盘的正常工作时间将大大减少。考虑到每个磁盘的寿命不同,阵列中的任何磁盘都可能有问题。从统计角度来看,阵列中N个磁盘的故障概率是单个磁盘故障的概率的N倍。结合以上因素,如果阵列中的磁盘数量合理,并且这些磁盘的平均故障间隔时间(MTBF)很短,则在磁盘阵列的预期寿命内,可能会发生磁盘故障(例如,则每个月或每隔几年就会发生一次故障。
两个磁盘同时被损坏的概率是多少(“同时”表示当另一个磁盘未完全修复时一个磁盘也被损坏)?如果RAID 5阵列的MTBF等于MTBF ^ 2,则发生的概率是每10 ^ 15小时(即,在超过10,000年中仅发生一次),因此无论工作条件如何,发生的可能性极低。从数学理论的角度来看,存在这种可能性,但是实际上我们不需要考虑这个问题。但是,有时会同时损坏两个磁盘。我们不能完全忽略这种可能性。实际上,两个磁盘同时损坏的原因与MTBF无关。
对于这种情况,我们必须首先引入一个普通百姓不经常碰到的概念:BER硬盘错误率,英文是BER(误码率),它是描述硬盘性能的非常重要的参数。衡量硬盘错误可靠性的参数。此参数表示您写入硬盘的数据在读取过程中遇到不可恢复的读取错误的可能性。从统计的角度来看,它也是相对罕见的。一般来说,它是指在读取了多少位之后发生的读取错误。
随着硬盘容量的增加,驱动器读取的数据的误读率将增加,而硬盘容量却猛增,并且误码率比率仍保持相对增加。 1TB驱动器需要更多读取整个驱动器。这是因为RAID重建期间发生错误的可能性大于300G驱动器。
出现此错误的可能性是多少?换句话说,在遇到1字节读取错误之前,我们要写入多少GB的数据?阅读本文:
/ docs / scsi-sata-reliability /
对于不同类型的硬盘(以前使用SCSI /光纤的企业级,服务器,数据中心级硬盘,商业级和民用级均为IDE;现在对应的是SAS / SATA;
他们的MRBF(平均故障间隔时间)已经接近,但是具有廉价BER的SATA硬盘驱动器的误码率(BER)远远高于昂贵的SCSI硬盘驱动器。
换句话说,当无法读取某个扇区时,SATA比SCSI严重得多。具体区别在于固件:遇到无法读取或写入的坏扇区时,家用硬盘将花费1分钟以上的时间来纠正错误。如果无法更正,它将被备用扇区替换。该时间超过了阵列控制器可以承受的极限,因此,遇到这种情况时,磁盘将被丢弃;企业级磁盘会将这项工作放在后台,而不会暂停约1分钟,以免影响阵列的运行。 BER硬盘的误码率没有差异。

根据文章中的计算,一个1TB硬盘通常有56%的概率无法读取所有扇区。因此,如果您使用便宜的大容量SATA磁盘,则在硬盘发生故障时重建RAID的希望是:无法实现。
如果将1TB SATA硬盘用于RAID5,则在遇到硬盘故障时,几乎其余两个硬盘(RAID5的最小组合为3)肯定会遇到硬盘读取错误和重建故障。
因此,在过去,当小硬盘使用RAID5时,很少会同时挂起两个磁盘。既然硬盘更大,出现问题的可能性就会增加。
对于运行RAID的用户,经常会读取整个硬盘。即使系统足够和谐,知道您报告从未读过的文件中出现的坏扇区是错误的,它也会跳过报告步骤:它将仍然找到所有坏扇区,其中56%会出现。还有所谓的企业级SATA用于监视。原理是对固件进行操作,以便即使硬盘遇到写入数据读取错误,它也将直接跳过而不管它们是三七十一,并且不再尝试读取(标准硬盘的读取方法是在遇到某个扇区CRC错误时自动重新读取,直到读取正确的数据为止)。对于监视数据,这是理所当然的事情(大多数受监视的硬盘一直在写入,但很少需要读取),除非出现问题并且需要复制图像。
如果现有Raid5阵列磁盘中存在未检测到的错误,则热备用无法解决它们。当某个磁盘处于脱机状态时,Hot Spare只能替换脱机磁盘以及时执行Raid重建。如果其他磁盘有错误,则重建可能仍然会失败。
解决方案是在阵列运行状况良好时执行常规或其他错误检查。插入到主板上集成的主板PCI / PCIX / PCIE /或RAID5中的通用硬件阵列卡完全没有数据清理功能。企业级数据存储只能在磁盘阵列级具有这种功能(例如IBM DS3000 / 4000/5000,DELL MD300 0. ...等),但看不到检查结果。如果您在日志中看到硬盘CRC失败,则红灯将熄灭,并且阵列柜将警告您更换硬盘。您是否不想知道硬盘是否已完全挂起,是否存在读取错误或坏扇区。 。 。简而言之,他的眼睛变黑了。 (ZFS上的RAIDZ具有数据巡检(清理)功能)
遇到RAID5时两个磁盘一次挂起的可能性的摘要
1、使用更大容量的RAID5硬盘,遇到BER扇区的可能性就越大;例如,将100G硬盘用于RAID5比使用1TB更安全;
2、将具有更多磁盘的硬盘用于RAID5,遇到BER扇区的可能性就越大;例如,具有3个磁盘的RAID5比具有6个磁盘的RAID5更安全;
3、硬盘用于RAID5的价格越便宜,遇到BER扇区的可能性就越大;例如,使用SCSI / FC / SAS磁盘比使用IDE / SATA RAID5更安全;
4、 RAID5中存储的数据越多,数据越满,遇到BER扇区的可能性就越大;例如,100G数据存储比RAID5存储1TB数据更安全; (仅在REBUID期间读取。对于已存储数据的扇区,某些卡必须读取整个磁盘,而不管它们是三七十一)
RAID1 / RAID10仅涉及一个磁盘的重建。与需要参与重建的所有raid5磁盘相比,故障概率降低了; RAID1不需要强制联机操作,因为一组磁盘发生故障,因为数据仍然存在并且不需要,因此也可以读取组RAID,即使将其更改为没有RAID卡的另一台计算机,仍可以读取数据如果RAID5无法强制第二个掉线的硬盘驱动器联机,则您将无法读取任何内容。
对于DB:突袭1 + 0最好! (不可缺少的备份;当RAID处理降级状态时,如果重要数据的容量不大,建议先进行备份。当然,这种备份应该是另一台机器,并且不能备份到当前降级的RAID。如果在REBUILD中,另一个硬盘脱机导致RAID卷处于离线状态,则不能重建RAID卷。例如,确认脱机硬盘后,可以通过强制将其联机来恢复数据。控制器没有选项,也没有办法)

本文来自博客“技术成就梦想”,请保留此资源/ 1511707/1006565
我认为本文有两件事是不正确的:
我最近看到了一篇讨论SATA和SCSI硬盘驱动器可靠性的文章。本文的结论是:两个硬盘驱动器的故障率(MTBF)非常接近,但是便宜的SATA硬盘驱动器的误码率(BER)远高于昂贵的SCSI硬盘驱动器。换句话说,当无法读取某个扇区时,SATA比SCSI严重得多。根据他的计算,对于1TB硬盘,您无法读取所有扇区的概率通常为56%。因此,如果硬盘出现故障,您希望重建RAID是无法实现的。
单击上方[4]的“本文”链接,摘录如下:
尽管型号之间存在差异,但与我们的老朋友相比,误码率却很高。误码率是由于无法从磁盘上的PRML和ECC代码恢复数据而无法从磁盘读取块的速率。整个驱动器不会发生故障,但是您无法读取该块。在RAID系统中,这会触发从其余驱动器重建该块。
正如我在视频“ RAID的麻烦”中描述的那样,误码率是当今RAID技术的最大问题。如果RAID 4或RAID 5组中的驱动器发生故障,则必须从头到尾完美读取每个剩余的驱动器,否则数据将丢失。对于7 + 1 TB的驱动器,这意味着必须读取7 TB。 10 ^ 14中的1位误码率意味着有44%的机会无法实现。
摘录翻译如下:
但是,不同型号之间的区别(注释:原始是指消费级硬盘和SCSI /光纤通道硬盘)是我们所知道的误码率。误码率是指由于无法通过PRML和ECC从磁盘恢复数据而无法从磁盘读取特定扇区的数据的概率。整个硬盘没有出现故障,但是用户无法读取该扇区中的数据。在RAID系统中,这触发了重建过程,该过程使用其他硬盘驱动器上的数据来恢复扇区数据。
就像视频中描述的“ RAID故障”一样,这种误码率是当今RAID技术面临的最大问题。如果RAID 4或RAID 5中的驱动器发生故障,则必须从头到尾“完全”读取每个剩余的硬盘驱动器,否则数据将丢失。使用7 + 1 1 TB容量的硬盘驱动器,这意味着必须读取7 TB。误码率为1/10 ^ 14表示将不可能(“完美”读取7TB数据)的可能性为44%。
注释:
[4]在各种硬盘制造商的数据表中,在[4]中提到的误码率通常称为“不可恢复的读错误率”和“不可恢复的读错误率”(URE,本文中使用此缩写),包括Internet上的Wiki,这是[1]中提到的“写入硬盘的数据在读取过程中会遇到不可恢复的读取错误的可能性”。
解释一下,此读取错误的原因可能是:

在硬盘中,这种错误实际上经常发生,但是一般来讲,每个扇区也可能有1〜3位数据。因此,机械硬盘在每个扇区后面都有几个ECC纠错码(早期的512B扇区硬盘为每个扇区50Byte,而当前的4K扇区硬盘为每个扇区100Byte [5]),可用于纠正此类错误。 。但是,ECC并非万能药。如果在读取某个扇区的数据时有太多位错误,则ECC无法执行任何操作。此时,将发生“不可恢复的读取错误(即,先前定义中的不可恢复的读取错误)”。向上。根据硬盘制造商提供的参数,发生这种情况的可能性(即URE,消费者级硬盘通常为1e-14,而企业硬盘URE的可能性通常为1e-15。
[4]没有给出具体的计算公式来计算基于URE的RAID5重建的成功概率,这里有一些补充。如果某个硬盘的URE为1e-14 / bit(可以在各种硬盘制造商的DataSheet中找到),这并不意味着每次读取1e + 14 bit时URE都必须出现。也可以使用二项分布公式计算得出URE在1e14bit中发生的概率:
但是,对于1e14试用,Excel的1e-14概率还不够。您可以使用Python的scipy库进行计算:
>>> from scipy.stats import binom
>>> binom.pmf(0, 1e14, 1e-14)
0.36787944117144045
>>> binom.pmf(1, 1e14, 1e-14)
0.2904884966524753
>>> binom.pmf(2, 1e14, 1e-14)
0.22937831594696387
>>> binom.pmf(3, 1e14, 1e-14)
0.04041420666321343
>>> binom.pmf(4, 1e14, 1e-14)
我们只关心URE不发生的可能性,为0倍。因此,二项式分布的概率质量函数可以简化如下:
对于由4个1TB硬盘组成的RAID 5,单个磁盘故障后在重建过程中需要读取的数据量为1e12字节×8位/字节×(4- 1) = 24Tbit,而读取24Tbit不会发生URE的概率为(1-1e1 4) ^ 24e12 = 7 8. 68%。Excel可以轻松计算重建RAID5的过程,具有不同的误码率和不同的硬盘容量,构成4/8 RAID 5重建成功/失败的概率如下表所示(PS:由Excel使用简化公式计算并由scipy直接计算的结果会略有不同,但可以忽略)。
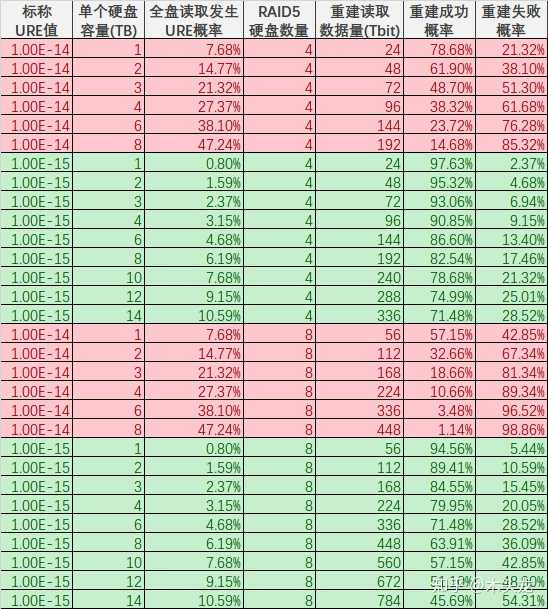
在表中,为1e-14构建的8 URE RAID 5的成功概率为5 7. 15%,接近[4]中提到的44%失败。因此,[1]中提到的56%是由于在重建过程中发生URE而导致重建失败的概率。但是,如果完全读取单个1TB硬盘,则URE的概率应为7. 68%。
进一步观察估计结果,实际上,如果完全读取单个硬盘,则URE在8TB容量中出现的可能性接近50%。因此,当前超过8TB(包括8TB)的硬盘驱动器,甚至是消费级硬盘,都是1e-15 URE,至少Seagate的最新产品线就是这样。但是,企业级Exos 5E8仅具有8TB模型,而标称URE参数为1e-14。
从上表中可以看到,由4个1TB硬盘和URE 1e-14组成的RAID 5重建失败的概率为2 1. 32%,这实际上是很高的; 8个带有URE 1e-14 RAID5的硬盘驱动器,如果是,则1〜2TB也可以打脸,3〜4TB被称为死亡,6〜8TB被认为是不可能的。
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/dianqi/article-316896-1.html
-

-
胡金磊
你知道美国派多少
-
曹丽丹
不腻么
 PQMagic完全使用教程中国类型:拆分分区(一)
 滚筒洗衣机的优缺点有哪些
 海尔双动力洗衣机如何拆卸和清洁-海尔洗衣机清洁
 地源热泵办公楼地源热泵北京爱弗莱
第二我们应该加快自己在南沙的岛礁建设