硬盘读写原理的详细说明(2)
电脑杂谈 发布时间:2020-09-05 02:05:36 来源:网络整理我们创建了一个新文件,当然,我们的文件系统已经更改,现在是
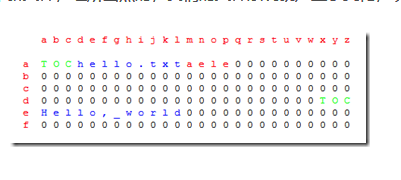
如图所示:“目录”(TOC)占据前四行,并且TOC存储系统中每个文件的位置。
在上图中,目录包含一个名为hello.txt的文件,其具体内容为“ Hello,world”,并且在系统中的位置是从ae到le。
下一步创建一个新文件
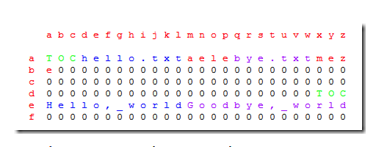
如图所示,我们新创建的文件bye.txt在第一个文件hello.txt旁边。
实际上,这是最理想的系统结构。如果您如上图所示将所有文件并排放置,那么它们将非常容易阅读。快速,这是因为硬盘中最慢的(相对而言)移动臂是传输臂。位移更少,读取文件数据的时间将更快。

但这正是问题所在。现在,我想在“ Hello,World”之后添加一些感叹号,以表达我的强烈感受。现在的问题是:在这样的系统上,我没有位置将这些感叹号放在文件所在的行上,因为bye.txt占用了其余位置。
现在有两种方法可供选择,但都不是完美的
1.我们从原始位置删除文件,重新创建一个文件并写上“ Hello,World !!”。-这无意中延长了文件系统的读写时间。
2.破坏文件就是在另一个空的地方写一个感叹号,即“身体的头部不同”,这是一个好主意,既快速又方便,但这也意味着很多这样会减慢读取下一个新文件的时间。
如果您不知道上面的文字,那么上面的图片
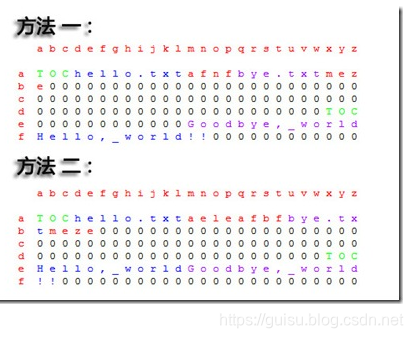
这里提到的第二种方法类似于Windows系统的存储方法,每个文件彼此相邻,但是如果要更改其中一个文件,则意味着下一个数据将被保存在另一个文件中。磁盘的备用位置。
如果删除此文件,它将在系统中保留空格。随着时间的流逝,我们的文件系统将变得碎片化,并且碎片会这样生成。
尝试简单一点,简化了硬盘读写mm的原理
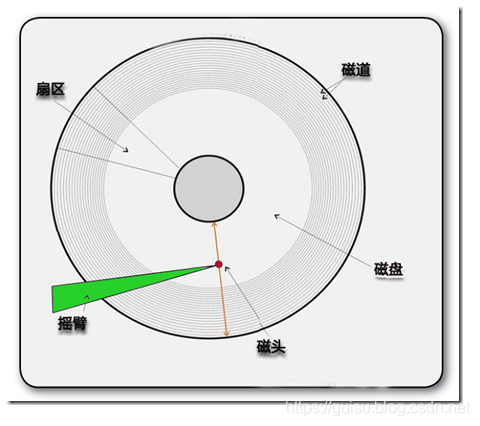
关于硬盘的结构,我不会说太多。我们通常的计算机数据存储在磁道上,该磁道与光盘大致相同。读取是通过磁头完成的。
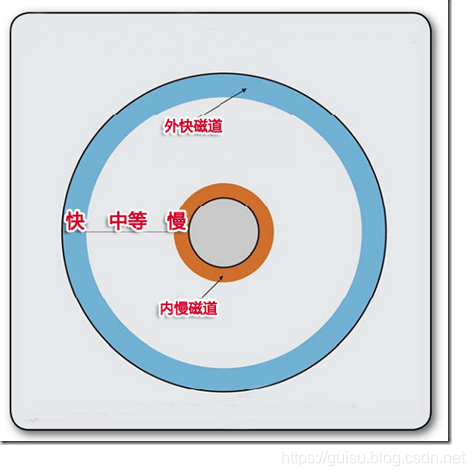
我们都知道我们的数据是以信息的形式存储在磁盘扇区的磁道上的。摇杆控制头从磁盘的外部到内部读取和写入硬盘。因此,外部数据的读取速度将比内部数据快得多。
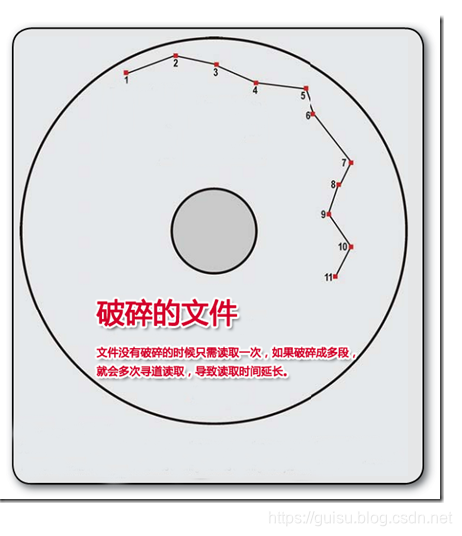
事实上,我们的文件大多数时候都被破坏了。当文件没有损坏时,摇杆只需要查找一次轨道,并通过磁头读取它。成功阅读仅需1次;但是如果将文件分成11个位置,则摇杆需要找到11次以读取磁头11次才能完全读取该文件。当阅读时间相对不间断时,它会变得很长。
因此,磁盘碎片通常是减慢系统速度的重要因素之一。 Vista Home团队还计划在后续版本的Vista Optimizer中添加磁盘碎片整理,敬请期待。
7、硬盘容量和分区大小计算
在linux系统中,要计算硬盘容量和分区大小,我们首先通过fdsik -l检查硬盘信息:
磁盘/ dev / hda:8 0. 0 GB,80026361856字节
255个磁头,63个扇区/磁道,9729个圆柱体
单位=柱面数16065 * 512 = 8225280字节
设备启动开始,结束块ID系统
/ dev / hda1 * 1 765 6144831 7 HPFS / NTFS
/ dev / hda2 766 2805 16386300 c W95 FAT32(LBA)
/ dev / hda3 2806 9729 55617030 5扩展
/ dev / hda5 2806 3825 8193118+ 83 linux
/ dev / hda6 3826 5 83 Linux
/ dev / hda7 553+ 82 linux swap / Solaris

/ dev / hda8 59386 83 linux
/ dev / hda9 6658 7751 8787523+ 83 linux
/ dev / hda10 7752 9729 15888253+ 83 linux
其中
heads是磁盘表面;
部门是部门;
气缸是气缸;
每个扇区的大小为512byte,即0. 5K;
通过上面的示例,我们发现该硬盘具有255个磁盘表面,63个扇区和9729个柱面;因此整个硬盘的体积换算公式应为:
磁性表面的数量*扇区的数量*每个扇区的大小512 *柱面数=硬盘容量(以字节为单位)
因此,在此示例中,磁盘的大小应按以下方式计算:
255 x 63 x 512 x 9729 = 80023749120字节
提醒:由于硬盘制造商和操作系统的转换不相同,因此硬盘制造商使用十进制方法进行转换,而操作系统使用二进制系统进行转换,因此当转换为M或G时,会有所不同算法结果是不同的;因此我们的硬盘有时标记为80G,但在操作系统下,它小于几M;
在上面的示例中,比较了硬盘制造商的算法和操作系统:
硬盘制造商:80023749120字节= 8002374 9. 120 K = 8002 3. 749120 M(转换为更大的单位,每次除以100 0)
操作系统:80023749120字节= 7814819 2. 5 K = 7631 6. 594238281 M(转换为更大的单位,每次除以102 4)
当我们检查分区大小时,我们可以使用制造商提供的算法来简单地计算分区大小;将小数点向前移动六位是用G表示的大小;例如,hda1的大小约为6. 144831G;
磁盘阵列
磁盘阵列由许多独立的磁盘组成,组合成一个大容量磁盘组,利用单个磁盘的额外效果来提供数据,以增强整个磁盘系统的性能。使用这项技术,数据可以分为许多部分,并分别存储在每个硬盘上。
独立磁盘冗余阵列(RAID,独立磁盘冗余阵列)是一种将相同数据存储在不同位置的多个硬盘上的方法(因此,是冗余的)。通过将数据放置在多个硬盘驱动器上,输入和输出操作可以平衡地重叠,从而提高了性能。由于多个硬盘驱动器会增加平均故障间隔时间(MTBF),因此存储冗余数据也会提高容错能力。
RAID技术主要具有以下三个基本功能:
(1)通过剥离磁盘上的数据,可以按块访问数据,这减少了磁盘的机械查找时间,并提高了数据访问速度。
(2)通过同时读取阵列中的多个磁盘,减少了磁盘的机械查找时间,并提高了数据访问速度。
(3)通过镜像或存储奇偶校验信息来实现数据冗余保护。
优势
1)提高传输速率。 RAID通过同时在多个磁盘上存储和读取数据,极大地提高了存储系统的数据吞吐量(吞吐量)。在RAID中,许多磁盘驱动器可以同时传输数据,并且这些磁盘驱动器在逻辑上是一个磁盘驱动器,因此RAID的使用可以达到单个磁盘驱动器的速度的几倍,数十倍甚至数百倍。这也是RAID最初要解决的问题。由于当时CPU的速度在迅速增加,并且磁盘驱动器的数据传输速率无法大大提高,因此需要一种解决方案来解决两者之间的矛盾。 RAID终于成功了。
2)通过数据验证提供容错能力。如果普通磁盘驱动器不包含写在磁盘上的CRC(循环冗余校验)代码,则不能提供容错功能。 RAID容错功能建立在每个磁盘驱动器的硬件容错能力之上,因此可以提供更高的安全性。在许多RAID模式下,都有相对完善的相互验证/恢复措施,甚至直接相互镜像备份,这大大提高了RAID系统的容错能力,并提高了系统的稳定性和冗余性。
缺点
RAID0没有冗余功能。如果磁盘(物理)损坏,则无法使用所有数据。
RAID1磁盘的最大利用率只能达到50%(使用两个磁盘时),这是所有RAID级别中最低的。
RAID0 + 1可以理解为RAID 0和RAID 1之间的折衷方案。RAID 0 + 1可以为系统提供数据安全性,但是保护级别低于Mirror级别,并且磁盘空间利用率高于RAID 0 + 1。镜子的。
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/dianqi/article-314083-2.html
-
 阎锡山
-
熊珍
1依然没有躲过淘汰的命运
-
袁焕杰
今早起來又能聯網了不知這是要鬧哪樣
 魔改固态硬盘到底表现如何?兼容性怎么样?
 湖北黄石驾驶扫地机全封闭驾驶扫地车
 华硕x402c怎么设置无线网
 日立中央空调怎么样?