优酷下载的视频不能看_优酷看视频_优酷看视频没有声音
电脑杂谈 发布时间:2019-09-25 00:04:00 来源:网络整理
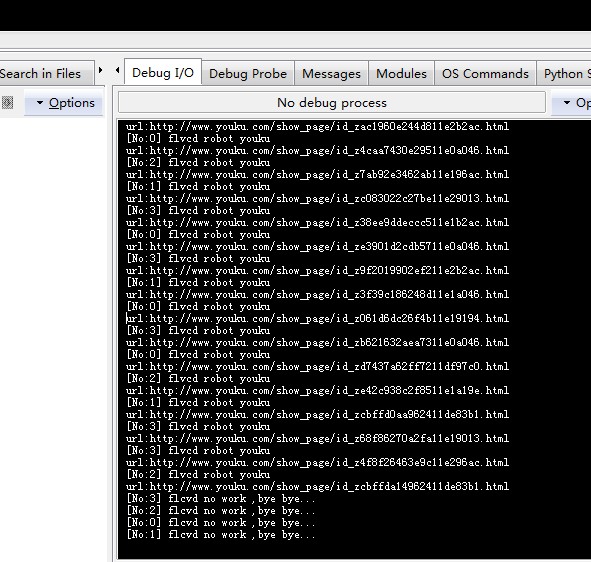
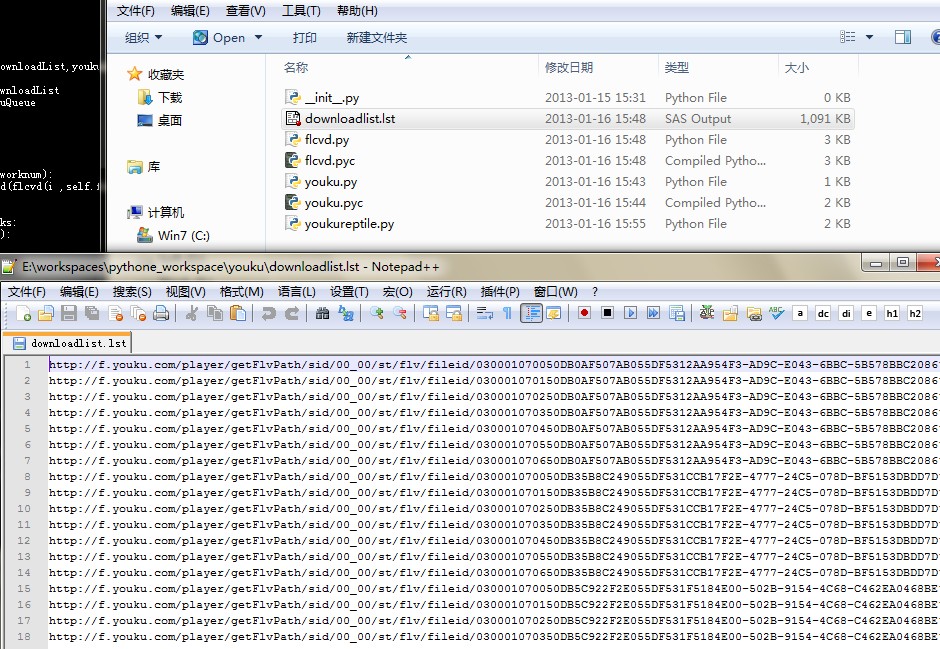
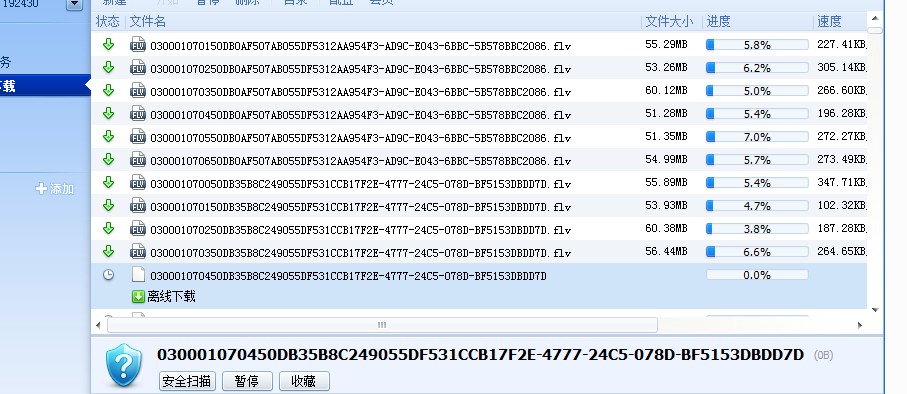
之前一直使用flcvd下载优酷视频优酷下载的视频不能看,这周看到同学讲的爬虫。手痒痒了。于是折腾了下!从优酷页面爬取视频页面优酷下载的视频不能看,访问flcvd 抓取下载地址,生成迅雷下载列表。
通过爬虫对正则有更深入的理解。尤其是在优酷分2种:
'http://v\.youku\.com这个为视频播放页面。例如《楚汉传奇 第40集》。单集下载抓取
'http://www\.youku\.com/show_page 为剧集页面。例如: 《楚汉传奇》,可以批量抓取剧集的下载地址哦!
欢迎各位指正,有什么好的建议请指出!
#coding="utf-8"
import re
import urllib2
import threading
import Queue
class youku(threading.Thread):
def __init__(self,baseUrl,youkuQueue):
threading.Thread.__init__(self)
self.baseUrl=baseUrl if self.hasHttp().match(baseUrl) else 'http://'+baseUrl
self.youkuQueue=youkuQueue
self.vshow=self.youku_v_show()
self.showpage=self.youku_show_page()
self.start()
def hasHttp(self):
return re.compile("^")
def youku_v_show(self):
return re.compile(r'http://v\.youku\.com/v_show/id_.+\.html')
def youku_show_page(self):
return re.compile(r'http://www\.youku\.com/show_page/id_.+\.html')
def parseUrl(self):
req=urllib2.urlopen(self.baseUrl)
contet=req.read()
if self.vshow.match(self.baseUrl):
return set(self.vshow.findall(contet))
else:
return set(self.showpage.findall(contet))
def run(self):

print "start parse Youku "
matches=self.parseUrl()
print matches
for matche in matches:
print 'matches:%s'%matche
self.youkuQueue.put(matche)
"""
if __name__=='__main__':
Base_Url="http://www.youku.com/show_page/id_z70902150919c11e0a046.html"
#Base_Url="http://tv.youku.com/search/"
#Base_Url="http://v.youku.com/v_show/id_XNDkyODUyMTQ0.html"
#Base_Url="http://www.baidu.com"
youkuQueue=Queue.Queue()
youku=youku(Base_Url,youkuQueue)
"""
复制代码
#coding="utf-8"
import re
import urllib
import urllib2
import threading
import Queue
class flcvd(threading.Thread):
Bae_Url="http://www.flvcd.com/parse.php?"
def __init__(self,worknum,form,downloadList,youkuQueue):
threading.Thread.__init__(self)
#self.url=youkuUrl
self.showpage=self.hidentFileUrl()
self.vshow=self.youku_v_show()
self.herfshow=self.herfFileUrl()
self.form=form
self.downloadList=downloadList

self.youkuQueue=youkuQueue
self.worknum=worknum
self.start()
def hidentFileUrl(self):
return re.compile('(+\s?)')
def herfFileUrl(self):
return re.compile(r'<a href=\"([^\"]+)')
def youku_v_show(self):
return re.compile(r'http://v\.youku\.com/v_show/id_.+\.html')
def headers(self,url):
heads={
'Host':'www.flvcd.com',
'Referer':url,
'User-Agent':'Mozilla/5.0 (Windows NT 6.1) AppleWebKit/537.11 (KHTML, like Gecko) Chrome/23.0.1271.97 '
}
return heads
def compileUrl(self,youkuUrl):
params={'kw':youkuUrl}
encode=urllib.urlencode(params)
form="&format=%s"%(self.form if self.formelse '')
realUrl="%s%s%s"%(self.Bae_Url,encode,form)
return realUrl
def parseUrl(self,youkuUrl):
targetUrl=self.compileUrl(youkuUrl)
req=urllib2.Request(
url =targetUrl,
headers = self.headers(targetUrl)
)
resp=urllib2.urlopen(req)
content=resp.read()
if self.vshow.match(youkuUrl):
return self.herfshow.findall(content)

else:
return self.showpage.findall(content)
def run(self):
while True:
youkuUrl=self.youkuQueue.get()
print '[No:%d] flvcd robot youku url>>%s'%(self.worknum,youkuUrl)
matches=self.parseUrl(youkuUrl)
#print matches
for item in matches:
#print item
self.downloadList.append(item.rstrip())
if self.youkuQueue.empty():
print '[No:%d] flcvd no work ,bye bye...'%self.worknum
break
""" """
if __name__=='__main__':
youkuQueue=Queue.Queue()
youkuQueue.put('http://v.youku.com/v_show/id_XNDkzNTk2NDQw.html')
#youkuQueue.put('http://www.youku.com/show_page/id_z70902150919c11e0a046.html')
downloadList=[]
flcvd=flcvd(1,'super',downloadList,youkuQueue)
复制代码
#coding="utf-8"
import re
import urllib2
from youku import youku
from flcvd import flcvd
from Queue import Queue
class theadpool:
def __init__(self,form,downloadList,youkuQueue,worknum):
self.form=form
self.downloadList=downloadList

self.youkuQueue=youkuQueue
self.works=[]
self.worknum=worknum
self.initflcvd()
def initflcvd(self):
for i in range(self.worknum):
self.works.append(flcvd(i ,self.form,self.downloadList,self.youkuQueue))
def finish(self):
for work in self.works:
if work.isAlive():
work.join()
def thunder(downloadList):
thunderListFile=open('downloadlist.lst','w+')
downloadList=set(downloadList)
for download in downloadList:
thunderListFile.write('%s\n'%download);
thunderListFile.close()
if __name__=='__main__':
downloadList=[]
youkuQueue=Queue()
worknum=4
Base_Url="http://v.youku.com/v_show/id_XNDkyODUyMTQ0.html"
#Base_Url="http://www.youku.com/show_page/id_z70902150919c11e0a046.html"
youku(Base_Url,youkuQueue)
theadpools=theadpool('super',downloadList,youkuQueue,worknum)
theadpools.finish()
thunder(downloadList)
复制代码
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/bofangqi/article-124040-1.html
-

-
钱安安
莫名泪点
-
蔡铭飞
加油
 听我的建议,这款小米鼠标真的不值得购买
 优酷怎么看不了过去的2017年,视频行业保持了令人震惊的增长
 优酷视频比较 2017年12月19日优酷vip账号免费领取 优酷会员账号共
 青清草免费视频app
把叙利亚难民危机与光棍危机进行对冲